
Контейнеризация и архитектура Docker
В теме 2 были рассмотрены два способа разделить один сервер между нагрузками: виртуальная машина с собственным ядром под управлением гипервизора и механизмы ядра Linux — пространства имён и группы управления ресурсами, — которые изолируют процессы без второго ядра. Механизмы ядра оказались лёгкими, но сами по себе неудобными: чтобы вручную собрать из unshare, mount и записей в /sys/fs/cgroup изолированную среду для веб-сервера, нужно знать десятки деталей, а получившуюся среду нельзя передать коллеге или перенести на другой сервер.
Контейнеризация решает именно эту задачу. Она добавляет к механизмам изоляции формат упаковки — образ, содержащий файловую систему приложения со всеми зависимостями, — и программу, которая по одной команде создаёт из образа изолированный процесс с заданными ограничениями. Docker сделал эту модель массовой, а стандарты Open Container Initiative (OCI) отделили её от конкретного продукта.
Изложение построено так. Сначала контейнер сопоставляется с виртуальной машиной, затем вводятся понятия образа и контейнера. После этого рассматривается, какими пространствами имён и cgroups Docker изолирует контейнер и как это наблюдать с хоста, как устроена слоистая файловая система, из каких компонентов состоит Docker Engine (от клиента до runc) и почему на macOS и Windows контейнеры работают внутри Linux-ВМ. Завершает тему жизненный цикл контейнера. Сборка образов из Dockerfile рассматривается в теме 4, параметры запуска и обработка сигналов — в теме 5, сеть контейнеров — в теме 6.
Контейнер как модель изоляции процессов
Контейнеризация решает практическую задачу: запускать приложения изолированно и воспроизводимо, не создавая для каждого приложения отдельную виртуальную машину. В отличие от VM, контейнер не содержит собственного ядра операционной системы. Контейнер — это набор процессов, которые выполняются на ядре хоста, но «видят» ограниченную картину системы: свои процессы, свою файловую систему, свои сетевые интерфейсы и свои квоты ресурсов. Эта изоляция достигается механизмами ядра Linux, а Docker предоставляет удобную модель упаковки и запуска.
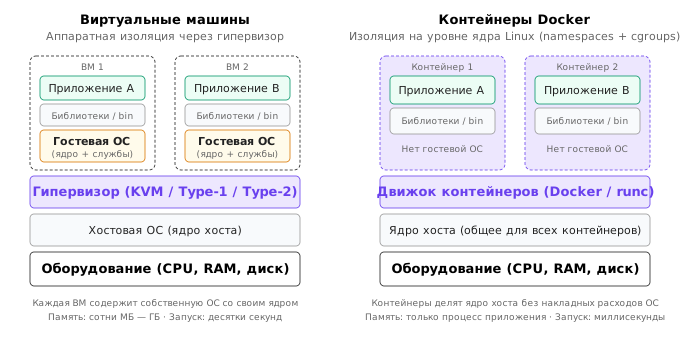
Ключевое отличие контейнера от виртуальной машины проявляется на уровне ядра операционной системы. Виртуальная машина запускает полноценную гостевую ОС поверх гипервизора и требует выделения ресурсов на её обслуживание. Контейнер же разделяет ядро хоста с другими контейнерами, что существенно сокращает время запуска — с минут до секунд — и снижает накладные расходы на оперативную память и дисковое пространство.
Практический смысл контейнеризации раскрывается на всех этапах жизненного цикла приложения. На этапе разработки контейнер позволяет воспроизвести окружение, идентичное целевому, и устранить расхождения между рабочими станциями участников команды. На этапе тестирования контейнеры обеспечивают быстрое создание и уничтожение изолированных сред, необходимых для проверки различных конфигураций. На этапе эксплуатации контейнеризация упрощает развёртывание и обновление приложений, поскольку образ контейнера является единым переносимым артефактом, содержащим приложение и все его зависимости.
Сопоставление с виртуализацией
Контейнеризация и виртуализация решают общую задачу — изоляцию вычислительных сред — но принципиально различаются уровнем, на котором эта изоляция реализуется. Понимание этих различий необходимо для обоснованного выбора подхода при проектировании инфраструктуры.
Виртуальная машина представляет собой полноценную вычислительную среду с собственной операционной системой. Гипервизор обеспечивает аппаратную изоляцию: гостевая система не имеет прямого доступа к ресурсам хоста или других виртуальных машин. Границы изоляции проходят на уровне виртуального оборудования, что обеспечивает высокую степень безопасности. Даже если гостевая операционная система подвергнется компрометации, злоумышленнику потребуется преодолеть дополнительный барьер в виде гипервизора, чтобы получить доступ к хостовой системе.
Контейнер не содержит собственной операционной системы и не требует гипервизора. Изоляция обеспечивается средствами ядра хостовой системы — пространствами имён и группами управления ресурсами, рассмотренными в предыдущей теме. С точки зрения хостовой системы контейнер представляет собой процесс (или группу процессов) в ограниченном окружении. Это даёт ряд практических преимуществ: минимальные накладные расходы (нет необходимости загружать дополнительную операционную систему), быстрый запуск (секунды вместо минут) и компактность артефакта (контейнерный образ содержит только приложение и его зависимости).
Вместе с тем изоляция средствами ядра менее строга, чем аппаратная изоляция гипервизора. Уязвимость в ядре хостовой системы потенциально затрагивает все контейнеры, работающие на этом хосте. Поэтому в сценариях с повышенными требованиями к безопасности — например, при многоарендном размещении ненадёжного кода — виртуальные машины остаются предпочтительным решением.
Сценарии предпочтительного использования
Виртуальные машины предпочтительны, когда требуется запуск различных операционных систем на одном физическом сервере, когда предъявляются повышенные требования к изоляции и безопасности, а также когда приложение зависит от специфической конфигурации ядра, которая не может быть воспроизведена в контейнерной среде.
Контейнеры предпочтительны в сценариях, где критичны скорость развёртывания, плотность размещения и эффективность использования ресурсов: микросервисная архитектура, непрерывная интеграция и поставка, масштабирование веб-приложений.
На практике виртуализация и контейнеризация часто применяются совместно. Типичная архитектура облачной платформы предполагает, что контейнеры исполняются внутри виртуальных машин. Виртуальная машина обеспечивает аппаратную изоляцию между потребителями облачного сервиса, а контейнеры внутри неё обеспечивают эффективное размещение и управление прикладными компонентами.
Сравнительная характеристика
Различия двух подходов по основным характеристикам сведены в таблицу; рисунок ниже показывает их программные стеки.
| Характеристика | Виртуальная машина | Контейнер |
|---|---|---|
| Граница изоляции | гипервизор и аппаратная виртуализация процессора | пространства имён и cgroups общего ядра хоста |
| Ядро ОС | собственное у каждой ВМ | общее ядро хоста |
| Гостевая ОС | любая, поддерживаемая архитектурой (Linux, Windows, BSD) | только совместимая с ядром хоста (Linux-контейнеры — на ядре Linux) |
| Память на служебные нужды | от сотен МиБ до нескольких ГиБ на ядро и системные службы | единицы МиБ сверх самого приложения |
| Время запуска | от десятков секунд до минут (загрузка ОС) | доли секунды или секунды (запуск процесса) |
| Размер артефакта | гигабайты (образ диска) | десятки–сотни мегабайт (слои образа, общие между образами) |
| Процессы видны с хоста | нет, виден только процесс гипервизора | да, как обычные процессы с глобальными PID |
| Типичное применение | разделение арендаторов, разные ОС, особые требования к ядру | микросервисы, CI/CD, плотное размещение однотипных нагрузок |
Контейнер и образ: назначение и взаимосвязь
В Docker используются две взаимосвязанные сущности: образ и контейнер. Образ — это подготовленный артефакт, который описывает, что именно будет запущено. Контейнер — это экземпляр выполнения, который определяет, как именно это будет запущено в конкретный момент времени.
Образ (image) представляет собой файловую систему приложения и набор метаданных запуска. В образ не входит ядро операционной системы и драйверы устройств: контейнеры используют ядро системы-хоста. Назначение образа — обеспечить переносимость и воспроизводимость: если используется один и тот же образ, приложение стартует в одинаковом наборе файлов и зависимостей (при условии совместимости архитектуры и платформы). Образ хранится локально или в реестре и может быть версионирован.
Контейнер (container) создаётся на основе образа и является объектом времени выполнения. При создании контейнера формируется отдельный слой файловой системы с возможностью записи, а также фиксируются параметры запуска: команда, переменные окружения, ограничения ресурсов, подключаемые хранилища и сетевые настройки. Контейнер «живёт», пока выполняется основной процесс внутри контейнера; при завершении этого процесса контейнер переходит в остановленное состояние. Поэтому контейнер — это не «отдельная операционная система», а управляемая среда для выполнения процесса(ов) с заданной изоляцией и ресурсными ограничениями.
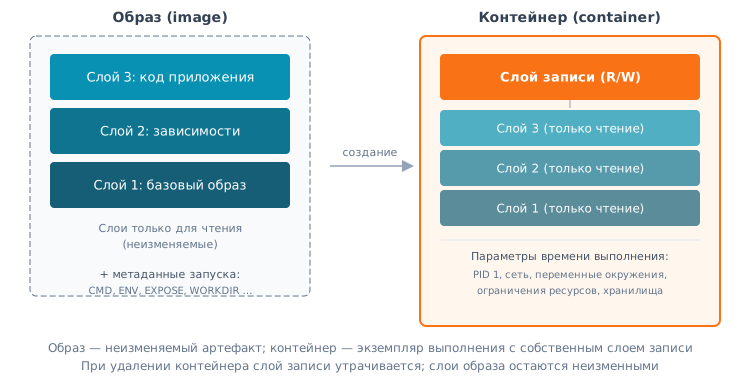
Из этой модели следует ключевая практика эксплуатации. Изменения, выполненные внутри работающего контейнера, относятся к его слою записи и не являются надёжным способом сопровождения: при пересоздании контейнера они исчезают. Поэтому корректный процесс обновления приложения заключается в создании новой версии образа и запуске нового контейнера, а не во внесении изменений в уже запущенный экземпляр.
Изоляция контейнеров: пространства имён и группы управления ресурсами
Контейнеры в Linux не являются отдельными операционными системами. Это процессы, которым ядро предоставляет изолированные представления части ресурсов и одновременно применяет количественные ограничения на потребление этих ресурсов. В Docker данная модель скрыта за простым интерфейсом запуска, однако для понимания поведения контейнеров в эксплуатации важно знать, какими механизмами изоляция и ограничения реализуются.
Изоляция обеспечивается пространствами имён (namespaces). Пространство имён можно понимать как механизм, который заставляет процесс «видеть» только выделенный ему набор системных объектов. Например, в контейнере может быть собственная нумерация процессов, собственная конфигурация сети и отдельное дерево монтирования файловых систем. Для контейнеризации чаще всего используются несколько типов пространств имён.
PID namespace определяет, какие процессы видимы и как они нумеруются внутри контейнера. Благодаря этому процессы контейнера не видят процессы хоста и других контейнеров, а внутри контейнера основной процесс получает идентификатор PID 1. Этот факт имеет практические последствия: PID 1 в Linux обладает особыми обязанностями по обработке сигналов и «сборке» завершившихся дочерних процессов; поэтому некоторые приложения в роли PID 1 требуют корректной настройки, а в реальных системах нередко используют специализированные минимальные процессы-инициализаторы.
Network namespace предоставляет контейнеру отдельный сетевой стек: сетевые интерфейсы, таблицы маршрутизации, правила фильтрации. С точки зрения процессов внутри контейнера сеть выглядит «своей», хотя физически пакеты всё равно проходят через подсистему хоста. Именно на базе network namespaces Docker строит модели виртуальных сетей и изоляции взаимодействия между контейнерами.
Mount namespace формирует отдельное дерево монтирования. Это позволяет контейнеру иметь свою корневую файловую систему, собранную из слоёв образа, а также подключать дополнительные хранилища (например, тома) в заданные точки. Mount namespace тесно связан с механизмом слоистой файловой системы контейнера: процессы контейнера видят единое дерево каталогов, хотя на уровне реализации оно составлено из нескольких слоёв.
UTS namespace изолирует такие атрибуты, как имя хоста и доменное имя узла, что полезно для корректного поведения приложений, которые используют эти значения. IPC namespace изолирует механизмы межпроцессного взаимодействия (объекты System V IPC и очереди сообщений POSIX), снижая риск нежелательных пересечений между контейнерами.
User namespace позволяет отображать идентификаторы пользователей и групп контейнера на другие идентификаторы на хосте 6. Это важно для безопасности: процесс может иметь высокие привилегии внутри контейнера, но соответствовать непривилегированному пользователю на хосте. На этой возможности основаны режимы запуска без прав суперпользователя (rootless), которые уменьшают последствия возможной компрометации приложения. Важно, однако, что по умолчанию Docker пространство имён пользователей не создаёт: процесс, работающий в контейнере от root, на хосте тоже имеет UID 0. Его возможности урезаны другими средствами — сокращённым набором привилегий (capabilities), фильтром системных вызовов seccomp и профилем AppArmor или SELinux, — но это всё ещё root ядра хоста. Отображение идентификаторов включается явно: режимом userns-remap демона, при котором UID 0 контейнера соответствует непривилегированному диапазону идентификаторов хоста 8, или запуском всего Docker без прав root (rootless mode). Эти вопросы подробно рассматриваются в теме 11.
Одной из целей контейнеризации является также управляемое распределение ресурсов. Для этого ядро предоставляет механизм групп управления ресурсами (cgroups). Через cgroups можно ограничивать и учитывать потребление процессорного времени, оперативной памяти, дискового ввода-вывода и числа процессов, а также собирать статистику использования ресурсов. Современные дистрибутивы используют cgroups v2 с единой иерархией (тема 2): для каждого контейнера Docker создаёт отдельную группу, на хосте с systemd — с именем вида docker-<идентификатор>.scope внутри system.slice, и записывает в её файлы memory.max, cpu.max и pids.max значения ключей --memory, --cpus и --pids-limit. Практическая ценность cgroups проявляется в мультисервисных системах: без ограничений один контейнер способен занять всю память или создать избыточную нагрузку на CPU и тем самым нарушить работу других сервисов. В эксплуатационной практике задавать лимиты — это способ сделать поведение системы предсказуемым и снизить влияние ошибок и пиков нагрузки.
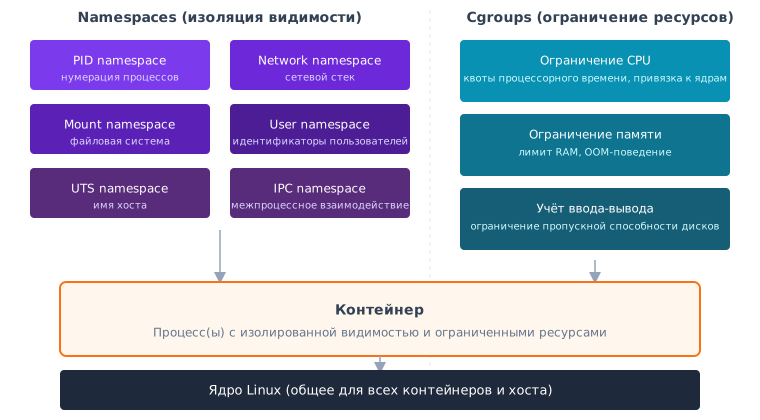
Важно понимать, что namespaces и cgroups решают разные задачи. Пространства имён отвечают за границы видимости и изоляцию, тогда как cgroups — за количественные ограничения и учёт. Docker объединяет оба механизма в единый объект контейнера, что и создаёт эффект «изолированной среды выполнения».
Наблюдение изоляции с хоста
Утверждение «контейнер — это процесс хоста» проверяется несколькими командами. Запустим веб-сервер и узнаем глобальный PID его основного процесса (здесь и далее в теме выводы Docker приведены по документации и сокращены; идентификаторы и номера на конкретной машине будут другими):
docker run -d --name web -p 8080:80 nginx:1.28
docker inspect --format '{{.State.Status}} pid={{.State.Pid}} cmd={{.Config.Cmd}}' web
3f1c9a2b7d4e8c0f5a6b1d2e3f4a5b6c7d8e9f0a1b2c3d4e5f6a7b8c9d0e1f2a
running pid=24817 cmd=[nginx -g daemon off;]
Первая строка — полный идентификатор созданного контейнера, вторая — его состояние и PID основного процесса в пространстве имён хоста. Этот процесс виден обычной командой ps на хосте, а файлы /proc/<pid>/cgroup и /proc/<pid>/ns показывают, в какой группе cgroups и в каких пространствах имён он находится:
ps -o pid,ppid,user,cmd -p 24817
cat /proc/24817/cgroup
sudo readlink /proc/24817/ns/pid /proc/self/ns/pid
cat /proc/24817/uid_map
    PID    PPID USER     CMD
  24817   24795 root     nginx: master process nginx -g daemon off;
0::/system.slice/docker-3f1c9a2b7d4e8c0f5a6b1d2e3f4a5b6c7d8e9f0a1b2c3d4e5f6a7b8c9d0e1f2a.scope
pid:[4026532671]
pid:[4026531836]
         0          0 4294967295
Из этого вывода следуют четыре наблюдения. Процесс nginx на хосте — обычный процесс с PID 24817, принадлежащий пользователю root. Он находится в отдельной группе cgroups v2, имя которой содержит идентификатор контейнера. Его пространство имён PID отличается от пространства оболочки хоста (номера в ссылках разные), поэтому внутри контейнера этот же процесс имеет PID 1 — это видно и по журналу nginx, где мастер-процесс подписывается как 1#1. Наконец, отображение UID 0 0 4294967295 — тождественное: весь диапазон идентификаторов внутри совпадает с диапазоном снаружи, то есть отдельного пространства имён пользователей у контейнера нет. Родительский процесс с PID 24795 — это containerd-shim-runc-v2, роль которого разобрана ниже, в разделе об архитектуре Docker.
Файловая система контейнера: слои образа, слой записи и внешнее хранение данных
Когда контейнер создаётся из образа, Docker должен предоставить процессам контейнера корневую файловую систему, которая выглядит как обычное дерево каталогов. При этом образ состоит из слоёв «только чтение», а контейнер должен иметь возможность изменять файлы в ходе работы. Эта задача решается при помощи объединённой (слоистой) файловой системы, где к слоям образа добавляется верхний слой с возможностью записи.
Слой записи контейнера является индивидуальным для каждого контейнера. Любые изменения файлов — создание новых, модификация существующих, удаление — фиксируются именно в этом верхнем слое. При чтении данных система формирует итоговую картину: если файл изменён, используется версия из слоя записи; если не изменён, берётся из нижних слоёв образа. Такое устройство обеспечивает быстрое развёртывание и экономию дискового пространства.
Вместе с тем слой записи связан с жизненным циклом контейнера. При удалении контейнера этот слой исчезает, а значит, исчезают и изменения, которые хранились только в нём. Поэтому слой записи следует рассматривать как место для временных данных и внутренних изменений, которые допускается потерять при пересоздании контейнера. Если приложению требуется постоянное хранение (данные базы, загруженные пользователями файлы, результаты вычислений), такие данные должны быть вынесены во внешнее хранилище — механизмы постоянного хранения данных в контейнерных средах подробно рассматриваются в соответствующей теме курса.
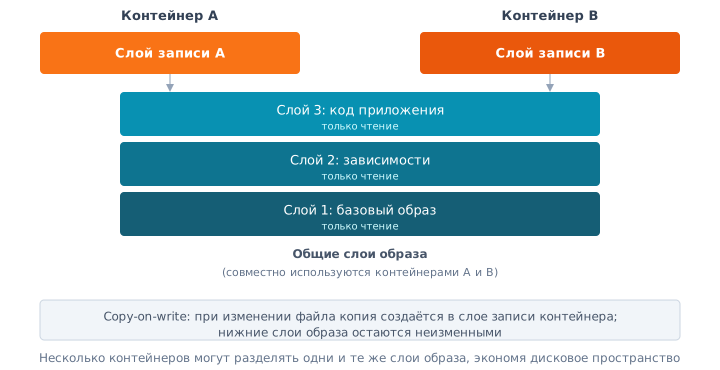
Слоистая файловая система влияет и на производительность. Для большинства приложений накладные расходы невелики, однако при интенсивной записи слой записи и механизмы copy-on-write могут создавать дополнительные издержки. Это обстоятельство учитывается при проектировании политики хранения данных контейнерных приложений.
Слои образа и overlay2 в выводе инспекции
В Linux слоистая файловая система Docker реализуется драйвером overlay2 поверх файловой системы ядра OverlayFS 210. OverlayFS объединяет несколько каталогов: нижние (lowerdir) доступны только для чтения и соответствуют слоям образа, верхний (upperdir) принимает все записи, а объединённый (merged) — то, что процесс контейнера видит как /. При первой записи в файл из нижнего слоя файл целиком копируется в верхний (copy-on-write); удаление файла нижнего слоя записывается в верхний как специальный файл-«затирание» (whiteout). Именно поэтому изменение большого файла в контейнере стоит копирования всего файла, а удаление файла из базового образа не уменьшает размер образа.
Список слоёв образа хранится в его метаданных. Каждый слой идентифицируется хешем SHA-256 своего несжатого содержимого (diff ID):
docker image inspect nginx:1.28 --format '{{range .RootFS.Layers}}{{println .}}{{end}}'
docker history nginx:1.28 --format '{{.Size}}\t{{.CreatedBy}}' | head -4
sha256:7914c8f600f5...
sha256:0a3f4c8e9b51...
sha256:5e2d7b1a6c84...
sha256:9c1f8a3d2e07...
sha256:4b6e0d9f3a12...
sha256:e8a2c5f7b931...
sha256:2d9b4e6a8c05...
0B      CMD ["nginx" "-g" "daemon off;"]
0B      STOPSIGNAL SIGQUIT
0B      EXPOSE map[80/tcp:{}]
0B      ENTRYPOINT ["/docker-entrypoint.sh"]
Первый слой — базовая файловая система Debian, следующие — установка nginx и стартовых скриптов (хеши здесь сокращены). Строки docker history нулевого размера соответствуют инструкциям, которые меняют только метаданные образа, а не файлы, — подробно это разбирается в теме 4. Два образа с одинаковым базовым слоем хранят его на диске один раз, а контейнер добавляет к слоям образа только свой верхний слой.
Следует оговорить, что начиная с Docker Engine 29 новые установки по умолчанию используют хранилище образов containerd (containerd image store): в выводе docker info драйвер хранилища тогда отображается как overlayfs с пометкой io.containerd.snapshotter.v1, а файлы слоёв лежат в каталоге containerd, а не в /var/lib/docker/overlay2. Механизм объединения каталогов от этого не меняется — это та же OverlayFS ядра.
Архитектура Docker: клиент, демон и компоненты исполнения
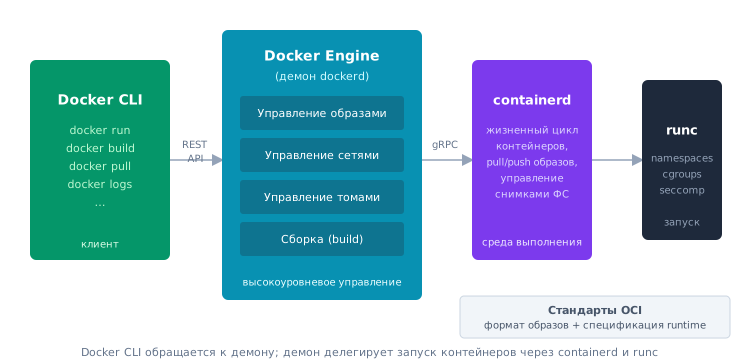
Docker включает клиентскую утилиту (CLI) и серверный компонент Docker Engine (демон). Клиент направляет запросы демону, а демон управляет объектами Docker: образами, контейнерами, сетями, томами и процессом сборки. Этот подход отделяет интерфейс управления от реализации операций и позволяет централизованно вести состояние объектов.
На более низком уровне выполнение контейнеров делегируется специализированным компонентам. Компонент containerd отвечает за управление жизненным циклом контейнеров и взаимодействие с хранилищами образов, а runc выполняет непосредственный запуск контейнера, настраивая изоляцию через пространства имён и ограничения ресурсов через cgroups. Такое разделение упрощает поддержку и развитие системы: высокоуровневые функции управления (образы, сети, тома) отделены от механизма запуска процессов 1.
Между containerd и runc находится ещё один компонент — прослойка (shim) containerd-shim-runc-v2. Цепочка запуска выглядит так: клиент docker передаёт запрос демону dockerd по REST API через сокет /var/run/docker.sock; dockerd вызывает containerd по gRPC; containerd запускает для контейнера процесс shim; shim вызывает runc, который создаёт пространства имён и cgroups, запускает в них основной процесс контейнера и завершается 9. После этого родителем процесса контейнера остаётся shim. Он держит открытыми стандартные потоки контейнера (из них Docker формирует журнал), ожидает завершения процесса и сохраняет код выхода. Благодаря этому dockerd и containerd можно перезапустить или обновить, не останавливая работающие контейнеры (при включённом параметре демона live-restore). Цепочку видно в дереве процессов хоста:
ps -eo pid,ppid,cmd --forest | grep -E 'containerd-shim|nginx' | grep -v grep
  24795       1 /usr/bin/containerd-shim-runc-v2 -namespace moby -id 3f1c9a2b7d4e... -address /run/containerd/containerd.sock
  24817   24795  \_ nginx: master process nginx -g daemon off;
  24866   24817      \_ nginx: worker process
  24867   24817      \_ nginx: worker process
Обратим внимание: родитель shim — процесс с PID 1 хоста (systemd), а не dockerd; пространство имён containerd, в котором Docker создаёт свои контейнеры, называется moby.
Docker Desktop и WSL2: контейнеры внутри Linux-ВМ
Контейнер использует ядро хоста, а Linux-контейнеру нужно ядро Linux. Поэтому на macOS и Windows Docker не может запустить Linux-контейнер напрямую, и Docker Desktop решает эту задачу виртуальной машиной: на macOS — небольшой ВМ с Linux-дистрибутивом LinuxKit под управлением фреймворка виртуализации Apple, на Windows — служебным дистрибутивом docker-desktop в WSL2, который сам является лёгкой ВМ под Hyper-V 7. Демон dockerd, containerd и все контейнеры работают внутри этой ВМ, а клиент docker на хосте обращается к демону через проброшенный сокет. Ядро, на котором исполняется контейнер, легко узнать:
docker info --format '{{.OperatingSystem}} | {{.KernelVersion}} | {{.Architecture}}'
docker run --rm ubuntu:24.04 uname -r
Docker Desktop | 6.10.14-linuxkit | aarch64
6.10.14-linuxkit
Этот вывод (по документации, для Mac с процессором Apple) показывает, что контейнер исполняется на ядре linuxkit служебной ВМ, а не на ядре macOS. На Linux-хосте обе команды вернут версию ядра самого хоста, например 6.8.0-85-generic.
Из этого устройства следуют практические особенности, которые иначе выглядят загадочно. Процессы контейнеров не видны в мониторе активности macOS или диспетчере задач Windows — виден только процесс ВМ. Память и процессоры для контейнеров ограничены настройками ВМ в Docker Desktop, а не объёмом памяти компьютера. Каталоги хоста, подключаемые в контейнер, передаются через механизм общих папок ВМ (на macOS — virtiofs), поэтому интенсивный файловый ввод-вывод в них заметно медленнее, чем внутри ВМ. Опубликованный порт -p 8080:80 пробрасывается из ВМ на localhost хоста отдельным сетевым компонентом Docker Desktop. На компьютере с процессором Apple ВМ имеет архитектуру arm64, и образы, собранные только для amd64, запускаются через эмуляцию с заметной потерей скорости. Внутри самой WSL2 можно установить и обычный Docker Engine — тогда он работает в ВМ WSL2 так же, как на любом Linux-хосте.
Совместимость контейнерной экосистемы обеспечивается стандартами OCI (Open Container Initiative). OCI определяет три спецификации: спецификацию среды исполнения (runtime-spec), которая описывает каталог rootfs с файлом config.json и операции create, start, kill, delete над контейнером 3; спецификацию формата образа (image-spec), которая задаёт манифест, конфигурацию и слои в виде архивов tar, адресуемых по хешу содержимого 4; спецификацию распространения (distribution-spec), которая стандартизует HTTP API реестра для загрузки и получения образов 5. runc — эталонная реализация первой из них, а реестры Docker Hub, GitHub Container Registry и реестры облачных поставщиков реализуют третью. Благодаря этому образы и средства запуска могут быть взаимозаменяемыми в пределах стандарта, а инфраструктура не оказывается жестко привязанной к одному программному продукту.
Жизненный цикл и базовые операции
Контейнер создаётся из образа, получает параметры запуска и запускает основной процесс. Контейнер считается запущенным, пока выполняется основной процесс. Это объясняет типичную ситуацию, когда контейнер «сразу останавливается»: обычно причиной является корректное завершение основного процесса, а не ошибка платформы.
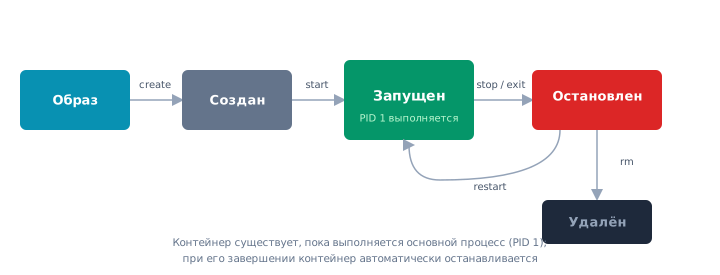
Docker предоставляет механизмы автоматического перезапуска контейнеров при завершении работы — политики перезапуска --restart (no, on-failure, unless-stopped, always), которые подробно рассматриваются в теме 5. Однако эти механизмы являются локальными и не заменяют оркестрацию. Оркестрация решает задачи распределения экземпляров по узлам, управления обновлениями, масштабирования и восстановления при отказах — и будет рассматриваться далее в курсе.
Журналы и инспекция конфигурации
При сопровождении контейнеров необходимо иметь доступ к журналам и к точной конфигурации запуска. В контейнерных приложениях распространена практика вывода журналов в стандартные потоки вывода, чтобы среда запуска могла централизованно собирать журнальные записи и передавать их во внешние системы мониторинга.
Средства инспекции предоставляют доступ к метаданным контейнера и образа: параметрам запуска, используемому образу, подключённым хранилищам, сетевым настройкам и ограничениям ресурсов. Это является основой диагностики, поскольку сбои часто связаны не с логикой приложения, а с ошибками конфигурации запуска.
Команда docker logs выводит то, что основной процесс писал в стандартные потоки; Docker сохраняет эти строки драйвером журналирования (по умолчанию json-file) в файл на хосте. Команда docker inspect с шаблоном --format извлекает отдельные поля из JSON-описания контейнера:
docker logs --tail 3 web
docker inspect --format '{{.State.Status}} exit={{.State.ExitCode}} restarts={{.RestartCount}} mem={{.HostConfig.Memory}}' web
docker stop web && docker inspect --format '{{.State.Status}} exit={{.State.ExitCode}}' web
2026/10/22 09:30:12 [notice] 1#1: start worker processes
2026/10/22 09:30:12 [notice] 1#1: start worker process 29
2026/10/22 09:30:12 [notice] 1#1: start worker process 30
running exit=0 restarts=0 mem=0
web
exited exit=0
Значение mem=0 означает, что лимит памяти не задан. Код выхода после docker stop равен 0, потому что nginx корректно обработал сигнал завершения; приложение, которое не обрабатывает SIGTERM и было завершено принудительно через 10 секунд, получило бы код 137 — разбор кодов выхода и сигналов приводится в теме 5.
Реестры образов
Образы хранятся в реестрах — публичных или частных. Реестр предоставляет интерфейсы для публикации и получения образов и позволяет использовать образы как типовые артефакты поставки. Для сопровождения существенна политика версионирования: в учебных работах часто применяются теги, однако в эксплуатационных сценариях предпочтительнее исключать неоднозначность и фиксировать конкретные версии (включая возможность использования идентификатора содержимого).
Идентификатор содержимого, или дайджест (digest), — это хеш SHA-256 манифеста образа, записываемый как nginx@sha256:…. Тег — изменяемая ссылка: владелец репозитория может в любой момент перенести тег 1.28 на новую сборку с исправлениями, и два docker pull nginx:1.28 с разницей в неделю дадут разные образы. Дайджест неизменяем по построению: изменение любого байта манифеста, а значит и любого слоя, на который он ссылается, меняет хеш 4. Дайджест скачанного образа хранится в его метаданных:
docker image inspect nginx:1.28 --format '{{index .RepoDigests 0}}'
docker run -d nginx@sha256:5f0e9a7c1b2d...   # запуск строго определённой сборки
nginx@sha256:5f0e9a7c1b2d...
Для многоплатформенного образа тег указывает на список манифестов (image index) с отдельными манифестами для amd64, arm64 и других архитектур; Docker выбирает манифест, соответствующий платформе хоста. Использование дайджестов при сборке и развертывании рассматривается в теме 4.
В реальных системах реестр выступает частью цепочки поставки: он позволяет централизованно хранить утверждённые версии образов, управлять доступом и проводить дополнительные проверки (например, сканирование на уязвимости). Эти вопросы будут подробно рассмотрены в главах, посвящённых безопасности и сопровождению.
Ограничения и типичные ошибки интерпретации
Первая ошибка — считать контейнер «лёгкой виртуальной машиной». У контейнера нет своего ядра, загрузчика и системы инициализации; внутри него обычно работает один процесс приложения. Попытка обращаться с контейнером как с ВМ — заходить в него, устанавливать пакеты, править конфигурацию — приводит к среде, которую нельзя воспроизвести: все такие изменения живут в слое записи и исчезают при пересоздании.
Вторая ошибка — полагать, что root в контейнере безопасен, «потому что это контейнер». Без пространства имён пользователей root в контейнере — это UID 0 хоста; от полного контроля над хостом его отделяют capabilities, seccomp и профили LSM, а любой подключённый каталог хоста доступен ему с правами root 11. Поэтому монтирование в контейнер сокета /var/run/docker.sock или корня хоста равносильно выдаче прав root на хосте.
Третья ошибка — переносить на Docker Desktop выводы, сделанные на Linux-хосте, и наоборот. На macOS и Windows контейнеры работают в Linux-ВМ, поэтому их процессы не видны в системе, лимиты ограничены ресурсами ВМ, а пути вроде /var/lib/docker существуют только внутри ВМ.
Четвёртая ошибка — считать, что «контейнер упал», если он перешёл в состояние Exited сразу после запуска. Контейнер живёт ровно столько, сколько его основной процесс; команда, которая выполнила работу и завершилась с кодом 0, — штатный случай. Диагностика начинается с docker ps -a (код выхода в столбце STATUS) и docker logs.
Пятая ошибка — путать ограничение и изоляцию. Пространства имён не мешают процессу израсходовать всю память хоста, а cgroups не скрывают от него чужие процессы. Контейнер без --memory и --pids-limit изолирован, но не ограничен.
Итоги темы
Контейнеризация представляет собой модель изоляции процессов, основанную на механизмах ядра операционной системы — пространствах имён и группах управления ресурсами. В отличие от виртуальных машин, контейнеры разделяют ядро хоста, что обеспечивает существенное сокращение времени запуска и накладных расходов. Docker предоставляет единую модель управления контейнерами, образами, сетями и томами, опираясь на стандарты OCI для обеспечения переносимости. Образ выступает неизменяемым артефактом поставки, а контейнер — его экземпляром времени выполнения с эфемерным слоем записи. Понимание границ контейнерной изоляции, слоистой файловой системы и жизненного цикла контейнера является необходимым основанием для последующего изучения сборки образов, сетевого взаимодействия и оркестрации.
Наблюдение с хоста показывает механизм без посредников: процесс контейнера виден в ps под глобальным PID, его группа cgroups v2 называется по идентификатору контейнера, номера пространств имён отличаются от номеров хоста, а тождественное отображение UID напоминает, что без явной настройки root в контейнере остаётся root хоста. Родителем процесса является containerd-shim-runc-v2, который позволяет перезапускать демон без остановки контейнеров, а runc после создания контейнера уже не работает.
Совместимость экосистемы держится на трёх спецификациях OCI: среды исполнения, формата образа и распространения. Образ адресуется неизменяемым дайджестом, тег же — лишь изменяемый указатель на него. На macOS и Windows вся эта машинерия работает внутри Linux-ВМ Docker Desktop, что объясняет и невидимость контейнеров для хостовой ОС, и особенности производительности общих каталогов.
Следующая тема переходит от запуска готовых образов к их сборке: инструкции Dockerfile, кэш слоёв BuildKit, многоэтапная сборка и публикация в реестр.
Литература
- Docker Documentation. What is Docker? Docker architecture. — https://docs.docker.com/get-started/docker-overview/ (дата обращения: 22.10.2026).
- Docker Documentation. OverlayFS storage driver. — https://docs.docker.com/engine/storage/drivers/overlayfs-driver/ (дата обращения: 22.10.2026).
- Open Container Initiative. Runtime Specification. — https://github.com/opencontainers/runtime-spec (дата обращения: 22.10.2026).
- Open Container Initiative. Image Format Specification. — https://github.com/opencontainers/image-spec (дата обращения: 22.10.2026).
- Open Container Initiative. Distribution Specification. — https://github.com/opencontainers/distribution-spec (дата обращения: 22.10.2026).
- Linux man-pages. user_namespaces(7) — overview of Linux user namespaces. — https://man7.org/linux/man-pages/man7/user_namespaces.7.html (дата обращения: 22.10.2026).
- Docker Documentation. Docker Desktop WSL 2 backend on Windows. — https://docs.docker.com/desktop/features/wsl/ (дата обращения: 22.10.2026).
- Docker Documentation. Isolate containers with a user namespace. — https://docs.docker.com/engine/security/userns-remap/ (дата обращения: 22.10.2026).
- containerd Documentation. — https://containerd.io/docs/ (дата обращения: 22.10.2026).
- The Linux Kernel Documentation. Overlay Filesystem. — https://docs.kernel.org/filesystems/overlayfs.html (дата обращения: 22.10.2026).
- Rice L. Container Security: Fundamental Technology Concepts that Protect Containerized Applications. — O'Reilly Media, 2020.