
Сборка и сопровождение контейнерных образов
Контейнеризация становится практически полезной не в тот момент, когда среда исполнения умеет запускать изолированные процессы, а тогда, когда приложение можно упаковать в воспроизводимый и управляемый артефакт. Таким артефактом в экосистеме Docker является образ (image). Именно образ фиксирует состав файлов, системных библиотек, прикладных зависимостей и параметры запуска, которые затем используются при создании контейнера. Поэтому качество сопровождения контейнерной среды напрямую зависит от того, насколько дисциплинированно организован процесс сборки образов.
На начальном этапе изучения контейнеров образ иногда воспринимают как «снимок» работающей системы. Такое представление отчасти полезно интуитивно, но методически оно недостаточно. Современная практика исходит не из ручного сохранения состояния, а из декларативного описания сборки. Образ должен получаться не в результате последовательности нефиксируемых действий администратора, а на основе формального сценария, который можно повторить, проверить и встроить в цепочку поставки программного обеспечения. В этой связи сборка контейнерного образа является не только технической процедурой, но и элементом инженерной дисциплины.
В рамках данной темы важно различать две взаимосвязанные задачи. Первая состоит в конструировании образа как исполнимого артефакта. Вторая связана с его сопровождением: версионированием, повторной сборкой, публикацией, обновлением и контролем состава. Если эти задачи решаются несистемно, контейнеризация теряет одно из своих главных преимуществ — предсказуемость поведения приложения в разных средах. Поэтому дальнейшее изложение сосредоточено не только на синтаксисе Dockerfile, но и на принципах, которые делают образ пригодным для учебной и производственной эксплуатации.
Dockerfile как декларативное описание образа
Основным средством описания процесса сборки в Docker является файл Dockerfile. Он задаёт последовательность инструкций, на основе которых система сборки формирует новый образ. Каждая инструкция изменяет состояние промежуточной файловой системы или задаёт метаданные, необходимые для последующего запуска контейнера. В этом смысле Dockerfile выполняет роль спецификации: он не просто перечисляет команды, а фиксирует, каким должен быть результат сборки.
Декларативный характер Dockerfile не означает отсутствия пошаговой логики. Напротив, порядок инструкций имеет принципиальное значение. Сборка обычно начинается с инструкции FROM, которая определяет базовый образ (base image). Базовый образ задаёт исходную среду: тип дистрибутива, набор системных библиотек, иногда интерпретатор языка программирования или среду выполнения. Выбор базового образа влияет на размер итогового артефакта, совместимость приложения, доступность инструментов диагностики и поверхность потенциальных уязвимостей. Поэтому выбор «самого маленького» образа не всегда является лучшим решением: чрезмерное упрощение может затруднить сопровождение и отладку.
После выбора базового образа в Dockerfile задаются операции подготовки среды. Инструкции RUN используются для выполнения команд в процессе сборки, например для установки пакетов, компиляции исходного кода или формирования каталогов приложения. Инструкция COPY переносит файлы из контекста сборки внутрь образа, а ADD выполняет сходную функцию, но обладает дополнительными возможностями, которые без необходимости часто использовать не рекомендуется, поскольку это усложняет предсказуемость сборки. Инструкции ENV, WORKDIR, EXPOSE, CMD и ENTRYPOINT определяют параметры окружения, рабочий каталог, сетевые намерения и поведение контейнера при запуске. Важно понимать, что Dockerfile объединяет как операции подготовки файловой системы, так и описание будущего режима исполнения.
Это различие удобно свести в таблицу. Одни инструкции изменяют файловую систему и порождают новый слой, другие лишь записывают поле в конфигурацию образа — JSON-документ, который среда выполнения читает при создании контейнера 17.
| Инструкция | Назначение | Что появляется в образе |
|---|---|---|
FROM | базовый образ, начало стадии сборки | слои базового образа |
RUN | команда, выполняемая при сборке | новый слой |
COPY, ADD | копирование файлов из контекста (ADD также скачивает URL и распаковывает tar-архивы) | новый слой |
WORKDIR | рабочий каталог для последующих инструкций и для процесса контейнера | поле конфигурации; каталог создаётся, если его нет |
ENV | переменная окружения при сборке и при запуске | поле конфигурации |
ARG | переменная, существующая только во время сборки | ничего, кроме следов в истории команд RUN |
LABEL | метка «ключ — значение» | поле конфигурации |
USER | пользователь для последующих RUN и для процесса контейнера | поле конфигурации |
EXPOSE | документирует порт, который слушает приложение | поле конфигурации |
CMD, ENTRYPOINT | команда запуска контейнера (подробно — в теме 5) | поле конфигурации |
HEALTHCHECK, STOPSIGNAL, VOLUME | проверка состояния, сигнал остановки, точка монтирования тома (тема 5) | поле конфигурации |
Пример базового Dockerfile для веб-приложения
Рассмотрим упрощённый пример Dockerfile для небольшого приложения на Python:
FROM python:3.12-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

ENV PORT=8000
EXPOSE 8000

CMD ["python", "app.py"]
В этом примере инструкция FROM задаёт базовую среду с интерпретатором Python. Инструкция WORKDIR определяет рабочий каталог внутри образа и в дальнейшем делает каталог /app текущей рабочей директорией для последующих инструкций. Это означает, что относительные пути в COPY, RUN и CMD далее интерпретируются уже с учётом каталога /app, если не указан иной абсолютный путь.
Для правильного понимания примера необходимо пояснить, что такое контекст сборки. Когда пользователь запускает команду вида docker build ., точка в конце означает, что контекстом сборки становится текущий каталог на машине пользователя. Именно из этого каталога Docker может брать файлы для инструкций COPY и ADD. Следовательно, Docker не копирует файлы произвольно из всей файловой системы хоста, а работает только с тем набором данных, который был передан ему как контекст. Если нужный файл находится вне контекста, инструкция COPY не сможет его использовать без изменения структуры проекта или явного выбора другого контекста.
Инструкция COPY requirements.txt . читается слева направо: сначала указывается источник в контексте сборки, затем назначение внутри образа. В данном случае Docker берёт файл requirements.txt из корня контекста сборки на хостовой машине и копирует его в текущий рабочий каталог внутри образа, то есть в /app/requirements.txt. После этого инструкция RUN pip install --no-cache-dir -r requirements.txt выполняется уже внутри промежуточного контейнера сборки и использует только что скопированный файл зависимостей. Такое разбиение имеет практический смысл: если исходный код приложения изменится, но файл requirements.txt останется прежним, Docker сможет повторно использовать уже собранный слой с установленными пакетами.
Инструкция COPY . . требует отдельного пояснения, поскольку запись с двумя точками часто интерпретируется неверно. Первая точка обозначает источник, то есть весь текущий контекст сборки на стороне хоста, за исключением файлов, исключённых через .dockerignore. Вторая точка обозначает каталог назначения внутри образа, то есть текущий рабочий каталог /app. Иными словами, после выполнения этой инструкции файлы проекта из локального каталога пользователя переносятся внутрь файловой системы образа в каталог /app. Если в проекте присутствуют, например, app.py, каталог templates/ и файл config.yaml, то при отсутствии исключений они будут скопированы в /app/app.py, /app/templates/ и /app/config.yaml.
Наконец, CMD задаёт команду, которая будет выполнена при запуске контейнера по умолчанию. В рассматриваемом случае это команда python app.py, выполняемая в каталоге /app, где уже находятся скопированные файлы приложения и установленные зависимости.
Этот пример также показывает типичное ограничение Dockerfile. Инструкция EXPOSE не публикует порт во внешнюю сеть сама по себе, а лишь документирует намерение приложения использовать соответствующий порт внутри контейнера. Реальный проброс порта на хост задаётся уже при запуске контейнера. Если смешивать эти два уровня, можно ошибочно считать Dockerfile средством полного описания развертывания, хотя он описывает только образ и типовой режим его исполнения.
Разницу легко наблюдать. Образ из примера выше содержит EXPOSE 8000, но после запуска без ключа -p порт хоста не открыт; ключ -p 8080:8000 публикует порт 8000 контейнера на порту 8080 хоста, а ключ -P публикует все объявленные через EXPOSE порты на случайные свободные порты хоста — это единственное место, где EXPOSE влияет на поведение 1:
docker run -d --name a demo:1.0             # порт 8000 доступен только изнутри сети Docker
docker run -d --name b -p 8080:8000 demo:1.0
docker run -d --name c -P demo:1.0
docker port c
8000/tcp -> 0.0.0.0:32768
8000/tcp -> [::]:32768
Сама переменная ENV PORT=8000 тоже не связана с EXPOSE: приложение слушает тот порт, который прочитало из окружения, а EXPOSE лишь сообщает об этом читателю образа. Если изменить одно, не изменив другое, документация разойдётся с поведением. Устройство публикации портов (правила NAT, мост docker0) рассматривается в теме 6.
Пример минимального Dockerfile для статического содержимого
Если приложение не требует собственной среды выполнения, Dockerfile может быть значительно проще. Например, для публикации статического сайта достаточно использовать готовый веб-сервер:
FROM nginx:1.28-alpine

COPY site/ /usr/share/nginx/html/

EXPOSE 80
Здесь образ не содержит этапов установки прикладных зависимостей, потому что они не нужны. Используется готовый сервер nginx, а задача сборки сводится к копированию статических файлов в каталог, из которого сервер отдаёт содержимое. Этот пример полезен методически, поскольку показывает: Dockerfile должен описывать только те действия, которые действительно необходимы для конкретного артефакта. Попытка сделать любой Dockerfile одинаково сложным приводит не к универсальности, а к избыточности.
С методической точки зрения существенна разница между образом как продуктом сборки и контейнером как объектом времени выполнения. Dockerfile описывает образ, но не фиксирует все аспекты будущего запуска. Например, ограничения ресурсов, сетевые подключения и подключение томов обычно задаются на этапе создания контейнера, а не на этапе сборки. Если смешивать эти уровни, возникает неверная интерпретация назначения Dockerfile. Он должен содержать только те сведения, которые характеризуют сам артефакт и его типовое поведение, а не частную конфигурацию конкретного развертывания.
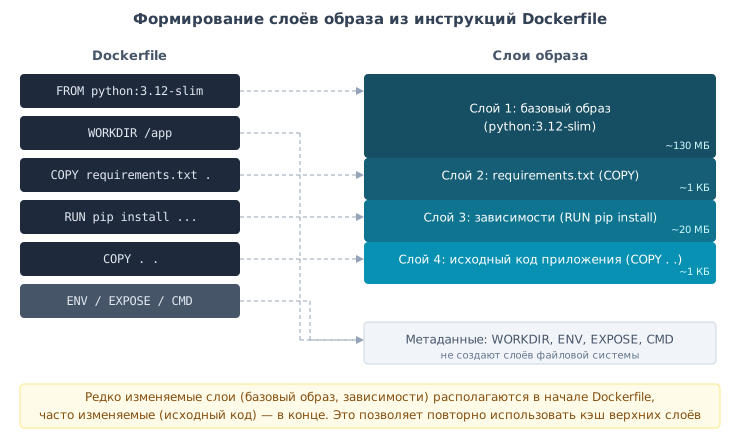
Практический смысл Dockerfile состоит также в том, что он превращает упаковку приложения в повторяемую процедуру. Вместо того чтобы вручную устанавливать зависимости и копировать файлы на сервер, разработчик или инженер сопровождения описывает эти действия в явном виде. Затем одна и та же инструкция сборки может быть выполнена локально, в системе непрерывной интеграции и в учебной лаборатории. Отсюда вытекает локальный вывод: Dockerfile следует рассматривать как часть исходного кода проекта, а не как вспомогательный побочный файл.
Контекст сборки и структура входных данных
Корректность образа определяется не только содержимым Dockerfile, но и тем набором файлов, который передаётся системе сборки. Этот набор называется контекстом сборки (build context). Когда запускается сборка, Docker получает доступ к каталогу проекта или другой указанной директории и может использовать находящиеся в ней файлы в инструкциях COPY и ADD. Если в контекст включены лишние данные, например локальные артефакты сборки, временные файлы, каталоги зависимостей или секреты, они могут не только увеличить размер передаваемых данных, но и случайно попасть в образ.
По этой причине важную роль играет файл .dockerignore. Его назначение сходно с назначением .gitignore, но задача иная: исключить из контекста сборки всё, что не должно участвовать в формировании образа. Типичная ошибка начинающих состоит в том, что они копируют в образ весь каталог проекта без анализа его состава. В результате в образ попадают тестовые данные, журналы, кэши пакетных менеджеров, конфиденциальные файлы среды разработки и иные объекты, не относящиеся к приложению. Такая практика противоречит принципу минимально необходимого состава артефакта.
Синтаксис .dockerignore — по одному шаблону в строке, с подстановками *, ** и отрицанием !; шаблоны применяются к путям относительно корня контекста, а более поздняя строка перекрывает более раннюю 6. Для Python-проекта типичный файл выглядит так:
# служебные каталоги и кэши
.git
__pycache__/
**/*.pyc
.venv/
.pytest_cache/
# локальные артефакты и данные
dist/
*.log
data/
# секреты среды разработки
.env
*.pem
# исключение из исключения: пример конфигурации нужен в образе
!config.example.yaml
Исключение через .dockerignore действует до копирования: исключённый файл не передаётся системе сборки вообще, поэтому никакая инструкция COPY его не увидит. Это принципиально надёжнее, чем удаление файла поздней инструкцией RUN rm, которое, как будет показано в следующем разделе, не убирает данные из нижних слоёв.
BuildKit и передача контекста
Начиная с Docker Engine 23.0 сборку по умолчанию выполняет BuildKit — подсистема сборки, заменившая прежний встроенный сборщик (англ. legacy builder); команда docker build в современных версиях является псевдонимом docker buildx build 2. BuildKit не исполняет Dockerfile строка за строкой. Сначала Dockerfile переводится в граф низкоуровневых операций LLB (англ. low-level build), в котором вершины — шаги сборки, а рёбра — зависимости между ними. Затем граф исполняется: независимые вершины (например, две стадии многоэтапной сборки, не зависящие друг от друга) выполняются параллельно, а стадии, от которых не зависит итоговая, вообще пропускаются.
Изменился и порядок передачи контекста. Прежний сборщик перед первой инструкцией упаковывал весь каталог в архив и отправлял его демону, сообщая об этом строкой Sending build context to Docker daemon. BuildKit передаёт контекст синхронизацией файлов: при повторной сборке отправляются только изменившиеся файлы, а в выводе передача видна как шаг [internal] load build context. Для каталога, в котором лежит лишний файл размером 50 МиБ, вывод в режиме --progress=plain выглядит так:
docker build --progress=plain -t demo:1.0 .
#1 [internal] load build definition from Dockerfile
#1 transferring dockerfile: 213B done
#1 DONE 0.0s
...
#4 [internal] load .dockerignore
#4 transferring context: 2B done
#4 DONE 0.0s
...
#6 [internal] load build context
#6 transferring context: 52.43MB 0.6s done
#6 DONE 0.7s
...
#8 [3/5] COPY requirements.txt .
#8 CACHED
Строка transferring context: 52.43MB — это 50 МиБ (52 428 800 байт) лишнего файла плюс несколько килобайт исходного кода. После добавления файла в .dockerignore она сокращается до сотен байт. Метка CACHED у шага означает, что результат взят из кэша сборки; механизм кэша разобран в разделе о кэшировании. Первая строка Dockerfile вида # syntax=docker/dockerfile:1 указывает BuildKit, какую версию синтаксического анализатора (фронтенда) использовать; она нужна, чтобы новые возможности вроде RUN --mount работали одинаково на разных версиях Docker 1.
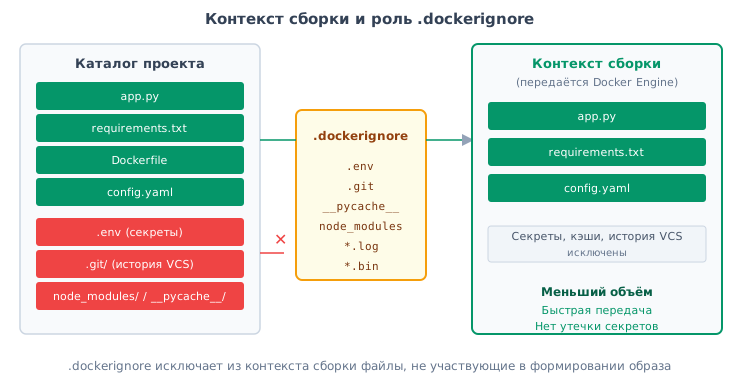
Контекст сборки имеет и эксплуатационный аспект. Чем больше его объём, тем медленнее сборка и тем выше вероятность, что несущественные изменения в одном из файлов нарушат кэширование последующих шагов. Следовательно, сопровождение образа начинается ещё до выполнения первой инструкции Dockerfile: инженер должен определить, какие именно исходные материалы являются частью поставки, а какие должны оставаться вне её границ. Этот вопрос связывает процесс контейнеризации с общей культурой управления проектом и конфигурацией репозитория.
Слои образа и логика пошаговой сборки
Ключевая особенность контейнерного образа состоит в его слоистой структуре. Каждый существенный шаг сборки формирует новый слой файловой системы или новый набор метаданных. На практике это означает, что образ не является монолитным архивом, собранным одним действием. Он представляет собой последовательность изменений, применяемых к базовому состоянию. Такая организация позволяет повторно использовать общие фрагменты между разными образами и снижает издержки хранения и передачи.
Слоистость имеет не только инфраструктурный, но и методический смысл. Если в Dockerfile сначала устанавливаются системные зависимости, затем копируются описания зависимостей приложения, затем выполняется их установка и лишь после этого копируется остальной исходный код, то повторная сборка после изменения одного исходного файла затронет только поздние шаги. Если же в начале сборки копируется весь проект целиком, а затем выполняется установка зависимостей, любое изменение в рабочем каталоге приведёт к повторному исполнению тяжёлых операций. Следовательно, структура Dockerfile должна отражать не только логику получения результата, но и ожидаемую частоту изменения отдельных составляющих проекта.
Следует учитывать, что слой не является независимым контейнером или самостоятельной файловой системой в полном смысле. Он представляет собой набор различий по отношению к предыдущему состоянию. Поэтому удаление файла на позднем этапе не означает, что соответствующие данные физически не присутствуют в нижележащих слоях. Этот момент особенно важен для безопасности и оптимизации. Если секретный файл был скопирован в образ на одном шаге, а затем удалён на следующем, его след может сохраниться в истории слоёв. Из этого вытекает важное ограничение: нежелательные данные нельзя сначала включать в сборку с расчётом на их последующее удаление.
Понимание слоистой структуры позволяет корректно интерпретировать и размер образа. Итоговый объём определяется не только «видимым» содержимым файловой системы контейнера, но и историей изменений, накопленных в слоях. Поэтому рациональная организация шагов сборки является одновременно вопросом производительности, безопасности и эксплуатационной ясности.
Кэширование и воспроизводимость сборки
Одним из преимуществ Docker является механизм кэширования шагов сборки. Если инструкция Dockerfile и все зависящие от неё входные данные не изменились, система может повторно использовать уже сформированный слой. Это существенно ускоряет повторную сборку, особенно если в процессе участвуют длительные операции: установка пакетов, загрузка зависимостей или компиляция. Однако кэширование не является самоцелью. Быстрая, но непредсказуемая сборка не решает инженерную задачу.
Более фундаментальным требованием является воспроизводимость. Под воспроизводимостью в данном контексте понимается способность получить функционально эквивалентный образ при повторном выполнении одной и той же процедуры сборки. Абсолютная двоичная идентичность в практических условиях достигается не всегда, поскольку на результат могут влиять временные метки, внешние источники пакетов и детали компиляции. Тем не менее инженерная цель состоит в том, чтобы минимизировать число нефиксированных факторов, от которых зависит результат.
Нарушение воспроизводимости часто связано с несколькими типичными причинами. Во-первых, используются плавающие версии зависимостей, когда при каждой сборке пакетный менеджер получает потенциально новый состав библиотек. Во-вторых, в Dockerfile включаются операции, зависящие от текущего времени, внешнего состояния сети или изменяющихся удалённых ресурсов без фиксации конкретных версий. В-третьих, сборка опирается на локальные, неформализованные предпосылки: существование файла в рабочем каталоге, который не включён в репозиторий, особенности конфигурации хоста или неявные секреты среды. Подобные зависимости особенно опасны в учебных и командных проектах, поскольку делают результат неустойчивым к переносу.
Следовательно, при проектировании Dockerfile необходимо стремиться к явной фиксации входных условий. Версии базового образа должны задаваться осмысленно, зависимости приложения должны устанавливаться на основе контролируемых описаний, а контекст сборки должен содержать только то, что действительно требуется для получения результата. Практическое значение этого принципа проявляется при сопровождении: если образ можно собрать только на одном рабочем месте и только у одного участника команды, такой артефакт нельзя считать надёжно сопровождаемым.
Кэширование и воспроизводимость связаны между собой, но не совпадают. Инструкция, максимально оптимизированная для повторного использования кэша, может оставаться плохо воспроизводимой, если она опирается на изменчивый внешний ресурс. И наоборот, воспроизводимая сборка может выполняться медленнее, если её шаги организованы нерационально. Поэтому инженер должен учитывать оба критерия одновременно и принимать компромиссные решения осознанно.
Как BuildKit решает, можно ли взять шаг из кэша
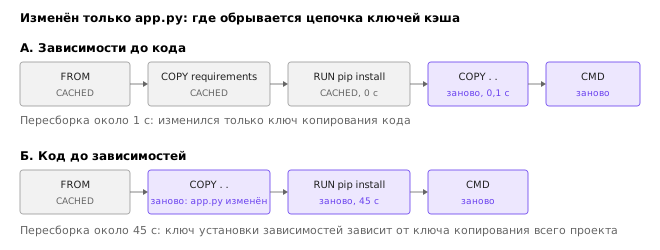
Ключ кэша шага вычисляется из ключа предыдущего шага и из собственных входных данных шага 3. Отсюда главное правило: как только один шаг выполнен заново, все последующие шаги той же стадии тоже выполняются заново, даже если их собственные входные данные не изменились. Что именно считается входными данными, зависит от инструкции.
| Инструкция | Что входит в ключ кэша | Типичная неожиданность |
|---|---|---|
RUN | текст команды и значения ARG/ENV, видимые шагу | RUN apt-get update не перевыполняется, хотя индекс пакетов в сети устарел |
COPY, ADD (локальные файлы) | контрольные суммы содержимого и метаданных копируемых файлов; время изменения не учитывается | COPY . . инвалидируется любой правкой в контексте, включая README |
ADD с URL | содержимое ресурса | при каждой сборке выполняется запрос к серверу, чтобы проверить, не изменился ли ресурс |
ENV, LABEL, WORKDIR и другие метаданные | значение инструкции | изменение ENV в начале файла инвалидирует все следующие RUN |
Рассмотрим числовой пример. Пусть в Dockerfile пять шагов: FROM (из кэша), COPY requirements.txt ., RUN pip install (45 с, 30 пакетов), COPY . . (0,1 с) и метаданные. Разработчик меняет одну строку в app.py. При порядке «сначала зависимости, потом код» ключи шагов 2 и 3 не изменились, заново выполняется только COPY . ., и пересборка занимает около секунды. Если же поставить COPY . . перед pip install, изменившийся app.py меняет ключ копирования, а за ним и ключ установки зависимостей: каждая правка кода стоит 45 с. За рабочий день из 40 пересборок это 30 минут ожидания против одной минуты. Схема на рисунке ниже показывает, на каком шаге в каждом из вариантов обрывается цепочка попаданий в кэш.
Кэш сборки хранится там, где работает BuildKit, — на хосте Docker. Новая машина системы непрерывной интеграции начинает с пустым кэшем; BuildKit умеет экспортировать кэш в реестр или в каталог и импортировать его при следующей сборке (--cache-to, --cache-from) 3.
Монтирования на время шага: RUN --mount
Слой фиксирует всё, что шаг RUN оставил в файловой системе. Из-за этого возникают две противоположные проблемы: кэш пакетного менеджера раздувает образ, если его не удалить, и скачивается заново при каждой сборке, если удалить. Секрет, нужный для доступа к закрытому репозиторию, нельзя ни скопировать в образ, ни передать через ARG или ENV — значения последних остаются в истории и конфигурации образа. BuildKit решает обе задачи монтированиями, которые существуют только во время выполнения одного шага и не попадают в слой 15:
# syntax=docker/dockerfile:1
FROM python:3.12-slim
WORKDIR /app
COPY requirements.txt requirements-private.txt ./
# кэш pip живёт между сборками на хосте сборки, но не попадает в слой
RUN --mount=type=cache,target=/root/.cache/pip \
    pip install -r requirements.txt
# секрет доступен как файл /run/secrets/pip_index только во время этого шага
RUN --mount=type=secret,id=pip_index \
    PIP_INDEX_URL="$(cat /run/secrets/pip_index)" pip install -r requirements-private.txt
docker build --secret id=pip_index,src=$HOME/.config/pip_index_url -t demo:1.1 .
| Тип монтирования | Что монтируется | Типичное применение |
|---|---|---|
cache | постоянный каталог кэша на хосте сборки | кэши pip, apt, npm, go build |
secret | файл (или переменная) с секретом | токены и пароли к закрытым репозиториям |
ssh | сокет ssh-агента | git clone закрытых репозиториев по SSH |
bind | каталог из контекста или из другой стадии, только для чтения по умолчанию | использовать файлы, не копируя их в слой |
tmpfs | временная файловая система в памяти | промежуточные файлы шага |
Кэш-монтирование ускоряет пересборку, но не участвует в ключе кэша: если шаг RUN взят из кэша сборки, монтирование не понадобится вовсе. Поэтому оно не заменяет правильный порядок инструкций, а дополняет его — ускоряет именно те пересборки, которые всё-таки пришлось выполнить.
Практика написания Dockerfile и типичные ошибки
Несмотря на кажущуюся простоту синтаксиса, Dockerfile легко превращается в набор механически перенесённых команд из локальной инструкции развертывания. Такой подход ошибочен, потому что контейнерная сборка требует проектирования. Необходимо различать этапы, которые относятся к подготовке приложения, и этапы, которые должны выполняться уже после запуска контейнера. Например, миграции схемы базы данных, если они зависят от доступности внешнего сервиса, не всегда корректно помещать в стадию сборки образа. Сборка должна давать переносимый артефакт, а не пытаться решать все задачи будущей эксплуатации заранее.
Одна из распространённых ошибок связана с созданием чрезмерно универсального образа, который содержит инструменты разработки, компиляторы, тестовые утилиты и средства диагностики, хотя в реальном запуске требуется только приложение и его минимальные зависимости. Такой образ удобен на коротком отрезке обучения, но в долгосрочной перспективе он увеличивает размер поставки, расширяет поверхность атаки и затрудняет анализ состава. Противоположная крайность также нежелательна: чрезмерно «обрезанный» образ может затруднить диагностику ошибок и сопровождение. Отсюда следует, что выбор состава образа должен учитывать назначение среды: разработка, тестирование, обучение или эксплуатация.
Ещё одна типичная ошибка состоит в объединении несвязанных команд в одну длинную инструкцию RUN исключительно ради уменьшения числа слоёв. Формально это может уменьшить историю изменений, но ухудшает читаемость, затрудняет сопровождение и делает диагностику сбоев менее прозрачной. Сокращение числа слоёв не должно становиться самоцелью. Более правильный подход заключается в логическом группировании действий: в пределах одного шага объединяются тесно связанные операции, а между шагами сохраняется понятная структура.
Есть случай, когда объединение обязательно, и его следует отличать от объединения ради числа слоёв. Это установка системных пакетов 4:
RUN apt-get update \
 && apt-get install -y --no-install-recommends curl ca-certificates \
 && rm -rf /var/lib/apt/lists/*
Три команды здесь связаны механизмом слоёв и кэша. Если вынести apt-get update в отдельный RUN, его результат будет взят из кэша при следующих сборках, и добавленный через месяц пакет установится по устаревшему индексу — версия окажется старой или пакет не найдётся вовсе. Если вынести rm -rf /var/lib/apt/lists/* в отдельный RUN, индекс размером в десятки мегабайт останется в нижнем слое и размер образа не уменьшится. Ключ --no-install-recommends отключает установку рекомендуемых, но не обязательных пакетов. Таким образом, правило звучит так: в одном RUN объединяются команды, которые должны выполняться вместе ради корректности или ради того, чтобы временные файлы не попали в слой.
Следует также избегать помещения конфиденциальных данных непосредственно в Dockerfile или в контекст сборки. Пароли, токены доступа и приватные ключи не должны становиться частью образа, поскольку это нарушает базовые требования безопасности и создаёт долговременный риск утечки. Если в процессе сборки требуется доступ к закрытому ресурсу, должны использоваться специальные механизмы безопасной передачи секретов, а не их явное включение в текст сценария. В BuildKit таким механизмом является монтирование RUN --mount=type=secret, рассмотренное в разделе о кэшировании.
Пользователь процесса: USER и числовой идентификатор
Если в Dockerfile нет инструкции USER, процесс контейнера работает от имени root (UID 0). Без пространства имён пользователей, которое Docker по умолчанию не включает, это тот же UID 0, что и у root хоста: ограничивают его capabilities, seccomp и изоляция пространств имён, но при уязвимости среды выполнения или неосторожно смонтированном каталоге хоста последствия будут последствиями для root 12. Поэтому приложение следует запускать от непривилегированного пользователя, а задавать его — числом:
FROM python:3.12-slim
RUN groupadd --gid 10001 app \
 && useradd --no-log-init --uid 10001 --gid 10001 --no-create-home --shell /usr/sbin/nologin app
WORKDIR /app
COPY --chown=10001:10001 . .
USER 10001:10001
CMD ["python", "app.py"]
Числовая форма важна по двум причинам. Во-первых, имя app превращается в UID только через /etc/passwd внутри образа, а среда выполнения, проверяющая «не root ли это», файлов образа не читает. В Kubernetes поле runAsNonRoot: true для образа с USER app приводит к отказу запуска контейнера с ошибкой о том, что нечисловой пользователь не может быть проверен; с USER 10001 проверка проходит 10. Подробно контекст безопасности пода рассматривается в теме 11. Во-вторых, права на файлы в томах и смонтированных каталогах хоста сравниваются по числам, а не по именам (тема 5). Значения выше 10000 выбирают, чтобы не совпасть с системными пользователями хоста и дистрибутива.
Статический анализ Dockerfile
Многие ошибки этого раздела обнаруживаются автоматически. Анализатор hadolint разбирает Dockerfile и проверяет его по набору правил, а команды внутри RUN — встроенным ShellCheck 11. Он запускается из собственного образа и читает Dockerfile со стандартного ввода:
docker run --rm -i hadolint/hadolint:v2.12.0 < Dockerfile
Для Dockerfile, в третьей строке которого стоит RUN apt-get update && apt-get install -y curl, а в девятой — USER root, отчёт выглядит так (текст первого сообщения сокращён):
-:3 DL3008 warning: Pin versions in apt get install. ...
-:3 DL3015 info: Avoid additional packages by specifying `--no-install-recommends`
-:3 DL3009 info: Delete the apt-get lists after installing something
-:9 DL3002 warning: Last USER should not be root
Каждое правило имеет код (DL3009 — не удалены списки apt, DL3002 — последний USER равен root, DL3007 — использован тег latest), и любое из них можно отключить комментарием # hadolint ignore=DL3008 с обоснованием. Анализ Dockerfile проверяет описание сборки; проверку готового образа на известные уязвимости выполняют сканеры, о которых говорится в разделе о цепочке поставки.
Локальный вывод этого раздела состоит в том, что хороший Dockerfile отличается не только корректностью, но и объяснимостью. Его структура должна позволять понять, какие шаги выполняются, зачем они нужны и какие предпосылки они предполагают. Такая прозрачность особенно важна в учебном курсе, где цель состоит не просто в получении работающего артефакта, а в формировании устойчивого инженерного мышления.
Оптимизация образов и многоэтапная сборка
После того как базовая процедура сборки становится корректной и воспроизводимой, возникает задача оптимизации образа. Чаще всего оптимизация понимается как уменьшение размера. Это действительно важный показатель: более компактный образ быстрее передаётся по сети, быстрее загружается в среду исполнения и обычно содержит меньше лишних компонентов. Однако размер не является единственным критерием. Оптимизация должна сохранять функциональную полноту, ясность состава и сопровождаемость.
Наиболее важным инструментом оптимизации является многоэтапная сборка (multi-stage build). Её идея состоит в том, что разные стадии Dockerfile выполняют разные роли. На одной стадии могут устанавливаться компиляторы и инструменты сборки, на другой — выполняться компиляция или упаковка приложения, а в итоговый образ переносятся только результаты, необходимые для запуска. Такой подход позволяет отделить среду построения артефакта от среды его исполнения. Практическое следствие очевидно: в финальном образе не остаются лишние инструменты, которые увеличивали бы размер и расширяли бы потенциальную поверхность атаки.
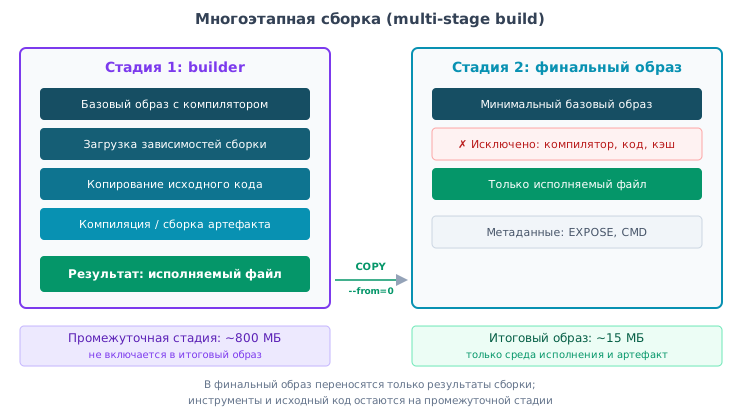
Рассмотрим многоэтапный Dockerfile для Python-приложения, зависимость которого содержит расширение на C и собирается из исходного кода. Чтобы опыт был показательным, сборка из исходников задана явно ключом --no-binary: для популярных пакетов на PyPI обычно есть готовые колёса (англ. wheel), но для редких архитектур, для дистрибутивов на musl и для внутренних пакетов компиляция при установке — обычная ситуация 13:
# syntax=docker/dockerfile:1

# стадия 1: компилятор и заголовки нужны только здесь
FROM python:3.12-slim AS builder
RUN apt-get update \
 && apt-get install -y --no-install-recommends gcc libc6-dev \
 && rm -rf /var/lib/apt/lists/*
WORKDIR /build
COPY requirements.txt .
RUN pip install --no-cache-dir --no-binary=psutil --prefix=/install -r requirements.txt

# стадия 2: тот же базовый образ, но без компилятора
FROM python:3.12-slim
WORKDIR /app
COPY --from=builder /install /usr/local
COPY app.py .
# записи в /etc/passwd нет: для запуска процесса достаточно числового UID
USER 10001:10001
CMD ["python", "app.py"]
Обе стадии начинаются с одного и того же базового образа, поэтому разница в размере между этим образом и однофазным вариантом (тот же Dockerfile без второй стадии) объясняется ровно одним: в однофазном образе остаются gcc, binutils, libc6-dev и их зависимости — порядка сотни мегабайт, — а в многоэтапном только скомпилированная библиотека размером около 2 МБ. Если же сравнивать однофазную сборку на полном образе python:3.12 с многоэтапной на python:3.12-slim, основная часть разницы будет обусловлена сменой базового образа, а не многоэтапностью, и вывод из такого сравнения окажется неверным. Команда docker build --target builder собирает только первую стадию, что удобно для отладки; при обычной сборке BuildKit выполняет лишь те стадии, от которых зависит итоговая.
Многоэтапная сборка особенно полезна для компилируемых языков, однако её значение не исчерпывается ими. Даже в интерпретируемых средах она помогает отделить подготовительные шаги, тестовые зависимости и служебные файлы от финальной поставки. Вместе с тем следует учитывать ограничения. Слишком агрессивная оптимизация, ориентированная только на уменьшение размера, может привести к тому, что образ станет неудобным для диагностики, а процесс сборки — слишком сложным для сопровождения. Следовательно, инженер должен выбирать такую степень оптимизации, которая соответствует назначению конкретного артефакта.
Оптимизация затрагивает и выбор базового образа. Существуют полноценные дистрибутивные образы, минимальные варианты и специализированные среды исполнения. Полноценный образ часто проще в сопровождении, поскольку содержит стандартные инструменты и ожидаемую структуру системы. Минимальный образ уменьшает размер и снижает число потенциально уязвимых компонентов, но может осложнить разбор сбоев и потребовать более аккуратной настройки зависимостей. Выбор между этими вариантами нельзя делать абстрактно: он зависит от требований к безопасности, наблюдаемости, переносимости и удобству сопровождения.
Таким образом, оптимизация не сводится к механическому «сжатию» образа. Она предполагает инженерный анализ того, какие компоненты действительно необходимы в среде выполнения, какие шаги должны остаться на стадии сборки и какие компромиссы приемлемы для конкретного сценария использования.
Версионирование образов и управление изменениями
Образ становится полноценным артефактом поставки только тогда, когда им можно управлять как версией программного продукта. Для этого используются теги (tags), позволяющие различать варианты образа по версии, назначению или каналу поставки. Однако использование тегов нередко сопровождается методической ошибкой: тег воспринимается как абсолютная и неизменная сущность. На практике тег является лишь именованной ссылкой на конкретный образ и может быть переназначен. Поэтому теги вида latest удобны для демонстрации, но плохо подходят для управляемого сопровождения.
С инженерной точки зрения предпочтительно, чтобы версия образа была связана с версией исходного кода, конфигурации сборки и, при необходимости, с состоянием цепочки поставки. Это не означает, что в учебном курсе требуется вводить сложную схему релизного управления, но важно сформировать правильный принцип: образ должен быть однозначно соотнесён с тем исходным состоянием проекта, из которого он получен. Тогда появляется возможность анализировать изменения, воспроизводить прежние версии, выполнять откат и проверять, какой именно артефакт был развернут.
Управление изменениями включает не только присвоение имени версии, но и пересборку образов при обновлении базовых компонентов. Даже если исходный код приложения не менялся, может измениться базовый образ, исправиться уязвимость в системной библиотеке или обновиться среда исполнения. Следовательно, сопровождение контейнерного образа не заканчивается в момент первой успешной сборки. Образ требует периодического пересмотра, повторной сборки и контроля актуальности своих зависимостей.
Теги и дайджесты
Тег изменяем, но у образа есть и неизменяемый идентификатор. По спецификации формата образов OCI образ в реестре описывается манифестом (англ. manifest) — JSON-документом, который перечисляет конфигурацию образа и его слои, ссылаясь на каждый из них по дайджесту (англ. digest), то есть по SHA-256 от содержимого 7. Дайджест самого манифеста и есть идентификатор образа в реестре: python@sha256:… всегда указывает на одни и те же байты, потому что изменение любого слоя меняет дайджест слоя, а с ним — содержимое и дайджест манифеста. Такая адресация по содержимому (англ. content addressing) делает подмену образа под тем же дайджестом невозможной без нарушения SHA-256.
docker pull python:3.12-slim
docker image inspect --format '{{index .RepoDigests 0}}' python:3.12-slim
python@sha256:<64 шестнадцатеричных символа>
Полученную строку можно записать в Dockerfile, и тогда базовый образ закреплён по дайджесту (англ. digest pinning):
FROM python:3.12-slim@sha256:<дайджест из вывода выше>
Если указаны и тег, и дайджест, используется дайджест, а тег остаётся для читателя. Закрепление делает сборку воспроизводимой по базовому слою, но у него есть цена: исправления безопасности, выпущенные в теге 3.12-slim, не придут сами. Поэтому закреплённые дайджесты обновляют осознанно — вручную или ботом, который открывает запрос на изменение с новым дайджестом, — и после обновления пересобирают образ.
Аргументы сборки и метки: ARG и LABEL
Прослеживаемость образа обеспечивается метками. Инструкция LABEL записывает пары «ключ — значение» в конфигурацию образа, а спецификация OCI определяет набор стандартных ключей с префиксом org.opencontainers.image. 7. Значения, известные только в момент сборки (номер версии, хеш коммита), передаются через ARG:
FROM python:3.12-slim
ARG VERSION=dev
ARG GIT_SHA=unknown
LABEL org.opencontainers.image.version="${VERSION}" \
      org.opencontainers.image.revision="${GIT_SHA}" \
      org.opencontainers.image.source="https://example.org/notes/backend"
docker build --build-arg VERSION=1.4.0 --build-arg GIT_SHA=$(git rev-parse --short HEAD) -t notes-backend:1.4.0 .
docker image inspect --format '{{json .Config.Labels}}' notes-backend:1.4.0
ARG, объявленный до FROM, виден только в строке FROM (например, FROM python:${PY_VERSION}-slim); чтобы использовать его внутри стадии, его объявляют повторно. Значения ARG не попадают в окружение контейнера, но видны в docker history для шагов RUN, которые их используют, поэтому для секретов ARG непригоден.
Мультиплатформенные образы
Образ содержит исполняемые файлы под конкретную архитектуру процессора, а машины разработчиков (Apple Silicon — arm64) и серверы (amd64) часто различаются. Для этого спецификация OCI предусматривает индекс образа (англ. image index): один тег указывает на список манифестов, по одному на платформу, и клиент при загрузке выбирает подходящий 7. Такой образ собирается командой docker buildx build с ключом --platform 9:
docker buildx build --platform linux/amd64,linux/arm64 \
    -t registry.example.org/notes-backend:1.4.0 --push .
Чужую архитектуру BuildKit исполняет через эмуляцию QEMU, что для компиляции в десятки раз медленнее; альтернатива — кросс-компиляция в стадии, запущенной на родной платформе (FROM --platform=$BUILDPLATFORM), с использованием предопределённых аргументов TARGETOS и TARGETARCH 9. Для интерпретируемых языков, как в примерах этой темы, обычно достаточно мультиплатформенного базового образа: официальные образы python публикуются для нескольких архитектур.
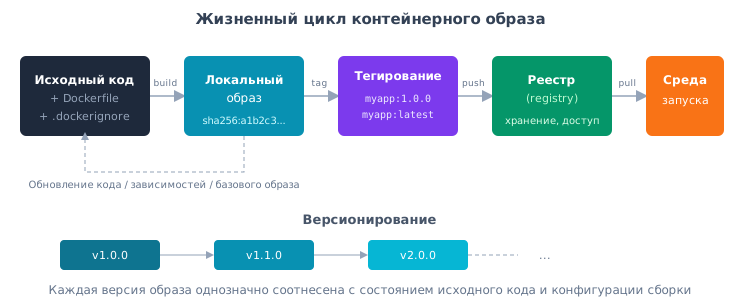
Это обстоятельство особенно важно в облачной среде, где образы часто используются многократно и автоматически распространяются по нескольким средам. Если организация или учебная группа не контролирует происхождение и актуальность образов, она фактически теряет прозрачность поставки. Локальный вывод таков: версионирование образов должно поддерживать не только удобство использования, но и прослеживаемость жизненного цикла артефакта.
Публикация образов и роль реестров
Собранный образ приносит практическую пользу лишь тогда, когда его можно передать в среду исполнения или другой участник процесса может его получить. Для этого используются реестры контейнерных образов (registry). Реестр выполняет роль централизованного хранилища, где образам присваиваются имена, версии и правила доступа. С точки зрения архитектуры поставки реестр является связующим звеном между сборкой и развертыванием.
Публикация образа в реестр позволяет перейти от локального, разового использования к повторяемому сценарию. Один и тот же артефакт может быть собран в системе непрерывной интеграции, затем опубликован в утверждённое хранилище и оттуда использован при развертывании на тестовом или эксплуатационном контуре. Этот подход принципиально отличается от практики «собирать на каждом сервере отдельно». Локальная сборка на целевом узле увеличивает вариативность результата и делает сопровождение менее контролируемым.
Реестры могут быть публичными и частными. Публичные реестры удобны как источник типовых базовых образов и как средство распространения открытых приложений. Частные реестры важны тогда, когда требуется ограничить доступ, обеспечить контроль состава поставляемых артефактов или встроить публикацию в корпоративный контур разработки. Независимо от типа реестра, инженер должен учитывать политику именования, правила аутентификации, сроки хранения образов и процедуры удаления устаревших версий.
Протокол обмена с реестром стандартизован спецификацией распространения OCI (англ. OCI Distribution Specification): это HTTP API с путями вида /v2/<имя>/manifests/<тег или дайджест> и /v2/<имя>/blobs/<дайджест> 8. Из этого следует практическое свойство: при docker push клиент сначала проверяет, есть ли слой с данным дайджестом в реестре, и не передаёт уже имеющиеся слои, а при docker pull не скачивает слои, которые уже есть локально. Полное имя образа складывается из адреса реестра, пути репозитория и тега или дайджеста: в имени registry.example.org:5000/team/notes-backend:1.4.0 реестр — registry.example.org:5000, репозиторий — team/notes-backend, тег — 1.4.0. Если адрес реестра опущен, подразумевается Docker Hub (docker.io), а для официальных образов — ещё и префикс library/: python:3.12-slim означает docker.io/library/python:3.12-slim.
Публикация связана и с вопросами доверия. Образ, полученный из внешнего источника, не следует автоматически считать безопасным или корректным. Требуется понимать, кто его опубликовал, как он был собран и насколько прозрачен его состав. В учебном процессе этот вопрос особенно полезен методически: он показывает, что контейнеризация не отменяет необходимость критически оценивать происхождение программных компонентов, а, напротив, требует ещё большей дисциплины в управлении артефактами.
Сопровождение образов в цепочке поставки
На зрелом уровне контейнерный образ рассматривается как объект цепочки поставки программного обеспечения, а не как разовый технический продукт. Это означает, что сборка образа должна быть встроена в процессы проверки исходного кода, автоматического тестирования, анализа состава зависимостей и публикации результатов. Чем меньше ручных действий требуется для получения и размещения образа, тем ниже риск человеческой ошибки и тем выше воспроизводимость.
Сопровождение образов включает несколько повторяющихся операций: пересборку при изменении кода, обновление базовых компонентов, проверку корректности Dockerfile, контроль размера и состава образа, а также удаление устаревших или неподдерживаемых версий из хранилища. Эти задачи не являются внешними по отношению к контейнеризации; они составляют её нормальный эксплуатационный контур. Ошибочно считать, что после упаковки приложения в контейнер проблема сопровождения исчезает. Меняется не наличие этой проблемы, а форма её решения.
Одна из таких операций — сканирование образа на известные уязвимости. Сканер (в курсе используется Trivy) раскладывает образ на слои, определяет установленные пакеты дистрибутива и библиотеки языков и сопоставляет их версии с базами уязвимостей 12:
trivy image --severity HIGH,CRITICAL python:3.12-slim
Результат сканирования относится к моменту проверки: образ, в котором вчера не было известных уязвимостей, завтра может их получить, хотя не изменился ни один байт, — изменилась база. Поэтому сканирование выполняется не только при сборке, но и периодически по уже опубликованным образам. Сканирование, перечень компонентов (SBOM), подпись образов и политики допуска в кластер подробно рассматриваются в теме 11.
Для учебного курса принципиально важно усвоить следующее: контейнерный образ должен быть прослеживаемым, воспроизводимым и управляемым. Прослеживаемость означает возможность понять происхождение артефакта. Воспроизводимость означает возможность получить сопоставимый результат повторно. Управляемость означает возможность осознанно обновлять, публиковать, отзывать и заменять версии. Именно сочетание этих свойств превращает контейнерный образ в полноценный объект инженерной практики и подготавливает переход к дальнейшим темам курса, связанным с запуском, композицией сервисов и облачной эксплуатацией.
Итоги темы
Сборка контейнерного образа является не вспомогательной технической процедурой, а центральным элементом контейнерной модели поставки приложения. Dockerfile задаёт формальное описание артефакта, а качество этого описания определяет воспроизводимость, переносимость и сопровождаемость результата. По этой причине образ следует проектировать так же внимательно, как и само приложение.
Слоистая структура образов, кэширование и организация контекста сборки требуют осознанной инженерной логики. Нерациональный порядок шагов, включение лишних файлов и использование нефиксированных зависимостей приводят к росту размера образа, ухудшению предсказуемости и снижению безопасности. Напротив, аккуратная структура Dockerfile, применение .dockerignore и фиксация входных условий делают сборку устойчивой и объяснимой. BuildKit добавляет к этому монтирования на время шага: кэш пакетного менеджера и секреты используются при сборке, не оставаясь в слоях.
Оптимизация, многоэтапная сборка, версионирование и публикация в реестры показывают, что образ должен сопровождаться на всём протяжении жизненного цикла. Его необходимо не только однажды собрать, но и регулярно пересматривать, обновлять и связывать с контролируемой цепочкой поставки. Это создаёт основу для следующего этапа изучения: управления контейнерами в среде выполнения и организации повторяемого развертывания приложений.
Литература
- Docker Documentation. Dockerfile reference. — https://docs.docker.com/reference/dockerfile/ (дата обращения: 22.10.2026).
- Docker Documentation. BuildKit. — https://docs.docker.com/build/buildkit/ (дата обращения: 22.10.2026).
- Docker Documentation. Docker build cache. — https://docs.docker.com/build/cache/ (дата обращения: 22.10.2026).
- Docker Documentation. Building best practices. — https://docs.docker.com/build/building/best-practices/ (дата обращения: 22.10.2026).
- Docker Documentation. Build secrets. — https://docs.docker.com/build/building/secrets/ (дата обращения: 22.10.2026).
- Docker Documentation. Build context. — https://docs.docker.com/build/concepts/context/ (дата обращения: 22.10.2026).
- Open Container Initiative. Image Format Specification v1.1. — https://github.com/opencontainers/image-spec (дата обращения: 22.10.2026).
- Open Container Initiative. Distribution Specification v1.1. — https://github.com/opencontainers/distribution-spec (дата обращения: 22.10.2026).
- Docker Documentation. Multi-platform builds. — https://docs.docker.com/build/building/multi-platform/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Configure a Security Context for a Pod or Container. — https://kubernetes.io/docs/tasks/configure-pod-container/security-context/ (дата обращения: 22.10.2026).
- Hadolint: Dockerfile linter. — https://github.com/hadolint/hadolint (дата обращения: 22.10.2026).
- Rice L. Container Security: Fundamental Technology Concepts that Protect Containerized Applications. — O'Reilly Media, 2020.
- Docker Documentation. Multi-stage builds. — https://docs.docker.com/build/building/multi-stage/ (дата обращения: 22.10.2026).