
Управление контейнерами в среде выполнения
Предыдущие темы курса были посвящены созданию контейнерного образа как воспроизводимого артефакта поставки. Однако образ сам по себе не является работающим приложением. Он представляет собой инертное описание файловой системы и параметров запуска, которое приобретает практический смысл лишь тогда, когда на его основе создаётся и запускается контейнер. Именно на этом этапе начинается управление контейнером в среде выполнения: инженер должен определить, как приложение будет запущено, каким образом оно взаимодействует с внешним окружением, как контролировать его поведение и как корректно обновлять.
Управление контейнерами на этапе выполнения принципиально отличается от управления образами на этапе сборки. Если сборка отвечает на вопрос «что содержит артефакт», то среда выполнения отвечает на вопрос «как именно этот артефакт функционирует в конкретных условиях». Один и тот же образ может быть запущен с различными переменными окружения, ограничениями ресурсов, сетевыми настройками и политиками перезапуска. Поэтому корректная эксплуатация контейнера требует не только умения собрать образ, но и понимания того, какие параметры определяют поведение контейнера после его создания.
В рамках данной темы рассматриваются пять взаимосвязанных аспектов. Во-первых, параметры запуска контейнера и их влияние на поведение приложения. Во-вторых, роль основного процесса и механизм завершения контейнера. В-третьих, средства инспекции и диагностики. В-четвёртых, принцип неизменяемой инфраструктуры и модель обновления контейнерных приложений. В-пятых, хранение изменяемых данных вне контейнера: Docker-тома и монтирование каталогов хоста. Вместе эти аспекты формируют представление о контейнере не как о «чёрном ящике», а как об управляемом объекте с определённым жизненным циклом.
Параметры запуска контейнера
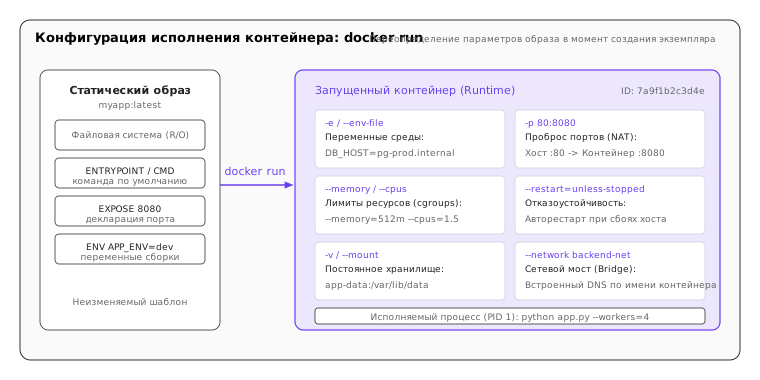
Запуск контейнера — это не просто создание экземпляра образа. Это конфигурирование среды выполнения, в которой приложение будет работать. Параметры запуска определяют, какие ресурсы доступны контейнеру, как он взаимодействует с сетью, какие данные получает из внешнего окружения и каким образом среда выполнения реагирует на его остановку или аварийное завершение. Понимание этих параметров необходимо для перехода от разового экспериментального запуска к воспроизводимому и контролируемому развёртыванию.
Переменные окружения и аргументы команды
Одним из основных способов передачи конфигурации контейнеру являются переменные окружения (environment variables). Они задаются при запуске и доступны процессу внутри контейнера точно так же, как переменные окружения в обычной операционной системе. Переменные окружения удобны тем, что позволяют отделить конфигурацию от образа: один и тот же артефакт может быть запущен с разными параметрами подключения к базе данных, адресами внешних сервисов или режимами работы приложения. Этот принцип — конфигурация в окружении, а не в коде — сформулирован в методологии «двенадцати факторов» 14 и поддерживается ключами -e и --env-file команды docker run 1.
Вместе с тем переменные окружения имеют ограничения. Они не предназначены для передачи сложных структурированных данных и не обеспечивают конфиденциальности значений без дополнительных мер. Если приложение требует передачи секретов, таких как пароли или ключи доступа, использование переменных окружения в явном виде создаёт риск: значения могут быть видны при инспекции контейнера или в журналах среды выполнения. Этот аспект становится особенно важным при переходе к эксплуатационным средам, где управление секретами требует отдельных механизмов.
Помимо переменных окружения, при запуске контейнера можно передавать аргументы командной строки, которые переопределяют команду, заданную в образе инструкцией CMD. Это позволяет, например, запустить контейнер с тем же образом, но в диагностическом режиме, с альтернативной конфигурацией или с выполнением вспомогательной задачи. Такое разделение между образом и параметрами запуска подчёркивает принципиальную идею: образ описывает «что может быть запущено», а параметры запуска определяют «как именно это запускается в данный момент».
Точка входа и команда по умолчанию
Для правильного понимания параметров запуска необходимо различать два механизма, определяющих поведение контейнера при старте: точку входа (entrypoint) и команду по умолчанию (cmd). Точка входа задаёт основной исполняемый файл или сценарий, который будет вызван при запуске контейнера. Команда по умолчанию определяет аргументы, передаваемые точке входа. Если точка входа не задана, команда по умолчанию сама является запускаемой программой. Оболочка участвует в запуске не в зависимости от наличия точки входа, а в зависимости от формы записи: exec-форма (JSON-массив, CMD ["python", "app.py"]) запускает программу напрямую, а shell-форма (строка, CMD python app.py) превращается в /bin/sh -c "python app.py" 3.
Взаимодействие двух инструкций в обеих формах задаётся таблицей из справочника Dockerfile 3. Для краткости e1 e2 — точка входа, c1 c2 — команда.
ENTRYPOINT не задан | ENTRYPOINT e1 e2 (shell) | ENTRYPOINT ["e1", "e2"] (exec) | |
|---|---|---|---|
CMD не задан | запуск невозможен | /bin/sh -c "e1 e2" | e1 e2 |
CMD ["c1", "c2"] (exec) | c1 c2 | /bin/sh -c "e1 e2" | e1 e2 c1 c2 |
CMD c1 c2 (shell) | /bin/sh -c "c1 c2" | /bin/sh -c "e1 e2" | e1 e2 /bin/sh -c "c1 c2" |
Из таблицы видны две неочевидные вещи. Shell-форма ENTRYPOINT полностью игнорирует CMD и аргументы docker run. Сочетание exec-формы ENTRYPOINT с shell-формой CMD передаёт программе бессмысленные аргументы /bin/sh -c .... Работоспособная комбинация для «параметризуемой команды» — обе инструкции в exec-форме:
ENTRYPOINT ["python", "-m", "http.server"]
CMD ["8000"]
docker run --rm demo:entry            # python -m http.server 8000
docker run --rm demo:entry 9000       # python -m http.server 9000: аргументы заменили CMD
docker run --rm --entrypoint python demo:entry -V   # ENTRYPOINT заменяется только ключом --entrypoint
Если CMD не задан и в самом образе, он наследуется от базового образа: в python:3.12-slim это CMD ["python3"], поэтому docker run -it python:3.12-slim открывает интерпретатор.
На практике разделение между entrypoint и cmd позволяет создавать образы, которые ведут себя как «параметризуемые команды». Например, образ утилиты может использовать в качестве точки входа саму утилиту, а аргументы командной строки, переданные при запуске контейнера, будут подставлены как параметры. Это удобно для инструментов, выполняющих конкретные задачи, но нежелательно для сервисных приложений, где точка входа и команда обычно фиксируются на этапе сборки образа.
Типичной ошибкой является смешение ролей entrypoint и cmd. Если обе инструкции используются одновременно, но их взаимодействие не продумано, результат может оказаться неожиданным. Например, если пользователь передаёт аргументы при запуске контейнера, они заменяют значение cmd, но не entrypoint. Непонимание этой логики приводит к трудно диагностируемым сбоям при запуске, особенно если поведение образа не документировано.
Проброс портов и сетевые параметры
Контейнер по умолчанию работает в изолированном сетевом пространстве. Приложение внутри контейнера может слушать сетевой порт, но это не означает, что порт доступен извне. Для предоставления доступа к сервису из внешней сети используется проброс портов (port mapping): при запуске контейнера указывается соответствие между портом хостовой машины и портом внутри контейнера.
Различие между инструкцией EXPOSE и публикацией порта разобрано в теме 4. Здесь достаточно формы ключа -p, которая задаёт адрес хоста, порт хоста и порт контейнера 2:
docker run -d -p 8080:8000 demo:1.0             # все адреса хоста, порт 8080 -> 8000 контейнера
docker run -d -p 127.0.0.1:8080:8000 demo:1.0   # только локальный адрес хоста
docker run -d -p 8000 demo:1.0                  # случайный свободный порт хоста
Вторая форма полезна на машине разработчика: сервис доступен с самого хоста, но не из локальной сети.
Сетевые параметры запуска не ограничиваются пробросом портов. Контейнер может быть подключён к пользовательской сети, в которой действуют собственные правила разрешения имён и маршрутизации. Эти вопросы подробно рассматриваются в последующей теме, посвящённой сетевому взаимодействию контейнерных приложений. Однако уже на данном этапе необходимо понимать, что сетевая конфигурация является частью параметров запуска, а не свойством образа.
Ограничение ресурсов
Среда выполнения контейнеров позволяет задавать ограничения на использование вычислительных ресурсов: процессорного времени и оперативной памяти. Эти ограничения реализуются через механизм групп управления ресурсами (control groups, cgroups), который был рассмотрен в теме, посвящённой механизмам изоляции.
Ограничение ресурсов выполняет несколько функций. Во-первых, оно защищает хостовую систему от ситуации, в которой один контейнер потребляет все доступные ресурсы и вызывает деградацию соседних процессов. Во-вторых, оно позволяет моделировать условия, приближённые к реальной эксплуатации, где приложение работает в рамках выделенного бюджета ресурсов. В-третьих, ограничения служат инструментом раннего обнаружения проблем: если приложение не способно работать в заданных рамках, это сигнализирует о необходимости оптимизации или пересмотра архитектуры.
Следует учитывать, что поведение контейнера при превышении лимита зависит от типа ресурса. Превышение лимита памяти обычно приводит к принудительному завершению контейнера операционной системой (механизм OOM Killer). Превышение лимита процессорного времени приводит к замедлению, но не к завершению. Это различие имеет практическое значение: приложение, не рассчитанное на ограниченный объём памяти, может аварийно завершаться без видимой ошибки в журналах приложения, поскольку завершение инициировано не самим процессом, а ядром операционной системы.
Ключи docker run переводятся в файлы интерфейса cgroup v2 513. Ключ --cpus=0.5 записывается в cpu.max как квота 50 000 мкс процессорного времени на период 100 000 мкс: за каждые 100 мс контейнер может занять процессор не более чем на 50 мс суммарно по всем ядрам, после чего его потоки ждут начала следующего периода. Ключ --memory=64m записывается в memory.max как 67 108 864 байта.
docker run --rm --cpus=0.5 --memory=64m python:3.12-slim \
    cat /sys/fs/cgroup/cpu.max /sys/fs/cgroup/memory.max
50000 100000
67108864
Отдельно задаётся подкачка. Если указан --memory, но не указан --memory-swap, контейнер при наличии на хосте раздела подкачки может дополнительно использовать столько же подкачки, сколько памяти, то есть всего вдвое больше лимита 5. Тогда приложение, превысившее лимит, не завершается, а замедляется из-за вытеснения страниц на диск, и опыт с OOM становится невоспроизводимым. Значение --memory-swap, равное --memory, запрещает подкачку, и превышение лимита приводит к OOM:
docker run --name oom --memory=64m --memory-swap=64m python:3.12-slim \
    python -c "b = bytearray(200 * 1024 * 1024)"
docker inspect --format '{{.State.ExitCode}} {{.State.OOMKilled}}' oom
137 true
Код 137 означает гибель от сигнала SIGKILL, а поле OOMKilled уточняет, что сигнал послал механизм OOM ядра, а не пользователь. В журнале контейнера при этом нет никакого сообщения от приложения: оно не получило возможности что-либо записать.
Политика перезапуска
При запуске контейнера можно задать политику перезапуска (restart policy), которая определяет поведение среды выполнения при завершении контейнера. Существуют несколько вариантов: контейнер не перезапускается; перезапускается всегда; перезапускается только в случае ошибки; перезапускается всегда, кроме явной остановки пользователем.
Политика --restart | Выход с кодом 0 | Выход с ненулевым кодом | После docker stop и перезапуска демона Docker |
|---|---|---|---|
no (по умолчанию) | не перезапускается | не перезапускается | не запускается |
on-failure[:N] | не перезапускается | перезапускается, не более N раз, если N задано | не запускается |
always | перезапускается | перезапускается | запускается |
unless-stopped | перезапускается | перезапускается | не запускается |
Перезапуск выполняет демон Docker, а не сам контейнер, поэтому политика действует и после перезагрузки хоста, если демон запускается автоматически. Явная команда docker stop всегда останавливает контейнер, при любой политике: иначе контейнер с always было бы невозможно остановить. Чтобы контейнер, падающий сразу после старта, не загружал хост, перед каждым перезапуском добавляется задержка, удваивающаяся начиная со 100 мс; она сбрасывается, если контейнер проработал не менее 10 с 4. Число выполненных перезапусков видно в поле RestartCount:
docker run -d --name crash --restart=on-failure:3 python:3.12-slim \
    python -c "import sys; print('старт'); sys.exit(1)"
sleep 5
docker inspect --format '{{.RestartCount}} {{.State.Status}} {{.State.ExitCode}}' crash
3 exited 1
После третьего перезапуска контейнер остаётся в состоянии exited, а docker logs crash содержит четыре строки «старт» — первый запуск и три повторных.
Политика перезапуска является простейшим механизмом обеспечения живучести сервиса на уровне одного узла. Она полезна для длительно работающих приложений, которые должны автоматически восстанавливаться после кратковременного сбоя. Однако этот механизм имеет существенные ограничения. Он не способен обнаружить ситуацию, когда приложение формально работает, но функционально неработоспособно. Он не позволяет распределить нагрузку между несколькими экземплярами. Он не обеспечивает управляемого обновления. Все эти задачи требуют более развитых средств, которые предоставляются оркестраторами и рассматриваются в последующих темах курса.
Связь параметров запуска с воспроизводимостью
Совокупность параметров запуска определяет не только текущее поведение контейнера, но и воспроизводимость развёртывания. Если параметры задаются вручную при каждом запуске, высока вероятность расхождения между средами разработки, тестирования и эксплуатации. Этот риск нарастает по мере увеличения числа параметров и числа контейнеров в составе приложения. Поэтому уже на данном этапе следует осознавать необходимость фиксации параметров запуска в формализованном описании. Средство такой фиксации на одном хосте — Docker Compose — рассматривается в теме 6. Однако важно понимать, что потребность в декларативном описании развёртывания возникает не из абстрактного стремления к порядку, а из конкретных проблем, связанных с ручным управлением параметрами запуска.
Основной процесс и завершение контейнера
Контейнер в среде Docker не является самостоятельной операционной системой и не содержит полноценного менеджера процессов. Он представляет собой оболочку для выполнения одного основного процесса, который определяет жизненный цикл контейнера. Понимание этого принципа является ключевым для корректной эксплуатации контейнерных приложений.
Процесс PID 1
При запуске контейнера среда выполнения создаёт в изолированном пространстве имён процесс, который получает идентификатор PID 1. Этот процесс является корневым для всего дерева процессов внутри контейнера. В обычной операционной системе PID 1 выполняет особую роль: он является процессом инициализации (init), который отвечает за порождение и контроль дочерних процессов, а также за корректную обработку сигналов.
В контейнерной среде процесс PID 1 обычно является самим приложением, а не специализированным менеджером инициализации. Это означает, что приложение принимает на себя обязанности, которые в традиционной системе выполнялись бы системным процессом init. В частности, оно должно корректно обрабатывать сигналы завершения и, при необходимости, управлять дочерними процессами.
Особая роль PID 1 закреплена в ядре. Для обычного процесса у каждого сигнала есть действие по умолчанию (англ. default disposition): для SIGTERM и SIGINT это завершение процесса 6. Для процесса init пространства имён PID ядро действие по умолчанию не применяет: сигнал, для которого init не установил обработчик, просто отбрасывается. Это касается и сигналов, посланных из родительского пространства имён, то есть с хоста; исключение составляют только SIGKILL и SIGSTOP, присланные из родительского пространства, — они доставляются принудительно 7. Защита задумана для настоящего init, гибель которого означает гибель всей системы, но в контейнере у неё неожиданное следствие: программа, которая вне контейнера корректно умирает по SIGTERM, просто потому что не трогает обработку сигналов, будучи PID 1, на SIGTERM не реагирует вовсе.
docker run -d --name sleeper python:3.12-slim python -c "import time; time.sleep(600)"
time docker stop sleeper    # около 10 с: SIGTERM отброшен ядром, через 10 с пришёл SIGKILL
docker run -d --init --name sleeper2 python:3.12-slim python -c "import time; time.sleep(600)"
time docker stop sleeper2   # доли секунды: PID 1 — docker-init, Python — обычный процесс
Во втором случае PID 1 становится маленькая программа инициализации docker-init (это tini), которая устанавливает обработчики, пересылает полученные сигналы дочернему процессу и собирает завершившиеся процессы-«зомби» 2. Python больше не PID 1, к нему применяется действие по умолчанию, и он завершается по SIGTERM.
Связь между PID 1 и жизненным циклом контейнера является прямой. Когда процесс с PID 1 завершается, контейнер прекращает существование, вне зависимости от того, продолжают ли работать какие-либо дочерние процессы. Код завершения процесса PID 1 становится кодом завершения контейнера. Следовательно, проектирование основного процесса контейнера — это не только задача разработки приложения, но и задача корректной интеграции с контейнерной средой.
Обработка сигналов и корректное завершение
Когда пользователь или среда выполнения инициирует остановку контейнера, Docker отправляет процессу PID 1 сигнал SIGTERM. Этот сигнал предлагает процессу завершиться корректно: закрыть сетевые соединения, сбросить буферы данных, освободить ресурсы. Если процесс не завершается в течение установленного времени ожидания (по умолчанию 10 секунд), Docker отправляет сигнал SIGKILL, который принудительно прекращает выполнение процесса без возможности корректного завершения.
Проблема состоит в том, что не все приложения корректно обрабатывают SIGTERM. Если приложение запущено через оболочку (shell), например через CMD ["sh", "-c", "python app.py; echo done"], то PID 1 получает оболочка, а не приложение. Оболочка, как правило, не передаёт полученный сигнал дочернему процессу, а сама, будучи PID 1 без обработчика SIGTERM, этот сигнал не получает вовсе — его отбрасывает ядро. В результате приложение не получает уведомления о необходимости завершения и продолжает работать до истечения тайм-аута, после чего принудительно завершается сигналом SIGKILL. Такое поведение приводит к потере данных, незавершённым транзакциям и увеличению времени остановки контейнера.
Для избежания этой проблемы рекомендуется использовать exec-форму инструкций CMD и ENTRYPOINT в Dockerfile (например, CMD ["python", "app.py"] вместо CMD python app.py). В exec-форме приложение становится процессом PID 1 непосредственно и получает сигналы напрямую. Альтернативный подход — использование легковесного процесса инициализации (init process), который берёт на себя роль PID 1 и корректно передаёт сигналы основному приложению. Docker предоставляет встроенную поддержку такого механизма через параметр запуска --init.
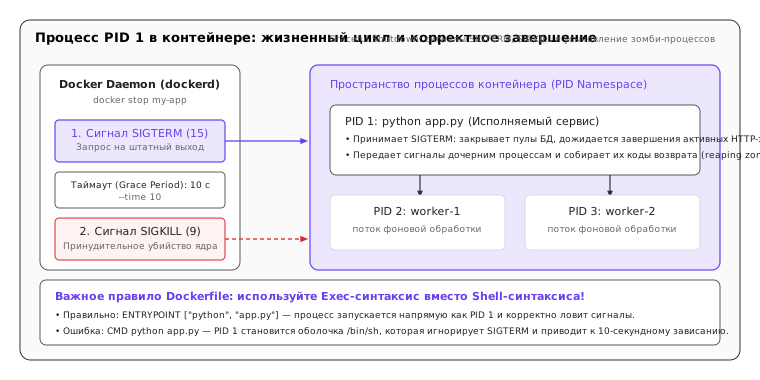
Пример выше намеренно содержит вторую команду после python app.py. Многие оболочки, получив через -c единственную простую команду, не порождают дочерний процесс, а заменяют себя программой системным вызовом exec; так поступает bash и, в зависимости от версии, dash, который в Debian и в образах python:*-slim вызывается как /bin/sh. Тогда sh -c "python app.py" даёт PID 1 = python, и проблема маскируется. Оптимизация не гарантирована и пропадает от любой второй команды, поэтому полагаться на неё нельзя. В сценариях-обёртках (англ. entrypoint script), которые подготавливают окружение и затем запускают приложение, последнюю команду явно записывают через exec:
#!/bin/sh
# docker-entrypoint.sh: подготовка, затем замена оболочки приложением
set -e
python manage.py check
exec python app.py "$@"
Сигнал и время остановки
Сигнал, который docker stop посылает первым, и время ожидания до SIGKILL настраиваются. Инструкция STOPSIGNAL в Dockerfile задаёт сигнал остановки для образа: например, nginx завершает обслуживание текущих запросов по SIGQUIT, поэтому в официальном образе nginx записано STOPSIGNAL SIGQUIT 3. Время ожидания задаётся при запуске ключом --stop-timeout или при остановке ключом -t:
docker run -d --stop-timeout 30 --name api demo:1.0   # сервису нужно до 30 с на завершение
docker stop -t 3 api                                  # для этой остановки ждать только 3 с
Время ожидания должно быть больше, чем приложению реально нужно на завершение текущих запросов, иначе корректное завершение превращается в принудительное. В Kubernetes та же пара «сигнал — ожидание — SIGKILL» задаётся полем terminationGracePeriodSeconds (по умолчанию 30 с), подробно — в теме 7.
Коды завершения
Код завершения PID 1 становится кодом завершения контейнера и виден в docker ps -a и docker inspect. Если процесс убит сигналом, Docker, следуя соглашению оболочек, сообщает код 128 + номер сигнала 26.
| Код | Значение | Типичная причина |
|---|---|---|
| 0 | успешное завершение | процесс обработал SIGTERM и вышел через exit(0); одноразовая задача выполнена |
| 1 | ошибка приложения | необработанное исключение Python, неверная конфигурация |
| 125 | ошибка самого docker run | неизвестный ключ, конфликт имён контейнеров |
| 126 | команда найдена, но не может быть запущена | у файла нет права на исполнение |
| 127 | команда не найдена | опечатка в CMD, программа отсутствует в образе |
| 137 | 128 + 9, процесс убит SIGKILL | OOM, docker kill, истёк тайм-аут docker stop |
| 143 | 128 + 15, процесс убит SIGTERM | процесс без обработчика SIGTERM, не являющийся PID 1 (например, при --init) |
Код 137 сам по себе не различает OOM и принудительную остановку: различие даёт поле .State.OOMKilled, рассмотренное выше. В Kubernetes те же коды видны в поле lastState.terminated.exitCode пода, а OOM отображается причиной OOMKilled (тема 7).
Типичные причины немедленного завершения контейнера
Одна из наиболее частых проблем при начальном знакомстве с контейнерами — контейнер, который завершается сразу после запуска. Это поведение, как правило, объясняется одной из нескольких причин.
Во-первых, основной процесс может завершаться, потому что он предназначен для выполнения одноразовой задачи, а не для длительной работы. Например, если в качестве команды указана утилита, выводящая текст и завершающаяся, контейнер прекратит существование после её выполнения. Контейнер существует ровно столько, сколько работает его основной процесс.
Во-вторых, процесс может завершаться с ошибкой из-за отсутствия необходимых файлов, переменных окружения или зависимостей. В этом случае код завершения контейнера будет ненулевым, а журналы могут содержать диагностическое сообщение.
В-третьих, приложение может быть запущено в фоновом режиме (как демон), после чего основной процесс, породивший демон, завершается. С точки зрения контейнерной модели это означает завершение PID 1 и, следовательно, остановку контейнера. Приложения, предназначенные для работы в контейнере, должны выполняться на переднем плане (foreground), а не уходить в фоновый режим.
Понимание этих причин позволяет избежать типичной ошибки начинающих, которые пытаются решить проблему немедленного завершения добавлением искусственных задержек или бесконечных циклов ожидания. Такие «решения» маскируют реальную проблему и создают контейнеры, которые формально работают, но не выполняют полезной функции.
Инспекция и сопровождение контейнера
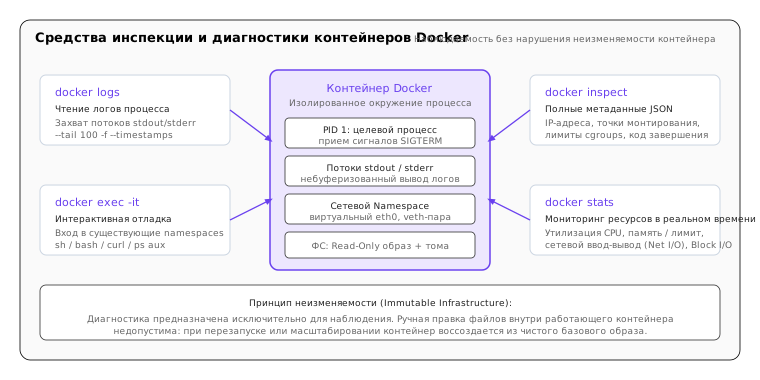
Работающий контейнер является объектом наблюдения и диагностики. Способность получить информацию о состоянии контейнера, его конфигурации и поведении приложения внутри него — это обязательная часть эксплуатационной дисциплины. Docker предоставляет несколько инструментов для решения этой задачи, каждый из которых отвечает на определённый класс вопросов.
Журналы приложения
Основным источником информации о поведении приложения в контейнере являются журналы (logs). В контейнерной модели стандартной практикой считается направление вывода приложения в стандартные потоки: стандартный поток вывода (stdout) и стандартный поток ошибок (stderr). Docker перехватывает эти потоки и сохраняет их содержимое, предоставляя доступ через команду docker logs.
Такой подход имеет несколько достоинств. Он не требует настройки файлового журналирования внутри контейнера. Он позволяет централизованно собирать журналы из множества контейнеров. Он совместим с различными драйверами журналирования, которые могут перенаправлять вывод во внешние системы хранения и анализа.
Вместе с тем следует учитывать ограничения. Не все приложения по умолчанию пишут в стандартные потоки. Некоторые пишут журналы в файлы внутри контейнера, что требует дополнительной настройки для их извлечения. Кроме того, объём журналов, хранимых Docker, по умолчанию не ограничен, что при интенсивном журналировании может привести к исчерпанию дискового пространства на хосте. Поэтому в эксплуатационных средах политика ротации и ограничения размера журналов является обязательной мерой.
По умолчанию Docker использует драйвер json-file: каждая строка вывода записывается как JSON-объект в файл /var/lib/docker/containers/<id>/<id>-json.log на хосте, и без настройки файл растёт неограниченно 11. Ротация задаётся для отдельного контейнера ключами --log-opt или для всех новых контейнеров в /etc/docker/daemon.json:
docker run -d --log-opt max-size=10m --log-opt max-file=3 --name api demo:1.0
docker logs --since 5m --timestamps api
{
  "log-driver": "json-file",
  "log-opts": { "max-size": "10m", "max-file": "3" }
}
При таких параметрах журнал контейнера занимает не более 3 × 10 МБ = 30 МБ, а docker logs показывает только то, что осталось в этих файлах. Настройки daemon.json применяются к контейнерам, созданным после перезапуска демона; существующие контейнеры сохраняют прежние параметры.
Инспекция конфигурации контейнера
Команда docker inspect предоставляет детальную информацию о конфигурации контейнера: его параметрах запуска, сетевых настройках, подключённых томах, переменных окружения, состоянии и метаданных. Эта информация полезна для диагностики расхождений между ожидаемой и фактической конфигурацией. Например, если приложение не подключается к базе данных, инспекция может показать, что переменная окружения с адресом подключения содержит неверное значение или не задана.
Инспекция также позволяет проверить фактические ограничения ресурсов, назначенные контейнеру, его сетевой адрес в контейнерной сети, политику перезапуска и другие параметры, которые могли быть заданы при запуске. Это делает docker inspect инструментом верификации: инженер может убедиться, что контейнер запущен именно с теми параметрами, которые были запланированы.
Полный вывод docker inspect — JSON-документ на сотни строк, поэтому нужные поля извлекают шаблоном Go через --format. Сетевые адреса хранятся по сетям, к которым подключён контейнер, поэтому адрес получают перебором range, а не устаревшим полем верхнего уровня .NetworkSettings.IPAddress, которое в современных версиях Docker пусто или отсутствует:
docker inspect --format '{{.State.Status}} pid={{.State.Pid}} restarts={{.RestartCount}}' api
docker inspect --format '{{range $net, $cfg := .NetworkSettings.Networks}}{{$net}} {{$cfg.IPAddress}}{{end}}' api
docker inspect --format '{{json .Config.Env}}' api
docker inspect --format '{{.HostConfig.Memory}} {{.HostConfig.NanoCpus}} {{.HostConfig.RestartPolicy.Name}}' api
running pid=48213 restarts=0
bridge 172.17.0.2
["PORT=8000","PATH=/usr/local/bin:...","GREETING=..."]
134217728 500000000 on-failure
Поле .State.Pid — номер процесса с точки зрения хоста: внутри контейнера тот же процесс имеет PID 1. Ограничения хранятся в базовых единицах: память в байтах (128 МиБ = 134 217 728), процессор в миллиардных долях ядра (--cpus=0.5 = 500 000 000).
Выполнение команд внутри контейнера
Команда docker exec позволяет запустить дополнительный процесс внутри работающего контейнера. Чаще всего это интерактивная оболочка, с помощью которой можно исследовать файловую систему, проверить наличие файлов, просмотреть сетевую конфигурацию или выполнить диагностическую команду. Этот инструмент полезен при отладке и локализации проблем.
Однако использование docker exec требует осознанного подхода. Выполнение команд внутри контейнера допустимо как средство диагностики, но не должно становиться инструментом ручной модификации среды. Если инженер вручную устанавливает пакет, изменяет конфигурационный файл или перезапускает процесс внутри контейнера, эти изменения не отражаются в образе и будут потеряны при пересоздании контейнера. Такой подход противоречит принципу неизменяемой инфраструктуры, который рассматривается далее.
Мониторинг потребления ресурсов
Команда docker stats предоставляет информацию о текущем потреблении ресурсов контейнерами: использование процессора, оперативной памяти, сетевого ввода-вывода и дискового ввода-вывода. Эти данные полезны для оценки фактической нагрузки и обнаружения аномалий: утечек памяти, чрезмерного потребления процессора или неожиданной сетевой активности.
docker stats --no-stream api
CONTAINER ID   NAME   CPU %   MEM USAGE / LIMIT   MEM %    NET I/O         BLOCK I/O   PIDS
3b1f0c2d9e4a   api    0.02%   19.6MiB / 128MiB    15.31%   3.1kB / 2.4kB   0B / 0B     1
Значения берутся из счётчиков cgroup контейнера. Столбец LIMIT равен --memory, если лимит задан, и объёму памяти хоста (или ВМ Docker Desktop), если нет. MEM USAGE в cgroup v2 — это потребление памяти за вычетом неактивного файлового кэша, поэтому оно может расходиться с RSS процесса, который показывает ps.
Проверка работоспособности: HEALTHCHECK
Контейнер в состоянии running означает лишь, что PID 1 жив. Процесс может зависнуть, исчерпать пул соединений или потерять доступ к базе данных, оставаясь «работающим». Инструкция HEALTHCHECK задаёт команду, которую Docker периодически выполняет внутри контейнера: код 0 означает «здоров», код 1 — «нездоров» 3.
HEALTHCHECK --interval=10s --timeout=3s --start-period=5s --retries=3 \
    CMD ["python", "-c", "import urllib.request; urllib.request.urlopen('http://127.0.0.1:8000/', timeout=2)"]
Первая проверка выполняется через --interval после старта; неудачи в течение --start-period не учитываются; состояние unhealthy выставляется после --retries неудач подряд. Значения по умолчанию — 30 с, 30 с, 0 с и 3. Состояние видно в docker ps (Up 1 minute (healthy)) и подробно — в docker inspect:
docker inspect --format '{{.State.Health.Status}} {{.State.Health.FailingStreak}}' api
healthy 0
Важное ограничение: сам Docker Engine на состояние unhealthy не реагирует — не перезапускает контейнер и не убирает его из балансировки. Состояние используют внешние механизмы: Docker Compose ждёт healthy перед запуском зависимых сервисов (тема 6). Kubernetes инструкцию HEALTHCHECK игнорирует и использует собственные пробы livenessProbe и readinessProbe (тема 7). Команду проверки следует писать средствами, которые точно есть в образе: в python:3.12-slim нет curl, поэтому проверка выполнена интерпретатором Python.
На уровне единичного контейнера docker stats является инструментом оперативного наблюдения. Для систематического мониторинга, хранения истории метрик и настройки оповещений требуются внешние системы наблюдаемости, которые рассматриваются в теме, посвящённой безопасности и наблюдаемости контейнерных приложений.
Границы допустимого вмешательства
Инструменты инспекции и диагностики формируют важную дисциплинарную границу. Наблюдение за контейнером, чтение его журналов, проверка конфигурации и анализ потребления ресурсов — это нормальные эксплуатационные действия. Однако ручное изменение содержимого работающего контейнера, установка дополнительного программного обеспечения, модификация конфигурационных файлов внутри контейнера — это действия, нарушающие воспроизводимость среды и создающие расхождение между артефактом (образом) и реальным состоянием системы. Разграничение между допустимой диагностикой и нежелательной модификацией является одним из ключевых навыков инженера, работающего с контейнерами.
Неизменяемость среды и обновление приложений
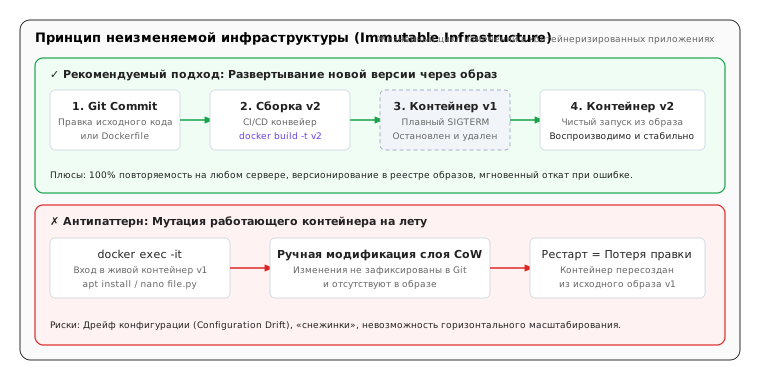
Контейнерная модель развёртывания основана на принципе неизменяемой инфраструктуры (immutable infrastructure). Этот принцип утверждает, что компоненты среды выполнения не модифицируются после создания. Вместо внесения изменений в работающий экземпляр создаётся новый экземпляр на основе обновлённого артефакта. Применительно к контейнерам это означает, что обновление приложения производится не путём изменения содержимого работающего контейнера, а путём пересборки образа и пересоздания контейнера.
Суть принципа неизменяемости
В традиционной модели эксплуатации серверов обновление приложения нередко выполнялось путём ручного копирования файлов, установки пакетов и изменения конфигурации на работающем сервере. Такой подход порождает ряд проблем. Состояние сервера постепенно отклоняется от первоначального описания (явление, известное как «дрейф конфигурации», configuration drift). Воспроизвести точное состояние системы на другом узле становится невозможно без детальной документации каждого выполненного действия. Откат к предыдущей версии затруднён, поскольку изменения накапливаются без формальной фиксации.
Принцип неизменяемости устраняет эти проблемы путём жёсткого разделения двух операций. Первая операция — конструирование артефакта (образа), которая выполняется один раз и фиксируется. Вторая операция — запуск экземпляра (контейнера) на основе этого артефакта. Если требуется изменение, создаётся новый артефакт, а прежний экземпляр заменяется новым. Контейнер не модифицируется; он заменяется.
Цикл обновления приложения
Корректный цикл обновления контейнерного приложения состоит из нескольких последовательных этапов. Сначала вносятся изменения в исходный код, конфигурацию сборки или зависимости приложения. Затем выполняется пересборка образа, в результате которой создаётся новый артефакт с обновлённым содержимым. После этого существующий контейнер останавливается, и на его месте создаётся новый контейнер на основе обновлённого образа.
Этот цикл обеспечивает несколько важных свойств. Во-первых, каждая версия приложения представлена конкретным образом с определённым тегом, что позволяет точно знать, какой артефакт развёрнут в данный момент. Во-вторых, откат к предыдущей версии сводится к запуску контейнера на основе прежнего образа. В-третьих, устраняется проблема дрейфа конфигурации, поскольку состояние контейнера определяется исключительно его образом и параметрами запуска.
Ошибки ручной модификации контейнера
Несмотря на ясность принципа неизменяемости, на практике возникает соблазн внести «быстрое исправление» непосредственно в работающий контейнер. Типичные примеры: ручная правка конфигурационного файла через docker exec, установка дополнительного пакета для решения текущей проблемы, изменение прав доступа к файлам внутри контейнера.
Такие действия создают несколько проблем. Изменение не зафиксировано в образе и будет потеряно при следующем пересоздании контейнера. Другие экземпляры, запущенные из того же образа, не получат данного изменения, что приведёт к несогласованности между средами. Откат к предыдущему состоянию невозможен, поскольку изменение не является частью управляемого жизненного цикла артефакта. Кроме того, ручные вмешательства затрудняют диагностику: если система ведёт себя иначе, чем ожидается на основании образа, инженер не может исключить, что причиной является незафиксированное ручное изменение.
Корректный подход требует возвращения к этапу сборки. Если в приложении обнаружена ошибка, она исправляется в исходном коде, образ пересобирается, и контейнер пересоздаётся. Если требуется изменение конфигурации, оно вносится в параметры запуска или конфигурационные файлы, передаваемые контейнеру извне. Этот подход может казаться более длительным, но именно он обеспечивает прослеживаемость, воспроизводимость и управляемость, которые составляют основу контейнерной модели эксплуатации.
Принцип неизменяемости можно не только соблюдать, но и обеспечить технически. Ключ --read-only монтирует корневую файловую систему контейнера только для чтения: слой записи не используется, и ни приложение, ни злоумышленник, получивший выполнение кода, не могут изменить файлы образа. Каталоги, куда приложению всё же нужно писать временные файлы, монтируются отдельно как tmpfs — файловая система в оперативной памяти 10:
docker run --rm --read-only python:3.12-slim touch /tmp/x
docker run --rm --read-only --tmpfs /tmp:size=16m python:3.12-slim sh -c 'touch /tmp/x && echo ok'
touch: cannot touch '/tmp/x': Read-only file system
ok
Попытка запустить так существующее приложение сразу показывает, куда оно пишет: каждый каталог, вызывающий ошибку, либо переносится в tmpfs (временные данные), либо в том (данные, которые нужно сохранить), либо означает ошибку проектирования. В Kubernetes тот же режим задаётся полем readOnlyRootFilesystem контекста безопасности (тема 11).
Границы применимости принципа неизменяемости
Принцип неизменяемости распространяется на программную среду контейнера, но не на все аспекты его работы. Данные, создаваемые приложением в процессе работы, по определению изменяются. Если приложение работает с базой данных, принимает загружаемые пользователями файлы или формирует кэш, эти данные не могут быть частью неизменяемого образа. Для их хранения используются тома и монтирование каталогов хоста, рассматриваемые в следующем разделе.
Таким образом, неизменяемость образа и контейнера не означает неизменяемости всех данных приложения. Она означает неизменяемость программной среды: исполняемых файлов, библиотек, конфигурации, встроенной в образ. Разделение между изменяемыми данными и неизменяемой средой является фундаментальным архитектурным решением, которое должно быть принято на этапе проектирования контейнерного приложения.
Docker-тома и монтирование каталогов хоста
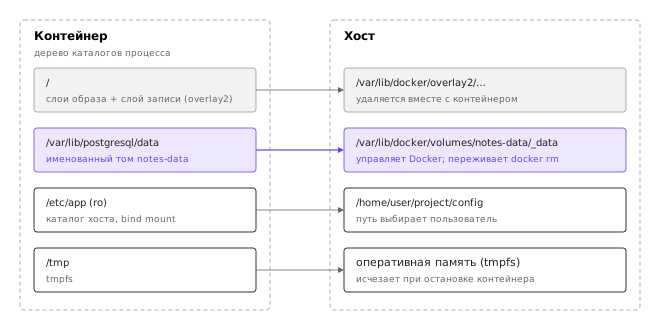
Как было показано в теме 3, всё, что процесс записывает в файловую систему контейнера, попадает в слой записи, а слой записи удаляется вместе с контейнером. Цикл обновления из предыдущего раздела удаляет контейнер при каждом выпуске новой версии, поэтому база данных, хранящая файлы в слое записи, теряла бы все данные при каждом обновлении. Кроме того, запись через overlay2 медленнее записи в обычную файловую систему: первое изменение файла из нижнего слоя копирует его целиком в слой записи. Docker предлагает три способа подключить к дереву каталогов контейнера хранилище, не связанное со слоем записи: именованный том, монтирование каталога хоста и tmpfs. Схема на рисунке ниже показывает, откуда берутся данные в каждом из трёх случаев.
Именованные тома
Том (англ. volume) — объект Docker со своим именем и жизненным циклом, независимым от контейнеров 8. Драйвер local, используемый по умолчанию, хранит данные тома в каталоге /var/lib/docker/volumes/<имя>/_data на хосте; в Docker Desktop этот каталог находится внутри служебной Linux-ВМ, а не в файловой системе macOS или Windows. Том подключается к контейнеру ключом -v имя:путь или, в более явной записи, --mount:
docker volume create notes-data
docker run -d --name db -v notes-data:/var/lib/postgresql/data \
    -e POSTGRES_PASSWORD=secret postgres:17
# эквивалентная запись
docker run -d --name db --mount type=volume,src=notes-data,dst=/var/lib/postgresql/data \
    -e POSTGRES_PASSWORD=secret postgres:17
docker volume inspect --format '{{.Mountpoint}}' notes-data
/var/lib/docker/volumes/notes-data/_data
Том переживает контейнер потому, что контейнер лишь ссылается на него по имени. Команда docker rm db удаляет слой записи контейнера, но не том; новый контейнер, запущенный с тем же -v notes-data:..., увидит те же файлы. Именно это позволяет обновлять базу данных заменой контейнера: образ postgres:17 заменяется новым выпуском, а данные остаются в томе. Удаляется том только явно:
docker volume ls
docker volume rm notes-data        # ошибка, если том подключён к существующему контейнеру
docker volume prune                # удаляет неиспользуемые анонимные тома
docker volume prune --all          # удаляет все неиспользуемые тома, включая именованные
Кроме именованных, бывают анонимные тома. Их создаёт инструкция VOLUME в Dockerfile или ключ -v с одним путём (-v /data); имя — случайная строка из 64 шестнадцатеричных символов. Анонимный том удаляется вместе с контейнером, если контейнер удалён с ключом -v или запущен с --rm, иначе он остаётся «сиротой» и занимает диск, пока его не удалит docker volume prune. Полезное свойство томов: если пустой том подключается к каталогу, в котором в образе уже есть файлы, Docker перед запуском копирует эти файлы в том вместе с владельцем и правами 8.
Монтирование каталогов хоста
Монтирование каталога хоста (англ. bind mount) делает видимым в контейнере произвольный каталог или файл хоста 9. Docker им не управляет: путь выбирает пользователь, данные лежат там, где лежали, и изменения видны одновременно с обеих сторон, потому что это один и тот же каталог.
docker run -d --name web -v "$PWD/site:/usr/share/nginx/html:ro" -p 8080:80 nginx:1.29
docker run -d --name web2 --mount type=bind,src="$PWD/site",dst=/usr/share/nginx/html,readonly -p 8081:80 nginx:1.29
Два синтаксиса ведут себя по-разному при отсутствии пути на хосте: -v молча создаёт пустой каталог, владельцем которого будет root, а --mount завершается ошибкой. Вторая реакция обычно полезнее: опечатка в пути обнаруживается сразу, а не превращается в пустой сайт. Монтирование закрывает собой содержимое образа по тому же пути — файлы образа в /usr/share/nginx/html в контейнере не видны, — и, в отличие от тома, ничего из образа в каталог хоста не копирует.
Монтирование каталогов хоста незаменимо при разработке (код правится на хосте, приложение в контейнере видит изменения без пересборки образа) и для передачи конфигурации. В эксплуатации оно делает контейнер зависимым от структуры каталогов конкретного хоста, а монтирование чувствительных путей (/, /etc, /var/run/docker.sock) с правами записи фактически даёт контейнеру управление хостом. На macOS и Windows каталог передаётся из хоста во ВМ Docker Desktop механизмом общего доступа к файлам, поэтому операции с множеством мелких файлов там заметно медленнее, чем в томе.
Права доступа и UID
Ядро проверяет права на файлы по числовым UID и GID, а имена пользователей существуют только в файлах /etc/passwd хоста и образа и могут не совпадать 12. Пространство имён пользователей Docker по умолчанию не использует, поэтому UID 1000 в контейнере — это UID 1000 на хосте. Отсюда типичная ошибка: образ запускает приложение как USER 10001 (тема 4), а каталог хоста принадлежит пользователю хоста с UID 1000 и правами 755:
mkdir -p data
docker run --rm --user 10001 -v "$PWD/data:/data" python:3.12-slim touch /data/x
touch: cannot touch '/data/x': Permission denied
Исправлений три, и выбор зависит от сценария. При разработке контейнер запускают с UID пользователя хоста: --user "$(id -u):$(id -g)". В эксплуатации каталог хоста передают во владение UID приложения (sudo chown 10001:10001 data). Для именованного тома достаточно в Dockerfile создать каталог точки монтирования с нужным владельцем (RUN mkdir /data && chown 10001:10001 /data): при первом подключении пустого тома Docker скопирует каталог вместе с владельцем. Ослаблять права до 777 не следует — это открывает каталог всем пользователям хоста.
Выбор способа хранения
| Свойство | Именованный том | Каталог хоста | tmpfs |
|---|---|---|---|
| Где лежат данные | /var/lib/docker/volumes/<имя>/_data, управляет Docker | любой путь хоста, выбирает пользователь | оперативная память хоста |
| Переживает удаление контейнера | да | да | нет, исчезает уже при остановке |
| Наполняется из образа | да, если том пуст | нет, закрывает содержимое образа | нет |
| Типичное применение | данные СУБД, загруженные файлы | исходный код при разработке, конфигурация | временные файлы, секреты, --read-only |
| Аналог в Kubernetes | PersistentVolumeClaim (тема 8) | hostPath (тема 8) | emptyDir с medium: Memory (тема 8) |
Том решает задачу сохранности данных при пересоздании контейнера, но только в пределах одного хоста: при отказе диска или переносе нагрузки на другой узел данные тома теряются или остаются недоступны. Резервное копирование тома выполняется вспомогательным контейнером, который подключает том и каталог хоста одновременно:
docker run --rm -v notes-data:/data:ro -v "$PWD:/backup" python:3.12-slim \
    tar czf /backup/notes-data.tgz -C /data .
Хранилище, независимое от узла, — сетевые тома, PersistentVolume и объектные хранилища — рассматривается в темах 8 и 10, а описание томов вместе с сервисами в одном файле — в теме 6, посвящённой Docker Compose.
Итоги темы
Управление контейнерами в среде выполнения является самостоятельной инженерной задачей, не сводимой к знанию команд запуска и остановки. Параметры запуска — переменные окружения, проброс портов, ограничения ресурсов и политика перезапуска — определяют поведение контейнера и должны задаваться осознанно, с учётом требований воспроизводимости и сопровождаемости.
Контейнер существует ровно столько, сколько работает его основной процесс. Понимание роли PID 1, механизма обработки сигналов и причин немедленного завершения контейнера позволяет избежать распространённых ошибок и проектировать приложения, корректно интегрированные с контейнерной средой.
Инструменты инспекции и диагностики — журналы, команды инспекции, выполнение команд внутри контейнера и мониторинг потребления ресурсов — обеспечивают наблюдаемость и контроль. Однако диагностика должна оставаться наблюдением, а не ручной модификацией: изменение содержимого работающего контейнера нарушает принцип неизменяемой инфраструктуры и создаёт неуправляемое расхождение между артефактом и реальным состоянием среды.
Изменяемые данные выносятся за пределы слоя записи. Именованный том — объект Docker с собственным жизненным циклом — переживает удаление контейнера и потому позволяет обновлять даже СУБД заменой контейнера; монтирование каталога хоста связывает контейнер с конкретным путём хоста и удобно при разработке; tmpfs даёт временное хранилище в памяти и вместе с --read-only делает неизменяемость технически обеспеченной. Во всех трёх случаях права проверяются по числовым UID, что связывает выбор пользователя в образе (тема 4) с владельцем данных на хосте.
Принцип неизменяемости связывает этап сборки образа с этапом эксплуатации контейнера. Обновление приложения выполняется через пересборку образа и пересоздание контейнера, а не через модификацию работающего экземпляра. Этот подход обеспечивает прослеживаемость версий, управляемый откат и согласованность между средами. Вместе с разделением изменяемых данных и неизменяемой программной среды он формирует основу для перехода к более сложным сценариям развёртывания: сетевому взаимодействию, хранению данных и композиции многоконтейнерных приложений.
Литература
- Docker Documentation. Running containers. — https://docs.docker.com/engine/containers/run/ (дата обращения: 22.10.2026).
- Docker Documentation. docker container run. — https://docs.docker.com/reference/cli/docker/container/run/ (дата обращения: 22.10.2026).
- Docker Documentation. Dockerfile reference. — https://docs.docker.com/reference/dockerfile/ (дата обращения: 22.10.2026).
- Docker Documentation. Start containers automatically. — https://docs.docker.com/engine/containers/start-containers-automatically/ (дата обращения: 22.10.2026).
- Docker Documentation. Resource constraints. — https://docs.docker.com/engine/containers/resource_constraints/ (дата обращения: 22.10.2026).
- signal(7) — Linux manual page. — https://man7.org/linux/man-pages/man7/signal.7.html (дата обращения: 22.10.2026).
- pid_namespaces(7) — Linux manual page. — https://man7.org/linux/man-pages/man7/pid_namespaces.7.html (дата обращения: 22.10.2026).
- Docker Documentation. Volumes. — https://docs.docker.com/engine/storage/volumes/ (дата обращения: 22.10.2026).
- Docker Documentation. Bind mounts. — https://docs.docker.com/engine/storage/bind-mounts/ (дата обращения: 22.10.2026).
- Docker Documentation. tmpfs mounts. — https://docs.docker.com/engine/storage/tmpfs/ (дата обращения: 22.10.2026).
- Docker Documentation. JSON File logging driver. — https://docs.docker.com/engine/logging/drivers/json-file/ (дата обращения: 22.10.2026).
- Rice L. Container Security: Fundamental Technology Concepts that Protect Containerized Applications. — O'Reilly Media, 2020.
- The Linux Kernel Documentation. Control Group v2. — https://docs.kernel.org/admin-guide/cgroup-v2.html (дата обращения: 22.10.2026).
- Wiggins A. The Twelve-Factor App. III. Config. — https://12factor.net/config (дата обращения: 22.10.2026).