
Сетевое взаимодействие контейнерных приложений
Предыдущие темы курса рассматривали контейнер как отдельный объект: сначала как воспроизводимый артефакт сборки, затем как управляемый процесс в среде выполнения. Однако реальные приложения почти никогда не сводятся к одному контейнеру. Веб-сервер обращается к базе данных, фоновая задача публикует сообщения в брокер очередей, шлюз проксирует запросы во внутренние сервисы. Все эти взаимодействия требуют сети — и устроены они в контейнерной среде иначе, чем в классической многопроцессной системе на одном хосте.
Сеть в контейнерной среде имеет двухуровневый характер. С одной стороны, сетевой стек контейнера изолирован от хоста средствами ядра операционной системы; контейнер не видит интерфейсов хоста и не может произвольно слушать его порты. С другой стороны, эта изоляция должна быть прозрачно «прорезана» в нужных местах: контейнеры должны находить друг друга по именам, а внешние клиенты — попадать в нужный контейнер через известный порт. Понимание того, как именно среда выполнения создаёт эти точки прозрачности, и составляет основное содержание темы.
Материал темы строится по схеме «от изоляции к публикации». Открывается тема кратким напоминанием базовых сетевых понятий, нужных дальше по тексту. Затем рассматривается, как устроено изолированное сетевое пространство контейнера и какие виртуальные интерфейсы обеспечивают его связь с внешним миром. Далее — как Docker предоставляет несколько режимов подключения (drivers) с разным компромиссом между изоляцией и удобством. После этого разбираются механизмы публикации сервисов наружу и обнаружения сервисов друг другом внутри одного хоста. Затем следует обзор типичных эксплуатационных рисков и ограничений локальной контейнерной сети. Завершает тему Docker Compose — декларативное описание многоконтейнерного приложения вместе с его сетями, томами и порядком запуска; его ограничения мотивируют переход к оркестрации в теме 7.
Минимальные сведения о компьютерных сетях
Дальнейший материал опирается на ряд понятий из курса компьютерных сетей. Глубокое их изложение выходит за пределы темы, но без короткого напоминания текст превратится в перечень терминов. Поэтому ниже собраны те и только те сведения, которые потребуются по ходу разбора контейнерной сетевой модели. Для более основательного знакомства с предметом в дополнительных материалах темы собраны глоссарий, шпаргалка по командам и аннотированный список источников, а сетевые пространства имён и виртуальные интерфейсы описаны в справочных страницах Linux 1112.
IP-адреса, подсети и сетевые интерфейсы
Каждое устройство, участвующее в сетевом обмене, идентифицируется IP-адресом (англ. Internet Protocol address). В курсе мы практически всегда имеем дело с адресами IPv4 — четыре десятичных числа, разделённые точками: например, 192.168.1.10. Адрес сам по себе не даёт полной информации о расположении узла; к нему нужна подсеть (англ. subnet) — диапазон адресов, считающихся «локальными». Подсеть задаётся длиной префикса в записи 192.168.1.0/24: первые 24 бита определяют сеть, оставшиеся 8 — конкретный узел в ней.
Подсеть нужна узлу, чтобы решить, как отправить пакет. Если адрес назначения попадает в локальную подсеть, пакет передаётся в неё напрямую, на канальном уровне. Если нет — пакет уходит через шлюз по умолчанию (англ. default gateway), специально настроенный узел, отвечающий за передачу пакетов в другие сети. Сопоставление «куда пойдёт пакет с данным адресом назначения» хранится в таблице маршрутизации (англ. routing table) узла; именно эту таблицу будет иметь свой экземпляр у каждого контейнера.
Связь узла с сетью реализуется через сетевой интерфейс (англ. network interface) — программную сущность, к которой привязан IP-адрес и через которую идут пакеты. Физическому Ethernet-порту обычно соответствует интерфейс eth0, петлевому интерфейсу — lo (адрес 127.0.0.1, видимый только изнутри узла). На одном узле может быть несколько интерфейсов; в контейнерной среде к этому добавятся виртуальные интерфейсы, создаваемые ядром по запросу.
Транспортные порты и сокеты
IP-адрес определяет узел, но не приложение. На одном узле обычно работают десятки сетевых процессов одновременно: веб-сервер, СУБД, агенты мониторинга. Чтобы пакет дошёл до нужного процесса, на транспортном уровне используется понятие порта (англ. port) — целое число от 1 до 65535. Сочетание «IP-адрес + порт» называется сокетом (англ. socket) и однозначно указывает конкретную точку обмена в сети.
Большинство сетевых соединений в курсе — это TCP-соединения (англ. Transmission Control Protocol): надёжный поток байтов с установлением и закрытием соединения. Реже встречается UDP (англ. User Datagram Protocol) — обмен отдельными пакетами без подтверждений, применяется, например, для DNS-запросов. На уровне работы с контейнерами различия между этими протоколами чаще всего не критичны; критично то, что приложение должно «слушать» (англ. listen) определённый порт, чтобы клиенты могли к нему подключиться.
Адрес, на котором приложение слушает, имеет значение. Привязка к 127.0.0.1 (петлевой интерфейс) делает порт доступным только локальным процессам узла. Привязка к конкретному IP-адресу одного из интерфейсов — только клиентам, идущим через этот интерфейс. Привязка к 0.0.0.0 означает «на всех интерфейсах»: порт доступен и локально, и снаружи. Различение этих режимов окажется важным при разборе публикации портов контейнеров.
Разрешение имён и трансляция адресов
Запоминать IP-адреса вручную неудобно, поэтому в реальных сетях работает разрешение имён через систему DNS (англ. Domain Name System). DNS — это иерархическая распределённая база данных, в которой именам узлов ставятся в соответствие их IP-адреса. Когда приложение обращается к имени db.example.com, операционная система отправляет DNS-запрос настроенному серверу имён и получает в ответ адрес. Параметры DNS на узле задаются файлом /etc/resolv.conf. Среда выполнения формирует этот файл для каждого контейнера сама, но по-разному в зависимости от сети. Контейнер в стандартной сети bridge получает копию настроек DNS хоста. Контейнер в пользовательской сети получает файл, указывающий на встроенный DNS-сервер Docker с адресом 127.0.0.11; этот сервер отвечает на имена контейнеров, а остальные запросы пересылает серверам хоста 1. Механизм разрешения имён при этом остаётся стандартным: приложение не знает, что работает в контейнере.
Второе понятие, неизбежное при разборе контейнерных сетей, — трансляция адресов NAT (англ. Network Address Translation). NAT — это техника, при которой узел-посредник переписывает заголовки проходящих пакетов: подменяет адрес источника, адрес назначения или оба. Самый частый сценарий — преобразование частных адресов локальной сети в один публичный адрес шлюза при выходе наружу; ответы шлюз возвращает в обратном направлении, восстанавливая исходный адрес. Среда выполнения Docker использует NAT для двух задач: чтобы наружу контейнер был виден под адресом хоста (исходящие соединения) и чтобы пакет с порта хоста попадал в нужный контейнер (опубликованные порты). Подробного знания механики NAT для темы не требуется; достаточно помнить, что трансляция выполняется в ядре хоста, прозрачно для приложения и не оставляет следов в самом контейнере.
Базовая модель «клиент — сервер» и фильтрация трафика
Большинство сетевых взаимодействий в курсе укладываются в модель «клиент — сервер»: серверный процесс заранее открыл сокет и ждёт подключений на известном порту, клиент устанавливает соединение по адресу и порту сервера, обменивается с ним сообщениями и закрывает соединение. Серверный процесс может одновременно обслуживать множество клиентов, каждое соединение различается своей четвёркой «адрес-порт клиента — адрес-порт сервера».
Помимо собственно передачи пакетов, в современных операционных системах действует межсетевой фильтр (англ. firewall) — подсистема ядра, проверяющая каждый пакет по заданным правилам. На Linux это netfilter, управляемый утилитами iptables или nft (подсистема nftables). Фильтр может пропускать, отбрасывать или модифицировать пакеты; именно через эти модификации реализуются и проброс портов, и NAT для исходящего трафика контейнеров. Помнить синтаксис правил наизусть не нужно — но важно понимать, что результаты команд docker run -p ... и docker network create ... наблюдаемы как изменения в межсетевом фильтре хоста, и при диагностике сетевых проблем именно туда стоит смотреть в первую очередь.
Сетевые пространства контейнеров
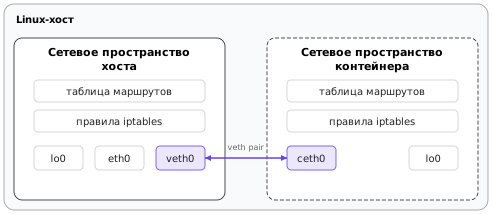
Сетевая изоляция контейнера — частный случай более общего механизма пространств имён (англ. namespaces), рассмотренного в теме 3 в разделе об изоляции контейнеров. Сетевое пространство имён (англ. network namespace) — это отдельный экземпляр сетевого стека ядра: собственный набор сетевых интерфейсов, своя таблица маршрутизации, свои правила фильтрации, своя таблица сокетов. Процессы, помещённые в одно сетевое пространство, видят только его интерфейсы; процессы хоста видят интерфейсы хоста; пересечения нет, пока его явно не настроить.
С практической точки зрения это означает, что внутри контейнера команда ip addr покажет только два интерфейса: локальную петлю lo и одно виртуальное Ethernet-устройство, через которое контейнер подключён к внешней сети. Никаких физических интерфейсов хоста, никаких других контейнеров в этом списке нет — даже если на хосте одновременно работают десятки контейнеров. Изоляция сетевого стека делает контейнер минимально похожим на отдельную виртуальную машину с точки зрения сетевой адресации, но при этом не требует виртуализации оборудования.
Убедиться в этом можно одной командой. Образ busybox содержит упрощённые версии утилит ip, ping, nslookup и wget, поэтому подходит для сетевых опытов:
docker run --rm busybox:1.37 sh -c 'ip addr; ip route'
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
...
2: eth0@if7: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue
    link/ether 6a:3e:51:0c:9d:12 brd ff:ff:ff:ff:ff:ff
    inet 172.17.0.2/16 scope global eth0
...
default via 172.17.0.1 dev eth0
172.17.0.0/16 dev eth0 scope link src 172.17.0.2
Вывод сокращён, номера интерфейсов и MAC-адрес у каждого запуска свои. Существенны три строки. Запись eth0@if7 означает, что интерфейс — один конец пары, второй конец которой имеет в другом пространстве имён индекс 7. Адрес 172.17.0.2/16 выделен из подсети стандартной сети Docker. Маршрут по умолчанию ведёт через 172.17.0.1 — адрес моста на стороне хоста. Каждое сетевое пространство имён имеет собственные интерфейсы, таблицы маршрутизации и правила netfilter, а физическое устройство может находиться только в одном из них 11.
Виртуальные интерфейсы и базовая модель подключения
Передача пакетов между изолированным пространством контейнера и сетью хоста реализуется через пару виртуальных интерфейсов (англ. veth pair). Это устройство, которое ведёт себя как двусторонний сетевой кабель: один его конец помещается в сетевое пространство контейнера, другой остаётся в пространстве хоста. Всё, что записывается в один конец, выходит из другого. Внутри контейнера этот конец обычно называется eth0; на хосте — имеет техническое имя вида vethXXXX и сам по себе для пользовательских задач не используется. Пары veth создаются всегда вдвоём, и типичное их применение — именно связь двух сетевых пространств имён; при удалении одного конца исчезает и второй 12.
Простое существование пары виртуальных интерфейсов ещё не делает контейнер достижимым по сети. Хостовый конец пары должен быть подключён к какой-либо коммутирующей структуре, через которую пакеты пойдут дальше. В стандартной конфигурации Docker эта структура — программный сетевой мост (англ. bridge) с именем docker0. Все хостовые концы пар veth от контейнеров одной мостовой сети подключены к этому мосту, что позволяет пакетам ходить между контейнерами и наружу через таблицу маршрутизации хоста.
Хостовую сторону той же картины показывают обычные утилиты iproute2. Команды выполняются на хосте с Docker Engine для Linux; у Docker Desktop мост находится внутри служебной виртуальной машины и с хоста не виден (об этом — в конце раздела о рисках):
ip -br link show type veth        # хостовые концы пар veth
ip -br link show master docker0   # какие из них подключены к мосту docker0
veth3f2a1b0@if2 UP 7a:78:e2:29:50:97 <BROADCAST,MULTICAST,UP,LOWER_UP>
Запись @if2 — зеркальная к eth0@if7 в контейнере: она указывает индекс парного интерфейса в чужом пространстве имён. Если запустить второй контейнер, на хосте появится вторая пара veth, подключённая к тому же мосту.
Маршрутизация в самом контейнере при этом устроена просто: задан адрес шлюза по умолчанию, совпадающий с адресом моста на стороне хоста. Любой пакет, не относящийся к локальной подсети контейнера, отправляется через этот шлюз и далее — обычными средствами хоста. Внешние ответы возвращаются по тому же пути, и Docker обеспечивает корректную трансляцию исходного адреса (англ. source NAT), чтобы внешним сервисам контейнер был виден под адресом хоста.
Внутренняя связность и внешний доступ — два разных вопроса
При работе с сетью контейнеров полезно с самого начала разделять два вопроса, которые часто смешивают. Первый: «могут ли два контейнера обращаться друг к другу?» Второй: «может ли клиент извне обратиться к контейнеру?» Ответы на них даются разными механизмами и регулируются разными настройками.
Внутренняя связность — это вопрос о том, какие контейнеры подключены к одной и той же сети и какие правила фильтрации между ними действуют. Если оба контейнера находятся в стандартной мостовой сети docker0, они могут обращаться друг к другу по IP-адресам, но не по именам — стандартный мост не предоставляет встроенного разрешения имён. Если же оба контейнера подключены к пользовательской сети, созданной командой docker network create, между ними автоматически работает встроенный DNS-сервис Docker, и они могут обращаться друг к другу по имени контейнера.
Внешний доступ — это вопрос о том, какие порты хоста проброшены в контейнер. Без явного проброса контейнер недоступен извне хоста, даже если он слушает порт 0.0.0.0:8080: адрес контейнера принадлежит внутренней подсети моста, маршрута к ней у других машин нет, а пакеты, адресованные прямо в контейнер не через мост, Docker отбрасывает 35. Оговорка «извне хоста» существенна. С самого хоста Docker Engine для Linux адрес контейнера достижим напрямую: команда curl http://172.17.0.2:8080 на хосте сработает без всякой публикации, потому что хост подключён к мосту и имеет адрес в его подсети. Контейнеры той же сети тоже обращаются друг к другу на любые порты 2. Эта на первый взгляд избыточная двухуровневая модель оказывается удобной в эксплуатации: она позволяет запустить десяток контейнеров, каждый из которых внутри слушает порт 8080, и не получить конфликта на хосте — наружу публикуется только то, что нужно, через явно выбранные порты.
Сетевые драйверы и режимы подключения
Конкретный способ организации сети для контейнера в Docker задаётся сетевым драйвером (англ. network driver). Драйвер — это реализация конкретной модели сетевого подключения; на одном хосте могут одновременно существовать сети нескольких типов, и каждый контейнер подключается к одной или нескольким из них. Базовая поставка Docker включает несколько встроенных драйверов; на практике в учебном курсе и в большинстве однохостовых сценариев достаточно двух из них — bridge и host.
Мостовая сеть как основной режим
Драйвер bridge — стандартный сетевой режим Docker. Именно он используется по умолчанию, если при запуске контейнера не указано иное. Для контейнеров создаётся изолированное сетевое пространство, в нём — интерфейс eth0, подключённый через пару veth к программному мосту в пространстве хоста. Этот мост действует как ethernet-коммутатор второго уровня: пакеты между контейнерами одной мостовой сети передаются напрямую, без участия таблицы маршрутизации хоста.
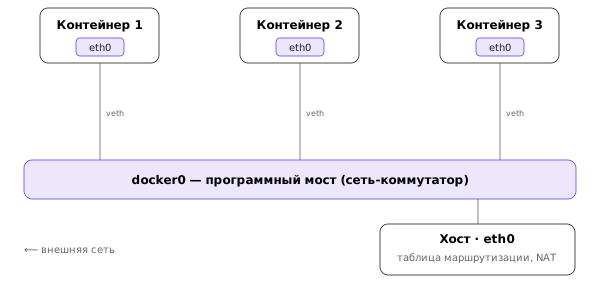
Стандартный мост docker0 создаётся автоматически при установке Docker, к нему подключаются все контейнеры, для которых явно не указана сеть. Однако опираться на него для прикладных задач не рекомендуется. Как уже было отмечено, он не предоставляет разрешения имён, что вынуждает разработчиков жёстко прописывать IP-адреса и сильно усложняет воспроизводимость окружения. Вместо этого следует создавать пользовательскую мостовую сеть командой docker network create my-net. С точки зрения пакетной коммутации она устроена так же, как стандартный мост, но дополнительно включает встроенный DNS-сервер: каждый контейнер этой сети доступен другим её участникам по имени, заданному при запуске.
Сразу после установки Docker существуют три сети: стандартный мост и две служебные сети для режимов host и none. Пользовательская сеть создаётся одной командой; подсеть можно задать явно или доверить выбор Docker:
docker network ls
docker network create --subnet 10.61.0.0/24 app-net
docker network inspect app-net
NETWORK ID     NAME      DRIVER    SCOPE
88f196238a4b   bridge    bridge    local
bb3a8fd98017   host      host      local
f4c1bb9a58ee   none      null      local
[
    {
        "Name": "app-net",
        "Driver": "bridge",
        "EnableIPv4": true,
        "EnableIPv6": false,
        "IPAM": {
            "Driver": "default",
            "Config": [
                {
                    "Subnet": "10.61.0.0/24",
                    "Gateway": "10.61.0.1"
                }
            ]
        },
        "Internal": false,
        "Containers": {},
        ...
    }
]
Поле Gateway — адрес, который Docker назначает мосту на стороне хоста; он же становится маршрутом по умолчанию в контейнерах этой сети. Поле Internal будет важно в разделе о Compose: внутренняя сеть не получает выхода наружу. Мост пользовательской сети называется на хосте br- плюс первые 12 символов идентификатора сети, поэтому его легко найти командой ip -br link show type bridge.
Пользовательские сети также удобны для логического разделения групп связанных контейнеров. На одном хосте могут одновременно существовать несколько таких сетей. Каждая сеть — отдельный мост, то есть отдельный сегмент канального уровня, но одного этого для изоляции недостаточно: мосты соединены через стек хоста, в котором Docker включает пересылку пакетов (net.ipv4.ip_forward=1), и без дополнительных правил хост пересылал бы пакеты из одной подсети в другую как обычный маршрутизатор. Межсетевую изоляцию обеспечивают правила фильтрации, которые Docker добавляет в netfilter хоста. До версии Docker Engine 28 включительно это были цепочки DOCKER-ISOLATION-STAGE-1 и DOCKER-ISOLATION-STAGE-2; в версии 29 они удалены, и ту же роль играет правило вида ! -i br-… -o br-… -j DROP в цепочке DOCKER: пакет, входящий в мост сети не из неё самой и не к опубликованному порту, отбрасывается 57. Это даёт минимальную, но рабочую модель сетевой сегментации — она не заменяет полноценные сетевые политики оркестратора (тема 11), но позволяет разделить, например, фронтальную часть приложения и внутренние сервисы на двух разных мостах.
Контейнер может состоять в нескольких сетях одновременно; для этого его подключают к дополнительной сети командой docker network connect и отключают командой docker network disconnect, не перезапуская 2:
docker network connect app-net web     # у контейнера web появится второй интерфейс eth1
docker exec web ip -4 addr             # eth0 — в прежней сети, eth1 — в app-net
docker network disconnect app-net web
Именно так устроен «шлюз» между двумя сетями: один контейнер с интерфейсами в обеих. Пересылки пакетов между этими интерфейсами внутри контейнера нет — контейнер не маршрутизатор, он лишь принимает соединения из одной сети и сам открывает соединения в другую.
Режим хоста и особые драйверы
Драйвер host принципиально отличается от мостового. Контейнер, запущенный в этом режиме, не получает собственного сетевого пространства имён: он использует сетевой стек хоста напрямую. С точки зрения сети это означает, что приложение внутри контейнера слушает порты хоста так же, как обычный процесс — без проброса, без NAT, без дополнительных интерфейсов.
Режим host имеет ограниченную область применения. С одной стороны, он минимизирует сетевую нагрузку: пакеты не проходят через дополнительный мост и не подвергаются трансляции адресов, что бывает заметно для приложений с высокой пропускной способностью. С другой стороны, он полностью устраняет сетевую изоляцию контейнера: контейнер видит все интерфейсы хоста, может слушать любой порт и потенциально конфликтовать с другими процессами хоста. На одном хосте нельзя запустить два контейнера в режиме host, оба слушающих один и тот же порт. По этим причинам режим host используется в качестве оптимизации в специфических случаях, а не как режим общего назначения.
Помимо bridge и host, среда Docker предоставляет несколько специализированных драйверов: none (полное отсутствие сети, для контейнеров вспомогательных задач), macvlan и ipvlan (для случаев, когда контейнеру нужен собственный MAC- или IP-адрес в физической сети), overlay (для распределённых развёртываний на нескольких хостах в режиме Docker Swarm). В курсе они подробно не рассматриваются. macvlan и ipvlan решают узкую задачу включения контейнера прямо в физическую сеть и нужны редко. overlay и сам Docker Swarm в курсе не изучаются вовсе: многохостовая сеть контейнеров рассматривается на примере Kubernetes, у которого собственная сетевая модель (тема 7). Сводка драйверов приведена в таблице 12.
| Драйвер | Сетевое пространство контейнера | Связь с внешней сетью | Типичное применение |
|---|---|---|---|
bridge (стандартный docker0) | собственное, veth к мосту | NAT и публикация портов | одиночные контейнеры по умолчанию; имён нет |
bridge (пользовательская сеть) | собственное, veth к мосту br-… | NAT и публикация портов; при --internal — никакой | группы связанных контейнеров, Compose; есть DNS по именам |
host | общее с хостом | напрямую, без NAT | сетевые агенты и мониторинг, предельная производительность |
none | собственное, только lo | нет | пакетные задачи без сети, максимальная изоляция |
macvlan | собственное, свой MAC в физической сети | напрямую через родительский интерфейс | контейнер как отдельный узел LAN |
ipvlan | собственное, общий MAC родителя | напрямую, режимы L2 и L3 | как macvlan, когда число MAC-адресов на порту ограничено |
overlay | собственное, туннель VXLAN между хостами | через шлюз хоста | Docker Swarm; в курсе не изучается |
Правила netfilter Docker создаёт только для мостовых сетей; для macvlan, ipvlan и host их нет 4, поэтому разобранные ниже публикация портов и межсетевая изоляция относятся к драйверу bridge.
Общий сетевой стек нескольких контейнеров
Помимо драйверов, есть ещё один режим подключения, который легко пропустить, хотя он важен для понимания следующей темы. Ключ --network container:<имя> помещает новый контейнер в сетевое пространство имён уже работающего контейнера 1. Собственного интерфейса, адреса и таблицы маршрутизации новый контейнер не получает — он видит те же lo и eth0, что и первый, и может обращаться к его процессам по адресу 127.0.0.1:
docker run -d --name app busybox:1.37 httpd -f -p 8080 -h /etc
docker run --rm --network container:app busybox:1.37 wget -qO- http://127.0.0.1:8080/hostname
docker run --rm --network container:app busybox:1.37 ip -4 addr   # те же адреса, что у app
Пространства имён PID и точек монтирования у контейнеров остаются раздельными: второй контейнер не видит процессов первого и имеет свою корневую файловую систему. Общим становится только сетевой стек, а с ним и пространство портов: два процесса в таких контейнерах не могут одновременно слушать один и тот же порт. Ключи -p, --dns, --hostname для такого контейнера не допускаются — всё это свойства общего стека, и задаются они у первого контейнера 1.
Ровно так устроен Pod в Kubernetes: несколько контейнеров одного пода разделяют сетевое пространство имён, общаются через localhost и имеют один IP-адрес на всех. Технически пространство имён удерживает служебный контейнер pause, а прикладные контейнеры подключаются к нему тем же механизмом, что и --network container:. Подробно модель пода разбирается в теме 7; в Compose тот же режим записывается как network_mode: "service:<имя>".
Публикация сервисов и межконтейнерное взаимодействие
Создание сети и подключение к ней контейнеров — только первая часть задачи. Прикладной смысл сети раскрывается через два конкретных механизма: публикацию сервисов наружу и обнаружение сервисов внутри сети.
Проброс портов и публикация наружу
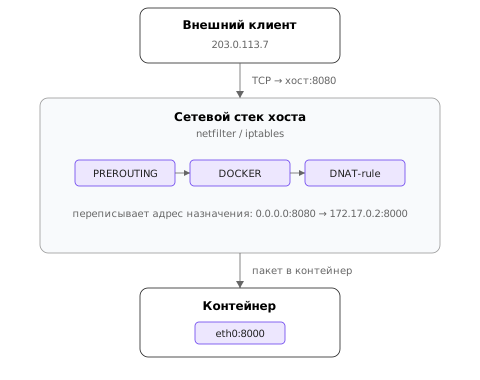
Проброс портов (англ. port mapping или port publishing) — основной способ сделать сервис, работающий в контейнере, доступным внешним клиентам. При запуске контейнера ключом -p HOST_PORT:CONTAINER_PORT указывается соответствие между портом хостовой машины и портом внутри контейнера. Среда выполнения настраивает правила трансляции в межсетевом фильтре хоста; внешний пакет, пришедший на указанный порт хоста, перенаправляется на указанный порт контейнера. Обратный путь обеспечивается стандартными механизмами трансляции состояний.
При выборе порта на стороне хоста часто возникает соблазн использовать тот же номер, что и внутри контейнера. Это удобно для разработки, но создаёт неявные ограничения в эксплуатации: на одном хосте нельзя запустить два контейнера, публикующих один и тот же хостовый порт. По этой причине в реальных конфигурациях номер хостового порта обычно либо выбирается осознанно из выделенного диапазона, либо поручается среде выполнения. Для этого хостовый порт просто не указывают: -p 8000 публикует порт 8000 контейнера на свободном порту хоста, а ключ -P (--publish-all) делает то же для всех портов, объявленных инструкцией EXPOSE. Порт выбирается из эфемерного диапазона, заданного в /proc/sys/net/ipv4/ip_local_port_range 3. Узнать, какой порт достался контейнеру, можно командой docker port:
docker run -d --name web -p 8000 python:3.12-alpine python -m http.server 8000
docker port web
8000/tcp -> 0.0.0.0:32768
8000/tcp -> [::]:32768
Две строки появились потому, что без явного адреса порт публикуется на всех адресах хоста — и IPv4, и IPv6 2. Номер 32768 — начало эфемерного диапазона в Linux по умолчанию (32768–60999); у читателя он может быть другим.
Сама публикация состоит из двух механизмов. Первый — правило DNAT в таблице nat межсетевого фильтра: пакет, пришедший на адрес хоста и опубликованный порт, получает новый адрес назначения — адрес и порт контейнера. Второй — процесс docker-proxy, так называемый userland-proxy: для каждого опубликованного порта Docker запускает небольшой прокси, который слушает этот порт на хосте и пересылает соединения в контейнер 3. Прокси нужен прежде всего для соединений с самого хоста на 127.0.0.1: такие пакеты порождаются локально и проходят не цепочку PREROUTING, а цепочку OUTPUT, где Docker не применяет DNAT к адресам 127.0.0.0/8 — перенаправить петлевой пакет на внешний адрес ядро без особой настройки не позволяет. Поэтому команда ss -ltnp на хосте покажет, что опубликованный порт «слушает» docker-proxy, хотя внешние соединения до него не доходят — их раньше перехватывает DNAT. Прокси можно отключить параметром демона "userland-proxy": false; тогда Docker обслуживает и петлевой трафик правилами netfilter. Одно наблюдаемое следствие стоит запомнить: соединение, пришедшее через docker-proxy, контейнер видит с адреса шлюза моста, а соединение, прошедшее DNAT, — с настоящего адреса клиента.
Как выглядят правила, видно в таблице nat. Пусть контейнер с адресом 172.18.0.2 в пользовательской сети с мостом br-5c1e2a7d9f30 запущен с ключом -p 8080:80. На хосте с бэкендом iptables (вариант по умолчанию, см. раздел о рисках) правила выводятся так:
sudo iptables -t nat -S DOCKER     # то же в виде таблицы: sudo iptables -t nat -L DOCKER -n
sudo iptables -S DOCKER
-N DOCKER
-A DOCKER ! -i br-5c1e2a7d9f30 -p tcp -m tcp --dport 8080 -j DNAT --to-destination 172.18.0.2:80
-N DOCKER
-A DOCKER -d 172.18.0.2/32 ! -i br-5c1e2a7d9f30 -o br-5c1e2a7d9f30 -p tcp -m tcp --dport 80 -j ACCEPT
-A DOCKER ! -i docker0 -o docker0 -j DROP
-A DOCKER ! -i br-5c1e2a7d9f30 -o br-5c1e2a7d9f30 -j DROP
Первая команда показывает правило трансляции: всё, что пришло не из самого моста на TCP-порт 8080 адреса хоста, направляется на 172.18.0.2:80. Вторая — фильтрующие правила той же цепочки в таблице filter: пропустить в мост пакеты к опубликованному порту контейнера и отбросить всё остальное, что входит в мост извне. Последнее правило — то самое, что изолирует сети друг от друга. Состав и порядок цепочек Docker не является стабильным интерфейсом и меняется между версиями; приведённый вывод соответствует Docker Engine 29 5.
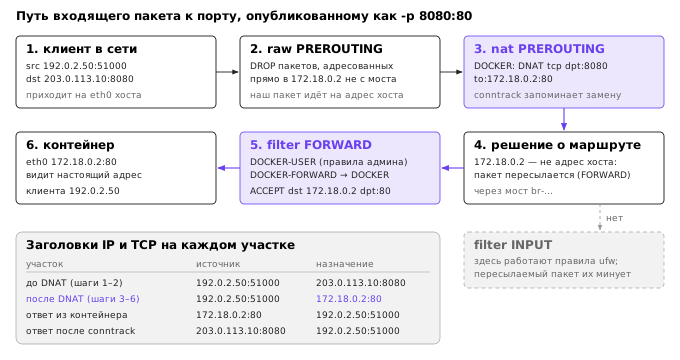
Разберём путь одного соединения с конкретными числами (рисунок ниже). Клиент 192.0.2.50 открывает соединение со своего порта 51000 на адрес хоста 203.0.113.10, порт 8080. Пакет приходит на внешний интерфейс хоста и проходит цепочку PREROUTING таблицы raw, где Docker отбрасывает пакеты, адресованные прямо в 172.18.0.2 откуда-либо, кроме моста; наш пакет адресован хосту и проходит дальше. В цепочке PREROUTING таблицы nat срабатывает DNAT: адрес назначения 203.0.113.10:8080 заменяется на 172.18.0.2:80, а подсистема отслеживания соединений conntrack запоминает эту замену для всего соединения. Теперь адрес назначения не принадлежит хосту, поэтому ядро не передаёт пакет локальным процессам через цепочку INPUT, а пересылает его через цепочку FORWARD. В ней пакет проходит DOCKER-USER, затем DOCKER-FORWARD и попадает под правило ACCEPT цепочки DOCKER, после чего через мост и пару veth доставляется в контейнер. Адрес источника не меняется: приложение в контейнере видит клиента 192.0.2.50:51000. Ответ из контейнера идёт с 172.18.0.2:80 на 192.0.2.50:51000, и conntrack выполняет обратную замену: клиент получает ответ от 203.0.113.10:8080, то есть ровно от того адреса, к которому подключался.
Полезно ясно различать инструкцию EXPOSE в Dockerfile и фактический проброс портов при запуске. EXPOSE — это документация намерения: она сообщает, какие порты приложение собирается слушать, но сама по себе не открывает доступ извне. Реальная публикация формируется только в момент запуска контейнера и определяется параметрами docker run или эквивалентной конфигурацией оркестратора. Смешение этих двух понятий — частый источник недоразумений: кажется, что приложение должно быть доступно, потому что в Dockerfile есть EXPOSE 8080, а на самом деле никакого проброса не выполнено. Единственное место, где EXPOSE влияет на публикацию, — ключ -P: он публикует именно объявленные порты.
Имена сервисов и встроенное разрешение имён
Внутри пользовательской сети Docker контейнеры обращаются друг к другу не по IP-адресам, а по именам. Среда выполнения поднимает встроенный DNS-сервер; в каждом контейнере, подключённом к пользовательской сети, файл /etc/resolv.conf указывает на этот сервер. Когда приложение в контейнере web обращается к адресу db, DNS-запрос разрешается во внутренний IP-адрес контейнера db в той же сети.
Разницу между сетями видно прямо в файле /etc/resolv.conf. В стандартной сети контейнер получает копию настроек хоста (на хосте с systemd-resolved — адреса настоящих серверов, а не петлевой 127.0.0.53, недоступный из контейнера); в пользовательской сети — адрес встроенного сервера 1:
docker run --rm busybox:1.37 cat /etc/resolv.conf                    # стандартная сеть bridge
docker run --rm --network app-net busybox:1.37 cat /etc/resolv.conf  # пользовательская сеть
# стандартная сеть: копия настроек хоста
nameserver 192.168.1.1
...
# пользовательская сеть: встроенный DNS Docker
nameserver 127.0.0.11
options ndots:0
...
Адрес 127.0.0.11 принадлежит петлевому интерфейсу самого контейнера, поэтому сервер имён не может быть «где-то в сети». Docker добавляет в сетевое пространство имён контейнера правила netfilter, которые перенаправляют запросы с 127.0.0.11:53 на сокет, открытый демоном Docker внутри этого же пространства имён на произвольном порту 5. Этот сервер отвечает на имена контейнеров и их псевдонимов в тех сетях, к которым подключён спрашивающий контейнер, а прочие имена пересылает серверам DNS хоста 1. Отсюда важное следствие: имя другого контейнера разрешается только при наличии общей пользовательской сети. Для контейнера в другой сети имя db не существует, и обращение к нему завершится ошибкой разрешения имени ещё до попытки соединения.
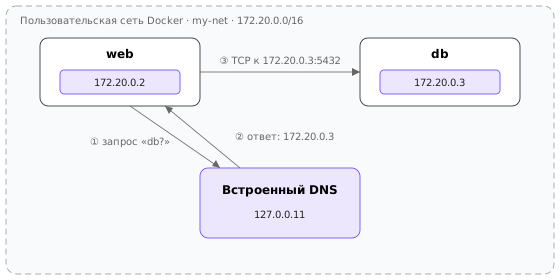
С точки зрения архитектуры приложения это даёт важное свойство: имена сервисов фиксируются в конфигурации приложения, а конкретные адреса — нет. Если контейнер пересоздан и получил другой IP-адрес, имя осталось тем же, и приложение продолжит работать без правок. Это первый шаг от модели «сервер с фиксированным IP» к модели «сервис с устойчивым именем», которая в полной мере раскрывается в оркестраторе.
Стандартный мост docker0 встроенного DNS не имеет; для разрешения имён необходимо явно создать пользовательскую сеть. По этой причине рекомендация «не использовать стандартный мост в прикладных конфигурациях» имеет не стилистический, а практический характер: только пользовательская сеть даёт устойчивое именование, а значит — переносимую конфигурацию приложения.
Разделение фронтальной и внутренней связности
Типичная многосервисная конфигурация на одном хосте требует разделения сетевых ролей. Часть сервисов обслуживает внешних клиентов (фронтальный веб-сервер, API-шлюз) — они публикуют порты наружу. Другая часть работает только во внутренней сети приложения (база данных, очередь сообщений, кеш) — наружу они не публикуются принципиально и должны быть недоступны для прямых внешних обращений.
Простейший способ обеспечить это разделение — две пользовательские сети: одна, в которой находятся фронтальные сервисы и шлюз, и вторая, к которой подключены шлюз и внутренние сервисы. Шлюз присутствует в обеих сетях; внутренние сервисы видят его, но не видят фронтального трафика напрямую. Такая структура — базовый сетевой шаблон контейнерных приложений: «опубликовать минимум, оставить остальное во внутреннем периметре». Декларативное описание подобной топологии естественным образом ложится в формат Docker Compose; полный пример такого приложения с двумя сетями разобран в разделе «Docker Compose» в конце темы.
Сетевые риски и эксплуатационные ограничения
Сетевая модель Docker удобна и компактна, но именно её простота создаёт несколько типичных эксплуатационных рисков. Они проявляются не в учебных сценариях, а на этапе сопровождения, когда конфигурация переходит из рук разработчика в эксплуатацию.
Первый и наиболее распространённый риск — избыточная сетевая открытость. Привычка публиковать порт «на всякий случай» приводит к тому, что внутренние сервисы — базы данных, административные интерфейсы, отладочные эндпоинты — оказываются доступны извне. На рабочей машине разработчика это незаметно, но при переносе конфигурации на сервер с публичным сетевым адресом ошибка превращается в открытую дверь. Правило здесь простое: публиковаться наружу должны только порты, действительно нужные внешним клиентам; всё остальное должно оставаться во внутренней пользовательской сети.
Второй риск связан с используемым адресом привязки на стороне хоста. По умолчанию -p 8080:8080 биндится на адрес 0.0.0.0, то есть на все интерфейсы хоста, включая внешние. Если требуется ограничить публикацию только локальной машиной, привязку нужно делать явно: -p 127.0.0.1:8080:8080. Это типовая ошибка при работе с серверами, имеющими несколько сетевых интерфейсов: разработчик считает, что сервис «слушает локально», а на деле он слушает все интерфейсы. Ошибку усугубляет то, что межсетевой экран хоста от неё не защищает: опубликованные порты обходят правила ufw (подробно — в подразделе об обходе межсетевого экрана ниже).
Третье ограничение — пределы локальной сетевой модели. Стандартные сети Docker (мостовые и пользовательские) работают в пределах одного хоста. Если приложение нужно распределить по нескольким хостам, эти средства уже недостаточны: требуются либо специализированные драйверы вроде overlay в режиме Docker Swarm (в курсе не изучаются), либо переход к оркестратору с собственной сетевой моделью — этот путь и выбран в теме 7. Локальная контейнерная сеть удобна для разработки, тестирования и одно-узловой эксплуатации; при выходе за этот сценарий она перестаёт быть достаточной, и попытки обойти ограничение «вручную» обычно приводят к хрупким конфигурациям.
Наконец, в эксплуатации значимым становится документирование сетевых зависимостей между сервисами. В контейнерной среде эти зависимости естественным образом скрыты внутри частных сетей, и их легко потерять из виду. Какой сервис обращается к какому, на каких портах, по какой сети — всё это должно быть явно зафиксировано в декларативном описании приложения и в эксплуатационной документации. Без такой фиксации диагностика проблем превращается в реверс-инжиниринг: при сетевом сбое непонятно, какой компонент чего ждал и где именно разорвалось соединение.
Опубликованные порты в обход межсетевого экрана хоста
Самый неожиданный для администратора риск связан с тем, как публикация портов встроена в netfilter. Типичная настройка сервера на Ubuntu — ufw с политикой «запретить все входящие, кроме SSH». Администратор публикует контейнер с базой данных ключом -p 5432:5432, проверяет sudo ufw status, видит, что порт 5432 не разрешён, и считает базу закрытой. Однако база доступна из Интернета.
Причина видна на рисунке с путём пакета выше. Правила ufw живут в цепочке INPUT таблицы filter — она применяется к пакетам, адресованным локальным процессам хоста. Пакет к опубликованному порту ещё в PREROUTING получает DNAT на адрес контейнера, после чего он адресован уже не хосту, а пересылается в мост через цепочку FORWARD. До цепочки INPUT он не доходит, и правила ufw к нему не применяются 4. Документация Docker прямо называет Docker и ufw несовместимыми в этом отношении. Вывод ss -ltnp, где порт «слушает» docker-proxy, только усиливает иллюзию: кажется, что это обычный локальный сокет, на который распространяется ufw.
Защиту выстраивают на трёх уровнях. Первый и главный — не публиковать лишнего: внутренним сервисам порты не нужны, они доступны соседям по пользовательской сети. Второй — привязка к адресу: -p 127.0.0.1:8080:80 публикует порт только на петлевом интерфейсе, и Docker начиная с версии 28 дополнительно отбрасывает в raw PREROUTING пакеты к такому порту, пришедшие не с lo; до версии 28 соседние узлы того же сегмента L2 могли достучаться и до порта, опубликованного на 127.0.0.1 3. Адрес привязки по умолчанию можно сменить для сети целиком опцией com.docker.network.bridge.host_binding_ipv4. Третий — собственные правила фильтрации в цепочке DOCKER-USER, которую Docker создаёт пустой и вызывает из FORWARD раньше своих правил 5. Например, разрешить доступ к опубликованным портам только из локальной сети 192.168.1.0/24 через внешний интерфейс eth0:
sudo iptables -I DOCKER-USER -i eth0 ! -s 192.168.1.0/24 -j DROP
sudo iptables -I DOCKER-USER -m conntrack --ctstate RELATED,ESTABLISHED -j ACCEPT
Второе правило вставляется выше первого и пропускает ответы на соединения, которые контейнеры открыли сами. Следует учитывать, что в DOCKER-USER пакет приходит уже после DNAT: условия на порт должны указывать порт контейнера, а не хоста, либо использовать расширение conntrack с параметром --ctorigdstport 5. Docker не сохраняет правила DOCKER-USER между перезагрузками хоста: их сохраняют теми же средствами, что и прочие правила iptables, например пакетом iptables-persistent.
Правила Docker в netfilter: iptables и nftables
Docker Engine создаёт свои правила через один из двух бэкендов, выбираемых параметром демона firewall-backend 4. По умолчанию это iptables: цепочки DOCKER, DOCKER-USER, DOCKER-FORWARD, DOCKER-BRIDGE, DOCKER-CT, DOCKER-INTERNAL в таблице filter, цепочка DOCKER в таблице nat и правила в таблице raw 5. В Ubuntu 24.04 команда iptables по умолчанию сама является надстройкой над nftables (вариант iptables-nft), поэтому те же правила видны и в выводе sudo nft list ruleset — как таблицы ip filter, ip nat, ip raw с цепочками, названными по-iptables-овски.
С версии 29.0 у Docker есть и собственный бэкенд nftables, включаемый строкой "firewall-backend": "nftables" в /etc/docker/daemon.json. На момент написания он объявлен экспериментальным: его поведение может меняться, а в режиме Swarm он не работает 6. Правила при этом сосредоточены в таблицах ip docker-bridges и ip6 docker-bridges, по набору цепочек на каждую сеть. Фрагмент для контейнера 192.0.2.2, опубликованного с ключом -p 8080:80 в сети с мостом bridge1, выглядит так (пример из внутренней документации проекта moby, на которую ссылается 6):
sudo nft list table ip docker-bridges
table ip docker-bridges {
	...
	chain nat-prerouting-and-output {
		iifname != "bridge1" tcp dport 8080 counter dnat to 192.0.2.2:80 comment "DNAT"
	}
	chain raw-PREROUTING {
		type filter hook prerouting priority raw; policy accept;
		ip daddr 192.0.2.2 iifname != "bridge1" counter drop comment "DROP DIRECT ACCESS"
	}
	chain filter-forward-in__bridge1 {
		ct state established,related counter accept
		iifname "bridge1" counter accept comment "ICC"
		ip daddr 192.0.2.2 tcp dport 80 counter accept
		counter drop comment "UNPUBLISHED PORT DROP"
	}
	...
}
Логика та же — DNAT, запрет прямого доступа, разрешение опубликованного порта, отбрасывание остального, — но выражена в терминах nftables. Есть и практические отличия. Цепочки DOCKER-USER в бэкенде nftables нет: собственные правила кладут в отдельную таблицу с базовой цепочкой на нужном хуке и приоритете. Правило accept в nftables не окончательно — пакет, принятый в одной базовой цепочке, может быть отброшен в другой, поэтому «разрешающие» правила в обход Docker делаются через метку пакета и параметр --bridge-accept-fwmark. Наконец, с бэкендом nftables Docker сам не включает пересылку пакетов в ядре и не ставит политику DROP для пересылки, и об этой защите хоста администратор заботится сам 6. В этом курсе используется бэкенд по умолчанию, iptables.
Особенности IPv6 и Docker Desktop
IPv6 в пользовательской сети включается ключом docker network create --ipv6 (в Compose — enable_ipv6: true у сети). Подсеть IPv6 можно указать явно или поручить выбор Docker. Для IPv6 Docker создаёт те же правила, что и для IPv4, через ip6tables. Даже в сети без IPv6 порт, опубликованный без указания адреса, по умолчанию слушается и на IPv6-адресах хоста: через docker-proxy соединение на IPv6-адрес хоста доставляется на IPv4-адрес контейнера 3. Поэтому -p 0.0.0.0:8080:80 и -p 8080:80 — не одно и то же: первый вариант публикует порт только для IPv4. Отдельно стоит режим шлюза routed, в котором NAT не используется вовсе и контейнеры доступны по своим адресам; он рассчитан прежде всего на IPv6 с маршрутизируемыми адресами 3.
Docker Desktop для macOS и Windows, а также Docker Desktop для Linux запускают Docker Engine внутри служебной виртуальной машины (тема 3). Всё сказанное в теме о мостах, veth и правилах netfilter верно, но происходит внутри этой машины. Отсюда наблюдаемые отличия 10. На хосте нет интерфейса docker0, и команды ip link, iptables, nft на хосте правил Docker не покажут. IP-адреса контейнеров с хоста недоступны: Docker Desktop не маршрутизирует трафик к Linux-контейнерам, поэтому единственный путь к ним — опубликованные порты. Опубликованный порт слушает на хосте процесс Docker Desktop, пересылающий соединения в виртуальную машину; именно к этому процессу и применяются правила межсетевого экрана хоста. Наконец, из контейнера хост доступен по имени host.docker.internal. Эти отличия нужно держать в голове, читая лабораторную работу: наблюдение мостов и правил netfilter в ней требует Docker Engine на Linux.
Docker Compose
Всё, что разобрано выше, выполнялось отдельными командами: создать сети, запустить контейнеры с нужными ключами -p, --network, -e, -v, подключить шлюз ко второй сети. Для приложения из трёх контейнеров это десяток команд с длинными строками параметров, которые нужно выполнять в правильном порядке и повторять при каждом пересоздании. Docker Compose решает эту задачу: приложение описывается одним файлом, а среда выполнения сама приводит набор контейнеров, сетей и томов в соответствие с описанием. Формат файла стандартизован спецификацией Compose (англ. Compose Specification) 8; в курсе используется реализация Docker Compose v2 — подкоманда docker compose (версии 2.29 и новее; на момент написания актуальна ветка 5.x).
Декларативная модель проекта
Описание в Compose декларативно: в файле записано, что должно существовать, а не какие команды выполнить. Команда docker compose up сравнивает описание с тем, что уже запущено, и создаёт недостающее, пересоздаёт изменившееся и не трогает совпадающее. Чтобы находить «свои» объекты, Compose помечает каждый созданный контейнер, сеть и том метками com.docker.compose.project и com.docker.compose.service, а в метке com.docker.compose.config-hash хранит хеш конфигурации сервиса: если хеш не изменился, контейнер не пересоздаётся.
Модель Compose состоит из четырёх понятий.
- Проект (англ. project) — единица развёртывания: всё, что описано в одном файле
compose.yaml(или в нескольких, наложенных друг на друга ключами-f). Имя проекта берётся из поляname:или из имени каталога и служит префиксом всех объектов. Два проекта с разными именами на одном хосте не мешают друг другу. - Сервис (англ. service) — описание одного компонента: образ или инструкции сборки, переменные окружения, порты, сети, тома, проверка здоровья, политика перезапуска. Из сервиса создаётся один или несколько контейнеров с именами вида
<проект>-<сервис>-<номер>. - Сеть — пользовательская сеть Docker с именем
<проект>_<сеть>. Если сети не описаны, Compose создаёт одну сеть<проект>_defaultи подключает к ней все сервисы 9. - Том — именованный том Docker с именем
<проект>_<том>(тома разобраны в теме 5). Тома переживают пересоздание контейнеров и удаляются только явно:docker compose down -v.
Сеть проекта — обычная пользовательская мостовая сеть, поэтому для неё верно всё сказанное выше о встроенном DNS. Каждый сервис доступен остальным по имени сервиса: backend обращается к базе по адресу db:5432, не зная её IP-адреса 9. Когда контейнер пересоздаётся после изменения конфигурации, он получает новый адрес, но то же имя; открытые соединения со старым контейнером при этом рвутся, и приложение должно уметь переподключаться 9. Если у сервиса несколько контейнеров (docker compose up --scale backend=3), имя сервиса разрешается во все их адреса. Порт в обращении между сервисами — порт контейнера; опубликованный порт хоста из раздела ports нужен только клиентам вне сетей проекта.
Трёхзвенное приложение в двух сетях
Полный пример описывает приложение из трёх компонентов: frontend на nginx отдаёт статику и проксирует /api/ на backend, backend работает с PostgreSQL. Сетевая топология повторяет шаблон из раздела о публикации сервисов: сеть front для frontend и backend, внутренняя сеть back для backend и базы. Схема на рисунке ниже показывает, кто кого видит.
name: notes

services:
  frontend:
    image: nginx:1.28-alpine
    ports:
      - "127.0.0.1:${FRONT_PORT:-8080}:80"     # только на петлевом адресе хоста
    volumes:
      - ./frontend/nginx.conf:/etc/nginx/conf.d/default.conf:ro
    networks: [front]
    depends_on:
      backend:
        condition: service_healthy
    restart: unless-stopped

  backend:
    build: ./backend
    environment:
      DB_HOST: db                               # имя сервиса, а не IP-адрес
      DB_USER: ${DB_USER:-notes}
      DB_PASSWORD: ${DB_PASSWORD:?задайте DB_PASSWORD в файле .env}
    networks: [front, back]                     # шлюз между сетями
    depends_on:
      db:
        condition: service_healthy
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/api/health"]
      interval: 10s
      timeout: 3s
      retries: 3
      start_period: 20s
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    environment:
      POSTGRES_DB: notes
      POSTGRES_USER: ${DB_USER:-notes}
      POSTGRES_PASSWORD: ${DB_PASSWORD:?задайте DB_PASSWORD в файле .env}
    volumes:
      - dbdata:/var/lib/postgresql/data
    networks: [back]
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $${POSTGRES_USER} -d $${POSTGRES_DB}"]
      interval: 5s
      timeout: 3s
      retries: 10
    restart: unless-stopped

  toolbox:                                      # отладка, только по запросу
    image: busybox:1.37
    profiles: [debug]
    network_mode: "service:backend"
    command: ["sleep", "infinity"]

networks:
  front: {}
  back:
    internal: true                              # без выхода наружу

volumes:
  dbdata: {}
Строки version: в файле нет: поле устарело, спецификация Compose его не использует, а современный Compose при его наличии выводит предупреждение. Разберём сетевую часть. Сервис db подключён только к сети back, и у него нет раздела ports: из сети front он невидим (имя db там не разрешается, а пакеты к его адресу отбрасываются межсетевой изоляцией), с других машин — тем более. Сервис backend подключён к обеим сетям и получает два интерфейса; через сеть front к нему обращается nginx, через сеть back он сам обращается к базе. Сервис frontend — единственный с опубликованным портом, причём только на 127.0.0.1: на сервере перед ним обычно стоит обратный прокси или балансировщик, а для разработки достаточно локального доступа.
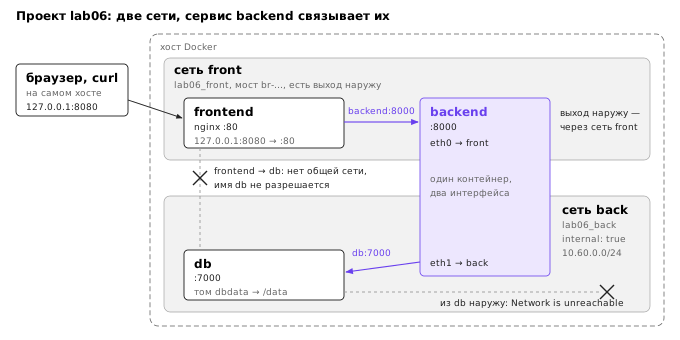
Ключ internal: true делает сеть внутренней: Docker не назначает в ней маршрут по умолчанию и не создаёт правил маскарадинга, а правила цепочки DOCKER-INTERNAL отбрасывают пакеты, уходящие из подсети сети или приходящие в неё извне 59. Контейнер, подключённый только к внутренней сети, не может открыть соединение с Интернетом: попытка подключиться к внешнему адресу завершится ошибкой Network is unreachable. Контейнер, подключённый и к внутренней, и к обычной сети, как backend, выходит наружу через обычную сеть. Две оговорки. Опубликовать порт контейнера, состоящего только во внутренней сети, нельзя: правил DNAT для неё Docker не создаёт. И внутренняя сеть не изолирована от самого хоста: мост получает адрес в её подсети, так что процессы хоста могут обращаться к контейнерам этой сети напрямую 3.
Том dbdata подключён к каталогу данных PostgreSQL, поэтому docker compose down и повторный up сохраняют данные, а docker compose down -v их удаляет. Путь /var/lib/postgresql/data верен для образа postgres:17; в образах PostgreSQL 18 каталог данных по умолчанию изменился, поэтому версию образа и путь тома следует менять вместе.
Порядок запуска: healthcheck, depends_on и restart
Без указаний Compose запускает сервисы параллельно. Ключ depends_on задаёт порядок: зависимый сервис создаётся после тех, от которых зависит, а останавливается раньше них 8. Но короткая форма depends_on: [db] гарантирует лишь, что контейнер db запущен, то есть его процесс стартовал. Готовность принимать соединения — другое событие: PostgreSQL после старта процесса ещё несколько секунд инициализирует каталог данных и открывает порт позже. Если backend при запуске сразу подключается к базе, возникает гонка старта (англ. race condition): на быстрой машине всё работает, на медленной или при первом запуске backend падает с ошибкой «соединение отклонено».
Решение — связать порядок запуска с проверкой готовности. Ключ healthcheck описывает команду проверки здоровья, которую Docker выполняет внутри контейнера — механизм тот же, что у инструкции HEALTHCHECK из темы 5. Длинная форма depends_on с условием condition: service_healthy заставляет Compose ждать, пока проверка зависимости не перейдёт в состояние healthy 8. Параметры проверки определяют, сколько времени займёт ожидание:
| Параметр | Смысл | По умолчанию |
|---|---|---|
test | команда: ["CMD", …] без оболочки или ["CMD-SHELL", "…"] через /bin/sh; код 0 — здоров | — |
interval | пауза между проверками | 30 с |
timeout | сколько ждать ответа одной проверки | 30 с |
retries | сколько неудач подряд переводят контейнер в unhealthy | 3 |
start_period | время на запуск: неудачи в этот период не считаются | 0 с |
start_interval | пауза между проверками в течение start_period | 5 с |
Значения по умолчанию совпадают с инструкцией HEALTHCHECK 8. Условий три: service_started (эквивалент короткой формы), service_healthy и service_completed_successfully — для одноразовых задач вроде миграции схемы, которые должны завершиться с кодом 0 до старта основного сервиса. Если зависимость не становится здоровой (или завершается), docker compose up сообщает об ошибке зависимости, а зависимый сервис не запускается. Обратим внимание на двойной знак доллара в проверке базы: $${POSTGRES_USER} экранирует подстановку, чтобы переменную раскрыла оболочка внутри контейнера, а не Compose при чтении файла.
У этой схемы есть границы, о которых важно помнить. Проверка здоровья должна проверять сам сервис, а не его зависимости: если проверка backend обращается к базе, падение базы сделает «нездоровым» и backend, и в оркестраторе это приведёт к каскадным перезапускам (тема 7). depends_on влияет только на запуск: если база упадёт через час, Compose ничего не сделает с backend, и приложение должно само переживать временную недоступность зависимостей. Наконец, restart (значения no, always, on-failure[:N], unless-stopped, см. тему 5) исполняет не Compose, а демон Docker — это та же политика перезапуска контейнера. Политика перезапуска может замаскировать гонку старта: backend упадёт, перезапустится и со второй-третьей попытки подключится к уже готовой базе. Система работает, но первые секунды её журнал полон ошибок, а время старта непредсказуемо.
Переменные, профили и проверка конфигурации
Значения, которые различаются между окружениями (порты, пароли, версии образов), выносят в переменные. Compose подставляет их в файл при чтении (англ. interpolation): ${VAR} — значение переменной, ${VAR:-default} — значение по умолчанию, если переменная не задана или пуста, ${VAR:?сообщение} — ошибка с сообщением, если не задана 8. Значения берутся из окружения оболочки и из файла .env в каталоге проекта; переменная оболочки важнее файла. Файл .env для примера выше:
FRONT_PORT=8080
DB_USER=notes
DB_PASSWORD=change-me
Файл .env с паролями не помещают в систему контроля версий; в репозиторий кладут его образец без секретов. Важно различать два механизма: переменные из .env подставляются в файл Compose, а раздел environment сервиса передаёт переменные в контейнер. Значение попадает в контейнер, только если оно указано в environment или подключено ключом env_file.
Профили (англ. profiles) позволяют держать в одном файле вспомогательные сервисы, которые не нужны при обычном запуске. Сервис без ключа profiles включён всегда, сервис с профилем — только когда профиль активен: docker compose --profile debug up или переменная COMPOSE_PROFILES=debug 8. Сервис, явно названный в команде, включается и без этого: docker compose run --rm toolbox ip addr запустит отладочный контейнер в сетевом пространстве backend и покажет его интерфейсы.
Перед запуском полезно посмотреть, во что Compose превратил файл после подстановки переменных, наложения нескольких файлов и подстановки значений по умолчанию. Это делает команда docker compose config. Она проверяет синтаксис и ссылки (на несуществующую сеть, неопределённую обязательную переменную) и печатает итоговую модель, не обращаясь к демону Docker:
docker compose config --quiet && echo "файл корректен"
docker compose config        # итоговая модель целиком
...
networks:
  back:
    name: notes_back
    internal: true
  front:
    name: notes_front
volumes:
  dbdata:
    name: notes_dbdata
В выводе видны окончательные имена сетей и томов с префиксом проекта. Если удалить из .env строку с паролем, та же команда завершится ошибкой required variable DB_PASSWORD is missing a value: задайте DB_PASSWORD в файле .env — проблема обнаружится до запуска, а не в журнале упавшего контейнера.
Границы Compose: один хост без согласования состояния
Compose удобен для разработки, тестирования и небольших развёртываний на одном сервере, но его модель имеет принципиальные пределы, и именно они ведут к оркестратору.
Первый предел — один хост. Compose обращается к одному демону Docker, и все контейнеры проекта работают на одной машине. Сети проекта — мосты этой машины, тома — каталоги на её диске. Разместить сервисы на нескольких серверах, распределить нагрузку между ними или пережить отказ сервера Compose не может.
Второй предел — сверка желаемого и фактического состояния выполняется только в момент команды. docker compose up действительно сравнивает описание с запущенными объектами и устраняет расхождения, но делает это один раз и завершается. Если после этого контейнер удалят вручную, изменят его параметры или откажет весь хост, Compose об этом не узнает: следить за состоянием некому. Политика restart частично закрывает этот пробел, но её исполняет локальный демон Docker, и она умеет только перезапустить тот же контейнер на той же машине. При отказе хоста перезапускать нечего и негде.
Третий предел — обновления. При изменении образа docker compose up останавливает старый контейнер и запускает новый; на время замены сервис недоступен. Постепенной замены экземпляров с проверкой готовности, отката при неудаче, автоматического масштабирования по нагрузке в Compose нет.
Оркестратор устроен иначе: желаемое состояние хранится в кластере, а контроллеры непрерывно сравнивают его с фактическим и исправляют расхождения на любом из узлов. Это цикл согласования (англ. reconciliation loop), с которого начинается тема 7. Понятия Compose при этом переносятся почти напрямую: сервис соответствует объектам Deployment и Service, имя сервиса в DNS — имени объекта Service, сеть проекта — сети кластера, healthcheck — пробам готовности и живости, --network container: — общему сетевому пространству контейнеров пода, а внутренняя сеть back — сетевой политике, которая разрешает обращаться к базе только backend (тема 11).
Итоги темы
Сетевое взаимодействие контейнерных приложений строится на двухуровневой модели: с одной стороны — изолированное сетевое пространство имён каждого контейнера, с другой — явные точки прозрачности, через которые контейнер сообщается с внешним миром и с другими контейнерами. Связь между уровнями обеспечивают пары виртуальных интерфейсов и программные мосты в пространстве хоста; пакеты ходят между мостом и контейнером прозрачно, а наружу — через таблицу маршрутизации и трансляцию адресов хоста.
Конкретный режим сети задаётся драйвером. Для подавляющего большинства учебных и однохостовых задач используется драйвер bridge, причём предпочтительна не стандартная сеть docker0, а явно созданная пользовательская сеть со встроенным разрешением имён. Режим host отказывается от изоляции в пользу прямого доступа к стеку хоста и применим только в узких сценариях оптимизации. Специальные драйверы (macvlan, ipvlan, overlay) решают задачи включения контейнера в физическую сеть и связи нескольких хостов; в курсе они подробно не рассматриваются, а многохостовая сеть изучается на примере Kubernetes. Режим --network container:, при котором несколько контейнеров разделяют один сетевой стек, — прямой прообраз пода.
Прикладная сторона сети — это два механизма: проброс портов наружу и обнаружение сервисов внутри. Первый делает контейнер доступным внешним клиентам через явный выбор хостового порта; второй позволяет контейнерам обращаться друг к другу по устойчивым именам, не завися от конкретных IP. Сочетание этих механизмов и нескольких пользовательских сетей даёт основной сетевой шаблон контейнерных приложений: «публиковать только то, что должно быть видно снаружи; всё внутреннее оставлять в частных сетях».
Эксплуатационные риски сетевой модели предсказуемы и связаны не с её сложностью, а с привычкой разработчика к удобной открытой среде. Избыточно опубликованные порты, привязка к 0.0.0.0 без необходимости, недокументированные зависимости между сервисами — типичные источники проблем. Особенно опасно то, что опубликованный порт проходит через цепочку FORWARD, минуя правила ufw в цепочке INPUT: закрывать такие порты нужно привязкой к 127.0.0.1 или правилами в DOCKER-USER, а не настройкой межсетевого экрана хоста. Наблюдать всё это позволяют правила netfilter: DNAT в таблице nat, фильтрация и межсетевая изоляция в таблице filter, — выводимые через iptables или, в экспериментальном бэкенде, через nft.
Docker Compose переводит эту сетевую модель в декларативное описание проекта: сервисы, сети, тома и порядок запуска записываются в одном файле, имя сервиса становится его DNS-именем, а внутренняя сеть с internal: true реализует шаблон «опубликовать минимум» без единой команды docker network. Связка healthcheck и depends_on с условием service_healthy устраняет гонку старта. Но Compose сверяет желаемое и фактическое состояние только в момент команды и только на одном хосте; непрерывное согласование состояния на множестве узлов — задача оркестратора, с которой начинается тема 7.
Литература
- Docker Documentation. Networking overview. — https://docs.docker.com/engine/network/ (дата обращения: 22.10.2026).
- Docker Documentation. Bridge network driver. — https://docs.docker.com/engine/network/drivers/bridge/ (дата обращения: 22.10.2026).
- Docker Documentation. Port publishing and mapping. — https://docs.docker.com/engine/network/port-publishing/ (дата обращения: 22.10.2026).
- Docker Documentation. Packet filtering and firewalls. — https://docs.docker.com/engine/network/packet-filtering-firewalls/ (дата обращения: 22.10.2026).
- Docker Documentation. Docker with iptables. — https://docs.docker.com/engine/network/firewall-iptables/ (дата обращения: 22.10.2026).
- Docker Documentation. Docker with nftables. — https://docs.docker.com/engine/network/firewall-nftables/ (дата обращения: 22.10.2026).
- Docker Documentation. Docker Engine 29 release notes. — https://docs.docker.com/engine/release-notes/29/ (дата обращения: 22.10.2026).
- Docker Documentation. Compose file reference (Compose Specification). — https://docs.docker.com/reference/compose-file/ (дата обращения: 22.10.2026).
- Docker Documentation. Networking in Compose. — https://docs.docker.com/compose/how-tos/networking/ (дата обращения: 22.10.2026).
- Docker Documentation. Networking on Docker Desktop. — https://docs.docker.com/desktop/features/networking/ (дата обращения: 22.10.2026).
- Linux man-pages project. network_namespaces(7) — overview of Linux network namespaces. — https://man7.org/linux/man-pages/man7/network_namespaces.7.html (дата обращения: 22.10.2026).
- Linux man-pages project. veth(4) — Virtual Ethernet Device. — https://man7.org/linux/man-pages/man4/veth.4.html (дата обращения: 22.10.2026).