
Оркестрация контейнеров: архитектура Kubernetes
В темах 3–6 контейнер рассматривался в пределах одного хоста. Тема 3 показала, что контейнер — это обычный процесс Linux, изолированный пространствами имён и ограниченный контрольными группами (cgroups), тема 5 — как задаются его ресурсы, политика перезапуска и проверка здоровья, тема 6 — как контейнеры получают адреса, находят друг друга по именам и публикуют порты, а Docker Compose описывает приложение из нескольких сервисов одним файлом. Всё это работает, пока приложение помещается на одну машину и пока эта машина исправна. Открытым остался вопрос, который на одном хосте не возникает: кто и как решает, на каком из многих серверов запустить контейнер, что делать, когда сервер пропал, и как обновить сотню копий сервиса, не прервав обслуживание.
Эти задачи решает оркестратор контейнеров. Фактическим стандартом стал Kubernetes — система, созданная в Google на основе десятилетнего опыта внутренних систем Borg и Omega и открытая в 2014 году; с 2015 года проект развивается под эгидой фонда Cloud Native Computing Foundation (CNCF) 1. Kubernetes не запускает контейнеры сам: на каждом узле это делает та же связка «среда выполнения → runc», что и в Docker (тема 3). Kubernetes добавляет над ней распределённую систему управления, которая хранит описание желаемого состояния всего кластера и непрерывно приводит к нему фактическое.
Изложение построено так. Первый раздел вводит декларативную модель: желаемое состояние, контроллеры, цикл согласования и механизм подписки на изменения. Второй разбирает компоненты кластера, путь одной команды kubectl apply от манифеста до процесса на узле, хранилище etcd с его кворумом и поведение кластера при отказе узла и плоскости управления. Третий посвящён поду и его размещению: ресурсам и классам качества обслуживания, работе планировщика и пробам. Четвёртый — контроллерам рабочих нагрузок, прежде всего Deployment и его постепенному обновлению. Пятый — сети сервисов: Service, EndpointSlice, kube-proxy, DNS, Ingress, а также горизонтальному автомасштабированию. Шестой раздел собирает диагностику типовых состояний пода, ограничения модели и типичные ошибки понимания. Примеры по возможности строятся на приложении «Заметки» из курсового проекта: backend на Node.js с портом 3000 и двумя проверками — GET /api/live (процесс жив) и GET /api/health (процесс жив и база отвечает), frontend на nginx с портом 8080 и PostgreSQL. Конфигурация, секреты и тома вынесены в тему 8, права доступа, сетевые политики и securityContext — в тему 11.
Декларативная модель управления
Чего не хватает одному хосту
Пусть backend «Заметок» нужно запустить в трёх копиях на кластере из пяти серверов. С инструментами темы 6 это выглядит как последовательность команд: зайти на сервер 1 и выполнить docker run, затем на сервер 3, затем на сервер 4. Сразу возникают вопросы, на которые эти команды не отвечают. На каких серверах хватает памяти и процессора? Что делать, если сервер 3 перезагрузился ночью, — политика restart: always поднимет контейнер на нём же, но если сервер не вернулся, копий станет две, и никто об этом не узнает. Как клиенты узнают адреса копий, если копии переезжают? Как заменить версию 1.0 на 2.0 так, чтобы в каждый момент работало не меньше трёх копий?
Можно написать скрипт, который всё это делает. Такой скрипт будет императивным (англ. imperative): он описывает последовательность действий. Его слабость — в промежуточных состояниях. Если на шаге «остановить старую копию на сервере 4» оборвалась сеть, скрипт завершится с ошибкой, а система окажется в состоянии, которое никто не планировал: часть копий новые, часть старые, одна потеряна. Повторный запуск того же скрипта не обязательно приведёт систему в порядок, потому что скрипт рассчитан на определённое начальное состояние.
Kubernetes устроен иначе. Пользователь описывает не действия, а желаемое состояние (англ. desired state): «должно работать три копии пода с образом notes-backend:1.0, каждой нужно 0,2 ядра и 256 МиБ памяти». Это описание сохраняется в кластере как объект. Дальше специальные программы — контроллеры — сами вычисляют, какие действия нужны, чтобы фактическое состояние совпало с описанным, и повторяют это вычисление бесконечно. Такой подход называют декларативным (англ. declarative) 13.
Контроллеры и цикл согласования
Контроллер (англ. controller) — программа, которая следит за объектами одного типа и выполняет цикл согласования (англ. reconciliation loop): прочитать желаемое состояние, прочитать фактическое, вычислить разницу и сделать шаг, уменьшающий её. Цикл показан на рисунке ниже. Контроллер ReplicaSet, например, видит в описании replicas: 3, подсчитывает поды, подходящие под селектор этого ReplicaSet, и, обнаружив только два, создаёт ещё один. Обнаружив четыре, удаляет лишний. Обнаружив три, ничего не делает.
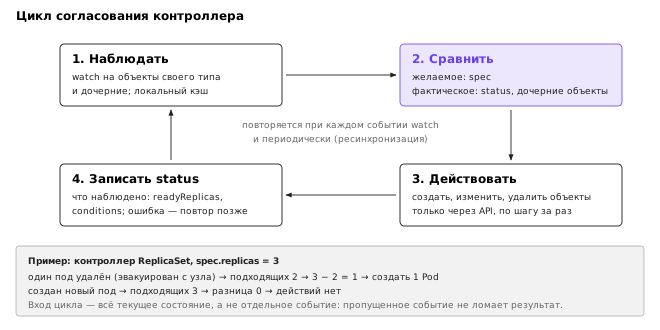
У этого устройства три важных следствия. Во-первых, контроллеру безразлично, почему возникло расхождение: под удалили вручную, его вытеснили с перегруженного узла или пропал весь узел — реакция одна и та же. Во-вторых, повторное выполнение безопасно: если контроллер упал посреди работы и перезапустился, он просто снова сравнит состояния и продолжит с того места, где система находится сейчас, а не с того, где остановилась программа. В-третьих, контроллеры легко комбинируются. Контроллер Deployment не создаёт поды: он создаёт и масштабирует объекты ReplicaSet, а поды из них создаёт контроллер ReplicaSet. Каждый отвечает за свой уровень и не знает о внутреннем устройстве соседа.
Объект Kubernetes отражает это разделение в своей структуре. Почти у каждого объекта есть поле spec — желаемое состояние, которое пишет пользователь, — и поле status — наблюдаемое состояние, которое пишет контроллер. Например, у Deployment в spec.replicas указано желаемое число копий, а в status.readyReplicas — сколько из них сейчас готовы. Расхождение spec и status — нормальное рабочее состояние системы в момент изменений; задача контроллеров — сделать его временным.
Подписка на изменения вместо опроса
Чтобы сравнивать состояния, контроллер должен знать о каждом изменении объектов. Простейший способ — опрашивать сервер API раз в несколько секунд — плохо масштабируется: в кластере тысячи подов и десятки контроллеров, и каждый опрос возвращал бы весь список заново. Поэтому сервер API поддерживает операцию watch — подписку на изменения 5. Каждый объект имеет поле metadata.resourceVersion, монотонно растущую метку версии. Клиент получает список объектов вместе с текущей версией, а затем открывает долгоживущий запрос GET /api/v1/namespaces/lab07/pods?watch=1&resourceVersion=10245, в ответ на который сервер присылает поток событий ADDED, MODIFIED, DELETED обо всех изменениях после указанной версии.
Сервер хранит историю изменений ограниченное время: в кластерах на etcd 3 — по умолчанию последние 5 минут 5. Если клиент отключился дольше, сервер отвечает кодом 410 Gone, и клиент обязан заново получить полный список и начать подписку с новой версии. В клиентских библиотеках эта логика «список, затем подписка» реализована готовой; поверх неё строится локальный кэш объектов (в библиотеке для Go он называется informer), из которого контроллер читает данные, не обращаясь к серверу.
Здесь проявляется ключевая особенность проектирования: контроллеры Kubernetes реагируют на уровень, а не на фронт (англ. level-triggered, а не edge-triggered). Событие watch служит лишь сигналом «что-то изменилось, пересчитай». Вычисление же всегда опирается на текущее состояние целиком, взятое из кэша. Если событие потерялось — при обрыве соединения, перезапуске контроллера, переполнении очереди, — следующее событие или периодическая ресинхронизация всё равно приведут к правильному результату. Система, построенная на реакции на отдельные события («создан под — увеличить счётчик»), накапливала бы ошибку от каждого пропущенного события 1.
Объекты, пространства имён и метки
Всё, чем управляет Kubernetes, — объекты API: Pod, ReplicaSet, Deployment, Service, Node и десятки других типов. У каждого объекта есть тип (kind), версия API (apiVersion), метаданные (metadata) и, как правило, spec и status. Объекты большинства типов принадлежат пространству имён (англ. namespace) — логическому разделу кластера, внутри которого имена уникальны. Это не пространство имён Linux из темы 3: никакой изоляции процессов оно не создаёт, а служит областью видимости имён, единицей назначения прав (тема 11) и квот. Узлы, сами пространства имён и некоторые другие объекты от пространства имён не зависят.
Связь между объектами в Kubernetes устроена не через прямые ссылки, а через метки (англ. labels) — пары «ключ — значение» в metadata.labels — и селекторы (англ. selectors), выбирающие объекты по меткам. ReplicaSet не хранит список «своих» подов: он считает своими все поды пространства имён, метки которых подходят под его селектор. Service не хранит адреса подов: он вычисляет их по селектору. Это делает связи слабыми и вычисляемыми: под можно «вынуть» из ReplicaSet и Service, просто сменив ему метку, — контроллер создаст замену, а вынутый под останется для отладки.
| Кто выбирает | Поле селектора | Что выбирает | Что будет при ошибке в метке |
|---|---|---|---|
| ReplicaSet, Deployment | spec.selector.matchLabels | поды, которые считаются своими | API отклонит Deployment, если селектор не совпадает с метками шаблона |
| Service | spec.selector | поды, на которые идёт трафик | Service создаётся, но EndpointSlice пуст, соединения отвергаются |
| HorizontalPodAutoscaler | spec.scaleTargetRef (по имени) и селектор целевого объекта | поды, чьи метрики усредняются | масштабирование не того объекта или ошибка получения метрик |
kubectl get -l | аргумент -l app=echo | объекты для вывода | пустой вывод |
Второй и третий столбцы таблицы объясняют одну из самых частых ошибок: опечатка в селекторе Service не вызывает никакой ошибки при создании, потому что Service без подходящих подов — допустимое состояние. Она проявляется лишь тем, что запросы к сервису не проходят. Этот случай разбирается в лабораторной работе.
Кроме меток, у объекта есть аннотации (англ. annotations) — тоже пары «ключ — значение», но не участвующие в выборе; в них хранят служебную информацию для инструментов. И есть ссылки владения metadata.ownerReferences: под, созданный ReplicaSet, ссылается на него как на владельца. По этим ссылкам работает сборщик мусора: удаление Deployment каскадно удаляет его ReplicaSet, а те — поды.
Архитектура кластера и путь запроса
Плоскость управления и рабочие узлы
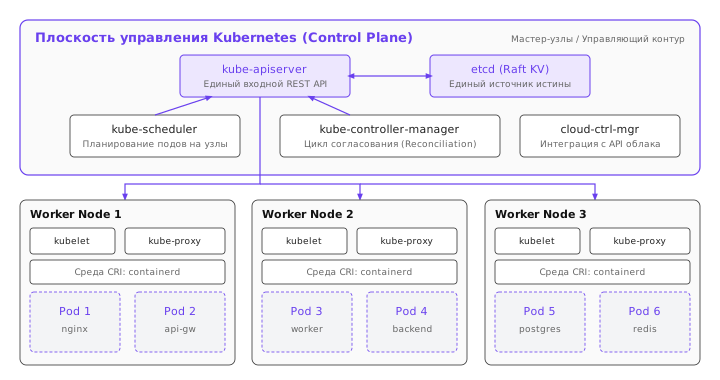
Кластер Kubernetes делится на плоскость управления (англ. control plane) и рабочие узлы (англ. worker nodes) 4. Плоскость управления хранит состояние кластера и принимает решения, узлы выполняют поды. В учебном кластере minikube оба набора компонентов работают на одной машине, в промышленном кластере плоскость управления обычно занимает три отдельных сервера, а рабочих узлов — от нескольких до тысяч. Общая схема показана на рисунке.
| Компонент | Где работает | Что делает | Хранит состояние |
|---|---|---|---|
kube-apiserver | плоскость управления | единственная точка доступа к состоянию: REST API, аутентификация, авторизация, контроль допуска, проверка схемы, watch | нет, всё в etcd |
etcd | плоскость управления | согласованное хранилище «ключ — значение» на алгоритме Raft | да, единственное |
kube-scheduler | плоскость управления | выбирает узел для каждого пода, у которого узел ещё не назначен | нет |
kube-controller-manager | плоскость управления | один процесс с десятками контроллеров: ReplicaSet, Deployment, Node, EndpointSlice, Job, HPA и других | нет |
cloud-controller-manager | плоскость управления (в облаке) | связь с API провайдера: балансировщики для Service типа LoadBalancer, сведения об узлах-ВМ | нет |
kubelet | каждый узел | получает поды своего узла, запускает их через CRI, выполняет пробы, сообщает статус | нет |
| среда выполнения (containerd, CRI-O) | каждый узел | загрузка образов, создание контейнеров через runc | локальный кэш образов |
kube-proxy | каждый узел | программирует правила netfilter для виртуальных адресов Service | нет |
| CoreDNS | поды в kube-system | DNS-имена сервисов | нет |
Главная архитектурная мысль таблицы — в последнем столбце. Единственный компонент с долговременным состоянием — etcd, а единственный, кто с ним разговаривает, — kube-apiserver. Все остальные компоненты, включая планировщик, контроллеры и kubelet, — клиенты сервера API, такие же, как kubectl: они читают объекты, подписываются на изменения и пишут результаты своей работы обратно через API. Компоненты не вызывают друг друга напрямую. Планировщик не сообщает kubelet, что под назначен на его узел: он записывает имя узла в объект Pod, а kubelet узнаёт об этом из своей подписки. Такое устройство позволяет перезапускать и заменять любой компонент, кроме etcd, без потери информации: после перезапуска он прочитает всё нужное из API 14.
Связь kubelet со средой выполнения идёт через интерфейс Container Runtime Interface (CRI) — набор вызовов gRPC вида RunPodSandbox, CreateContainer, StartContainer. Его реализуют containerd и CRI-O. Docker Engine интерфейса CRI не реализует; встроенная прослойка dockershim была удалена в Kubernetes 1.24, и с тех пор Docker Engine используется только через внешний адаптер cri-dockerd. Именно так устроен minikube с драйвером docker и средой выполнения docker: внутри узла-контейнера работает свой Docker Engine, а kubelet обращается к нему через cri-dockerd. Для понимания курса это различие несущественно: ниже CRI в любом случае та же связка containerd → shim → runc, что и в теме 3.
Путь одного kubectl apply
Сведём компоненты вместе, проследив одну команду — создание Deployment из трёх подов. Последовательность показана на рисунке ниже; номера в тексте соответствуют номерам стрелок.
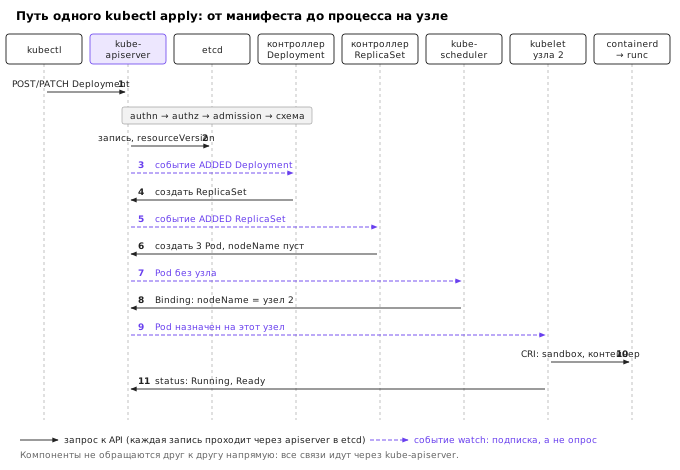
kubectlчитает манифест, определяет поapiVersionиkindадрес ресурса и отправляет запрос вkube-apiserver:POSTдля нового объекта илиPATCHдля существующего. Сервер API пропускает запрос через конвейер: аутентификация (кто это?), авторизация (можно ли ему это?), изменяющие контроллеры допуска (англ. mutating admission, могут дописать поля, например значения по умолчанию), проверка схемы объекта и проверяющие контроллеры допуска (англ. validating admission, могут отклонить запрос). Подробно конвейер разбирается в теме 11.- Объект записывается в etcd и получает
resourceVersion. В этот моментkubectlполучает ответ201 Createdи завершается: команда не ждёт, пока поды запустятся. Всё дальнейшее происходит асинхронно. - Контроллер Deployment получает по watch событие о новом Deployment.
- Он создаёт ReplicaSet с тем же шаблоном пода и
replicas: 3. - Контроллер ReplicaSet получает событие о новом ReplicaSet.
- Он создаёт три объекта Pod. Поле
spec.nodeNameу них пустое: поды существуют только как записи в etcd, ни на одном узле ничего не запущено. Статус таких подов —Pending. - Планировщик подписан на поды с пустым
nodeNameи получает три события. - Для каждого пода он выбирает узел (как — разбирается в разделе о размещении) и записывает решение подобъектом Binding.
- kubelet каждого узла подписан на поды со своим именем в
spec.nodeNameи получает событие. - kubelet вызывает среду выполнения через CRI: создаёт песочницу пода с сетевым пространством имён, загружает образ при необходимости, создаёт и запускает контейнеры.
- kubelet записывает в
statusпода фазуRunning, адрес пода и результаты проб; когда проба готовности проходит, условиеReadyстановится истинным.
Каждый шаг виден снаружи. Если запустить kubectl apply с флагом подробного журнала, видны HTTP-запросы шага 1; примерный вид вывода для нового объекта:
kubectl apply -f 10-echo-deployment.yaml -v=6
... loader.go:402] Config loaded from file:  /home/user/.kube/config
... round_trippers.go:632] "Response" verb="GET" url="https://192.168.49.2:8443/apis/apps/v1/namespaces/lab07/deployments/echo" status="404 Not Found" milliseconds=6
... round_trippers.go:632] "Response" verb="POST" url="https://192.168.49.2:8443/apis/apps/v1/namespaces/lab07/deployments?fieldManager=kubectl-client-side-apply&fieldValidation=Strict" status="201 Created" milliseconds=14
deployment.apps/echo created
Сначала kubectl пытается получить существующий объект и, получив 404, создаёт его. При повторном apply изменённого манифеста вместо POST будет PATCH: клиент сравнивает три версии — последнюю применённую (она хранится в аннотации kubectl.kubernetes.io/last-applied-configuration), текущую в кластере и новую из файла — и отправляет только разницу. С флагом --server-side это слияние выполняет сам сервер API, отслеживая, какой менеджер владеет каким полем. Шаги 3–11 видны в событиях пространства имён:
kubectl -n lab07 get events --sort-by=.lastTimestamp
LAST SEEN   TYPE     REASON              OBJECT                      MESSAGE
12s         Normal   ScalingReplicaSet   deployment/echo             Scaled up replica set echo-6d8f7c9b54 from 0 to 3
12s         Normal   SuccessfulCreate    replicaset/echo-6d8f7c9b54  Created pod: echo-6d8f7c9b54-q7lmz
12s         Normal   Scheduled           pod/echo-6d8f7c9b54-q7lmz   Successfully assigned lab07/echo-6d8f7c9b54-q7lmz to lab07-m02
11s         Normal   Pulled              pod/echo-6d8f7c9b54-q7lmz   Container image "lab07/echo:1.0" already present on machine
11s         Normal   Created             pod/echo-6d8f7c9b54-q7lmz   Created container: echo
11s         Normal   Started             pod/echo-6d8f7c9b54-q7lmz   Started container echo
...
Отправителей событий легко сопоставить с компонентами: ScalingReplicaSet пишет контроллер Deployment, SuccessfulCreate — контроллер ReplicaSet, Scheduled — планировщик, остальные — kubelet узла. Если цепочка обрывается, место обрыва указывает на виновника: есть SuccessfulCreate, но нет Scheduled — разбираться нужно с планировщиком и ресурсами; есть Scheduled, но нет Started — с узлом и образом.
etcd и кворум
Хранилище etcd работает как кластер из нескольких членов, согласующих каждую запись по алгоритму Raft 2. Один из членов — лидер — принимает записи, добавляет их в свой журнал и рассылает остальным; запись считается подтверждённой (англ. committed), когда её сохранило на диск большинство членов, включая лидера. Если лидер пропадает, оставшиеся выбирают нового, но только большинством голосов. Большинство называется кворумом (англ. quorum). Для кластера из n членов размер кворума и число переживаемых отказов равны
q = \left\lfloor \frac{n}{2} \right\rfloor + 1, \qquad f = n - q = \left\lfloor \frac{n-1}{2} \right\rfloor.
Подставим значения 6:
| Членов n | Кворум q | Переживает отказов f |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
Таблица объясняет, почему членов etcd всегда нечётное число. Переход от трёх к четырём не добавляет устойчивости (f остаётся 1), но увеличивает кворум с 2 до 3 и число машин, которые могут отказать. Хуже того, при разделении сети четыре члена могут распасться на две половины по два, и ни у одной не будет большинства — кластер перестанет принимать записи целиком. При нечётном числе одна из частей разделённой сети всегда содержит большинство и продолжает работу. Кластер из двух членов хуже кластера из одного: отказов он не переживает, а машин, отказ любой из которых его останавливает, — две. Документация Kubernetes рекомендует для промышленных кластеров пять членов etcd, позволяя пережить отказ двух 6.
Что значит «потеря кворума» для Kubernetes? Если из трёх членов etcd работает один, он не может подтвердить ни одной записи. Сервер API не может создать, изменить или удалить ни один объект, а согласованные чтения тоже завершаются ошибкой или тайм-аутом. Контроллеры не могут записать результаты, планировщик — назначить узел, kubelet — обновить статус. Управление кластером останавливается полностью. Но останавливается именно управление: работающие поды продолжают работать (об этом — в следующем подразделе). Восстановление после необратимой потери большинства членов — ручная процедура из резервной копии, поэтому регулярные снимки etcd (etcdctl snapshot save) — обязательная часть эксплуатации самостоятельно развёрнутого кластера.
Ещё два ограничения etcd определяют, что вообще можно хранить в объектах Kubernetes. Размер одного запроса к etcd по умолчанию ограничен 1,5 МиБ, поэтому объект API не может быть больше; размер всей базы по умолчанию ограничен 2 ГиБ. Объекты Kubernetes — это метаданные кластера, а не данные приложений: большие файлы, журналы и содержимое баз данных хранятся в томах и внешних хранилищах (темы 8 и 10).
Отказ узла и отказ плоскости управления
Узел сообщает о себе двумя способами 4. kubelet обновляет объект Lease в пространстве имён kube-node-lease — это лёгкое сердцебиение, по умолчанию раз в 10 секунд, — и периодически обновляет status объекта Node с условиями Ready, MemoryPressure, DiskPressure, PIDPressure. Контроллер узлов в kube-controller-manager каждые 5 секунд проверяет, когда узел последний раз давал о себе знать. Если сердцебиения нет дольше --node-monitor-grace-period (по умолчанию 50 секунд), условие Ready получает значение Unknown, и узел показывается как NotReady.
Сразу после этого на узел ставится ограничение (англ. taint) node.kubernetes.io/unreachable с эффектом NoExecute. Эффект NoExecute означает «поды, не допускающие этого ограничения, должны быть выселены с узла». Однако при создании каждого пода контроллер допуска DefaultTolerationSeconds добавляет ему допуски (англ. tolerations) к ограничениям node.kubernetes.io/unreachable и node.kubernetes.io/not-ready с tolerationSeconds: 300, если таких допусков нет в манифесте 8. Иначе говоря, под соглашается оставаться на недоступном узле 5 минут — на случай, если это кратковременный сбой сети, а не гибель машины. По истечении допуска поды узла помечаются на удаление, контроллеры ReplicaSet видят нехватку копий и создают замену, планировщик размещает её на исправных узлах.
Сложим времена для узла, который выключился в момент t = 0:
| Время | Событие |
|---|---|
| 0 с | узел перестал отвечать, его поды недоступны, но Service ещё направляет на них трафик |
| около 50 с | истёк node-monitor-grace-period: узел NotReady, ограничение unreachable:NoExecute; контроллер EndpointSlice помечает поды узла неготовыми, и трафик на них прекращается |
| около 350 с | истекли 300 с допуска: поды узла получают отметку удаления (Terminating) |
| около 350–360 с | ReplicaSet создаёт замену, планировщик назначает узлы, kubelet запускает контейнеры |
Итого с настройками по умолчанию замена подов отказавшего узла начинается примерно через 5 минут 50 секунд. Для сервиса с несколькими копиями на разных узлах это время не означает простоя — оставшиеся копии продолжают обслуживание, — но означает пониженную ёмкость. Если такая задержка неприемлема, в шаблон пода записывают собственные допуски с меньшим tolerationSeconds; в лабораторной работе значение 30 секунд сокращает время до замены примерно до 80 секунд. Слишком малое значение опасно: при кратковременном сетевом сбое все поды будут перезапущены без нужды. Поды, которые получили отметку удаления на недоступном узле, остаются в состоянии Terminating, пока узел не вернётся или объект Node не будет удалён: сервер API не может убедиться, что kubelet действительно остановил контейнеры, ведь связи с узлом нет 8. Для обычных Deployment это не мешает, а для приложений с состоянием, где две копии с одним именем недопустимы, это важное свойство (тема 8).
Скорость выселения дополнительно ограничена: в здоровой зоне доступности контроллер узлов ставит ограничения не чаще чем на один узел в 10 секунд (--node-eviction-rate равен 0,1), а если недоступна значительная доля узлов зоны, темп снижается или выселение прекращается вовсе. Логика проста: когда одновременно «пропало» больше половины узлов, вероятнее отказ сети или самой плоскости управления, чем одновременная гибель машин, и массовое выселение сделало бы только хуже 4.
Теперь об отказе самой плоскости управления. Если недоступен сервер API (или потерян кворум etcd, что для клиентов выглядит так же), на рабочих узлах происходит следующее:
- запущенные контейнеры продолжают работать: kubelet и среда выполнения от сервера API для этого не зависят;
- kubelet продолжает выполнять пробы и перезапускает упавшие контейнеры по
restartPolicyпода, потому что это локальное решение; - правила kube-proxy остаются в ядре в последнем известном виде, и трафик между сервисами продолжает ходить по ним;
- зато ничего нового не происходит: не создаются поды взамен потерянных, не обрабатываются отказы узлов, не масштабируется HPA, не применяются манифесты; изменения состава подов не отражаются в правилах kube-proxy.
Кластер без плоскости управления похож на самолёт с отключённым автопилотом: он продолжает лететь по текущему курсу, но не может его исправить. Поэтому плоскость управления промышленного кластера делают отказоустойчивой — три или пять серверов с etcd и несколькими экземплярами сервера API за балансировщиком, причём планировщик и kube-controller-manager работают в нескольких экземплярах, из которых активен один, выбранный через объект Lease (англ. leader election).
Pod, ресурсы и размещение
Pod как единица размещения
Pod (под) — наименьшая единица, которую размещает Kubernetes: группа из одного или нескольких контейнеров, которые всегда запускаются на одном узле и разделяют сетевое пространство имён — один IP-адрес, один localhost, одно пространство портов. Это прямое продолжение режима --network container: из темы 6, где второй контейнер подключался к сетевому пространству первого. В Kubernetes сетевое пространство создаётся заранее, при создании песочницы пода (во многих средах выполнения его держит крошечный служебный контейнер pause), а контейнеры приложения подключаются к нему. Поэтому перезапуск контейнера приложения не меняет адрес пода.
Как правило, под содержит один контейнер приложения. Несколько контейнеров объединяют, когда они действительно неразделимы: обязаны жить на одном узле, обмениваться данными через localhost или общий том и масштабироваться вместе. Типичные случаи — вспомогательный контейнер (англ. sidecar), например прокси, добавляющий TLS к приложению, или сборщик журналов, и инициализирующие контейнеры (англ. init containers), которые выполняются по очереди до старта основных и готовят окружение. Backend и PostgreSQL «Заметок» в один под не объединяют: их масштабируют независимо (три копии backend и одна база), а отказ одного не должен перезапускать другой.
У пода нет собственной устойчивости. Под, созданный напрямую, будет перезапускать свои упавшие контейнеры, пока жив его узел, но если узел пропал, под исчезнет вместе с ним и никто его не воссоздаст: под привязан к узлу на всю жизнь и на другой узел не переносится. Перенос — это всегда создание нового пода с новым именем и новым IP-адресом контроллером более высокого уровня. Отсюда правило: поды почти никогда не создают вручную, их создают контроллеры — Deployment, StatefulSet, DaemonSet, Job.
Запросы, лимиты и классы качества обслуживания
Каждый контейнер может указать для процессора и памяти два значения 9. Запрос (англ. request) — сколько ресурса контейнеру нужно гарантированно; его использует планировщик при выборе узла. Лимит (англ. limit) — сколько контейнеру разрешено потреблять максимум; его применяет ядро узла через cgroups, как в теме 5. Процессор измеряется в ядрах и миллиядрах (250m — четверть ядра), память — в байтах с двоичными суффиксами (128Mi). Если для ресурса указан только лимит, запрос по умолчанию принимается равным лимиту.
Механизмы применения запросов и лимитов разные, и это важно понимать. Лимит процессора превращается в квоту планировщика CFS: в cgroup v2 лимит 500m даёт cpu.max = 50000 100000, то есть не больше 50 мс процессорного времени в каждом окне 100 мс. Превышение не убивает контейнер, а приостанавливает его до следующего окна — происходит дросселирование (англ. throttling). Числовой пример: обработка запроса требует 200 мс работы одного потока. Без лимита на свободном ядре она займёт 200 мс. С лимитом 500m контейнер получает 50 мс в каждые 100 мс, и та же работа растягивается минимум на 400 мс — задержка выросла вдвое при том, что узел мог быть почти пуст. Лимит памяти превращается в memory.max; при попытке превысить его ядро не может «притормозить» выделение и вызывает OOM killer внутри cgroup контейнера: процесс получает SIGKILL, контейнер завершается с кодом 137, и kubelet записывает причину OOMKilled. Запрос процессора задаёт вес cpu.weight, то есть долю процессора при конкуренции, а запрос памяти ядром вообще не применяется — он нужен только планировщику и логике вытеснения.
По сочетанию запросов и лимитов каждый под получает класс качества обслуживания (англ. Quality of Service class, QoS) 9:
| Класс | Условие | Порядок вытеснения при нехватке памяти узла | oom_score_adj |
|---|---|---|---|
Guaranteed | у каждого контейнера заданы лимиты процессора и памяти, и запросы равны лимитам | последними | −997 |
Burstable | не Guaranteed, но хотя бы у одного контейнера задан запрос или лимит | после BestEffort, в первую очередь превысившие запросы | от 2 до 999, тем больше, чем меньше запрос памяти |
BestEffort | ни у одного контейнера нет ни запросов, ни лимитов | первыми | 1000 |
Класс определяет судьбу пода, когда на узле кончается память. Тогда возможны два разных механизма. Первый — вытеснение kubelet'ом (англ. node-pressure eviction): kubelet замечает, что свободной памяти меньше порога, и сам завершает поды, начиная с BestEffort и Burstable, превысивших запросы. Такой под получает статус Evicted, и контроллер создаёт замену на другом узле. Второй — OOM killer ядра, если память кончилась быстрее, чем отреагировал kubelet; он выбирает жертву по oom_score, к которому kubelet прибавляет oom_score_adj из таблицы. Для Burstable значение вычисляется как \min(\max(2,\ 1000 - 1000 \cdot r / M),\ 999), где r — запрос памяти, M — объём памяти узла. Контейнер с запросом 64 МиБ на узле с 4 ГиБ получает 1000 - 1000 \cdot 64/4096 \approx 984, то есть почти первым кандидатом на уничтожение; контейнер с запросом 2 ГиБ на том же узле — 500.
Практический вывод для backend «Заметок»: запросы следует задавать по реально измеренному потреблению в обычном режиме, лимит памяти — с запасом на пики, а лимит процессора — осторожно, потому что дросселирование незаметно ухудшает задержку. Многие эксплуатационные команды задают для сервисов запрос процессора без лимита и лимит памяти, равный или немного больший запроса.
Планировщик: фильтрация и скоринг
Планировщик kube-scheduler получает поды без назначенного узла и для каждого выбирает узел в два этапа 7. На этапе фильтрации (англ. filtering) отбрасываются узлы, на которых под запустить нельзя: не хватает свободных ресурсов по запросам, есть ограничение без допуска, не выполнено обязательное правило привязки, занят нужный порт узла, узел помечен как недоступный для размещения. Оставшиеся узлы называются допустимыми (англ. feasible). На этапе скоринга (англ. scoring) каждый допустимый узел получает оценку от 0 до 100 от каждого из включённых модулей оценки; итог — взвешенная сумма, и под назначается на узел с наибольшей суммой. Если допустимых узлов нет, под остаётся в Pending с событием FailedScheduling, а планировщик повторит попытку при изменении кластера.
Важнейшая особенность: планировщик считает ресурсы по запросам, а не по фактической загрузке. «Свободно» на узле — это его выделяемый объём (англ. allocatable, ёмкость за вычетом зарезервированного под систему) минус сумма запросов уже назначенных подов. Узел, на котором поды запросили 3,9 из 4 ядер, но реально потребляют 0,2, для планировщика почти полон. И наоборот, узел с подами BestEffort, которые ничего не запросили, но съели всю память, для планировщика пуст. Поэтому поды без запросов ломают планирование: они не учитываются при размещении, но конкурируют за ресурсы.
Разберём пример. Под запрашивает cpu: 500m, memory: 512Mi. В кластере четыре узла:
| Узел | Выделяемый объём | Уже запрошено | Фильтрация | Свободно после размещения, CPU / память | Оценка LeastAllocated |
|---|---|---|---|---|---|
| A | 2 ядра, 4 ГиБ | 1800m, 1 ГиБ | отброшен: 1800m + 500m больше 2000m | — | — |
| B | 4 ядра, 8 ГиБ | 1000m, 2 ГиБ | проходит | 62,5 % / 68,75 % | 65,6 |
| C | 4 ядра, 8 ГиБ | 3000m, 6 ГиБ | проходит | 12,5 % / 18,75 % | 15,6 |
| D | 8 ядер, 16 ГиБ | 0, 0 | отброшен: ограничение gpu=true:NoSchedule, у пода нет допуска | — | — |
Модуль NodeResourcesFit по умолчанию использует стратегию LeastAllocated: для каждого ресурса оценка равна доле, которая останется свободной после размещения, умноженной на 100, и оценки ресурсов усредняются. Для узла B это (62{,}5 + 68{,}75)/2 \approx 65{,}6, для C — (12{,}5 + 18{,}75)/2 \approx 15{,}6. Другие модули добавляют свои оценки: NodeResourcesBalancedAllocation предпочитает узлы, где загрузка процессора и памяти окажется сбалансированной, ImageLocality — узлы, где образ уже загружен, PodTopologySpread — равномерное распределение копий одного приложения по узлам и зонам, InterPodAffinity и NodeAffinity — выполнение мягких правил привязки, TaintToleration — узлы с меньшим числом ограничений эффекта PreferNoSchedule 7. В примере B выигрывает с большим отрывом. Заметим, что узел D — самый свободный, но недоступен для пода из-за ограничения: «наименее загруженный» узел не обязательно выбранный.
Управлять размещением можно с двух сторон. Ограничения и допуски действуют от узла: ограничение ставится на узел командой kubectl taint nodes node-d gpu=true:NoSchedule и отталкивает все поды, у которых нет соответствующего допуска. Эффекты: NoSchedule — не размещать новые поды, PreferNoSchedule — по возможности не размещать, NoExecute — не размещать и выселять уже работающие 8. Так выделяют узлы под особые задачи (с GPU, для системных компонентов): допуск ставится только тем подам, которым на этих узлах место. Сам допуск не притягивает под к узлу, а лишь разрешает там оказаться. Притягивание задаётся от пода: nodeSelector (простое совпадение меток узла), привязка к узлам (англ. node affinity) с обязательными (requiredDuringSchedulingIgnoredDuringExecution) и предпочтительными (preferredDuringScheduling...) правилами, а также привязка и антипривязка к другим подам (англ. pod affinity, anti-affinity), например «не размещать две копии backend на одном узле». Для узлов с GPU обычно используют оба механизма: ограничение отталкивает чужие поды, а привязка направляет туда свои.
Пробы: запуск, готовность и живость
kubelet может проверять каждый контейнер тремя видами проб (англ. probes), и каждая отвечает на свой вопрос 10:
| Проба | Вопрос | Что делает kubelet при провале | Когда выполняется |
|---|---|---|---|
startupProbe | закончил ли контейнер запуск? | после failureThreshold провалов перезапускает контейнер | с самого старта и до первого успеха; остальные пробы до этого не выполняются |
readinessProbe | можно ли сейчас направлять контейнеру запросы? | отмечает под неготовым; его адрес исключается из EndpointSlice всех Service | всё время жизни контейнера |
livenessProbe | жив ли процесс или он завис безнадёжно? | после failureThreshold провалов перезапускает контейнер | после успеха startupProbe (если она задана), всё время жизни |
Проба выполняется как HTTP-запрос (httpGet, успех — код от 200 до 399), TCP-подключение (tcpSocket), вызов gRPC (grpc) или команда внутри контейнера (exec). Значения по умолчанию: periodSeconds: 10, timeoutSeconds: 1, failureThreshold: 3, successThreshold: 1, initialDelaySeconds: 0 10. Время до реакции легко посчитать: при периоде 5 с и пороге 3 зависший процесс будет перезапущен через 10–15 с после зависания. Для медленно стартующего приложения startupProbe с periodSeconds: 10 и failureThreshold: 30 даёт до 300 с на запуск, не ослабляя livenessProbe после него: без неё пришлось бы ставить большую initialDelaySeconds и ждать её при каждом перезапуске.
Главная ошибка в пробах — проверка живости, зависящая от внешних компонентов. Backend «Заметок» имеет эндпоинт GET /api/health, который выполняет запрос к PostgreSQL. Если указать его в livenessProbe, произойдёт следующее. База данных становится недоступна на минуту, например при перезапуске. Через 30 с (3 × 10 с) проба живости проваливается у всех копий backend одновременно, и kubelet перезапускает их все. Перезапуск не помогает — база по-прежнему недоступна, — и после нескольких циклов контейнеры попадают в CrashLoopBackOff с экспоненциально растущей задержкой перед следующим перезапуском: 10, 20, 40 секунд и так далее до 5 минут 10. База вернулась, но backend ещё несколько минут не отвечает, потому что ждёт окончания задержки. Кратковременный сбой одной зависимости превратился в длительный отказ всего сервиса, а массовый одновременный перезапуск с повторными подключениями мог дополнительно нагрузить и без того восстанавливающуюся базу.
Правильное разделение: livenessProbe проверяет только сам процесс — отвечает ли он вообще (обычно тривиальный эндпоинт вроде /healthz или /api/live у backend «Заметок», который возвращает 200 без обращений к зависимостям). Перезапуск лечит только то, что находится внутри контейнера: зависание, исчерпание потоков, утечку, после которой процесс перестал отвечать. Недоступность базы данных перезапуском backend не лечится, поэтому не должна вызывать перезапуска. readinessProbe может учитывать готовность самого экземпляра: прогрет ли кэш, установлено ли соединение с базой при старте. Но и здесь нужна осторожность: если готовность всех копий зависит от одной общей базы, её отказ уберёт из Service все копии разом, и клиенты вместо осмысленной ошибки «база недоступна, попробуйте позже» получат отказ в соединении. Часто лучше, чтобы приложение оставалось готовым и само отвечало кодом 503 на запросы, которым нужна база. Этот сценарий воспроизводится в лабораторной работе.
Контроллеры рабочих нагрузок
ReplicaSet и Deployment
ReplicaSet поддерживает заданное число подов по шаблону. Deployment управляет ReplicaSet'ами и добавляет то, чего у ReplicaSet нет: версии шаблона и стратегию перехода между ними 11. Для каждой версии шаблона пода Deployment создаёт отдельный ReplicaSet, имя которого содержит хеш шаблона, — тот же хеш записывается в метку pod-template-hash его подов, чтобы селекторы разных ReplicaSet не пересекались. Обновление Deployment сводится к изменению числа реплик двух ReplicaSet: нового — вверх, старого — вниз. Старые ReplicaSet с нулём реплик сохраняются (по умолчанию 10, поле revisionHistoryLimit), и откат kubectl rollout undo — это просто масштабирование старого ReplicaSet обратно.
Минимальный разумный манифест backend «Заметок» выглядит так (образ notes-backend:1.0 собирается в курсовом проекте):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend
  namespace: notes
spec:
  replicas: 3
  selector:
    matchLabels:
      app: notes
      component: backend
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: notes
        component: backend
    spec:
      containers:
        - name: backend
          image: notes-backend:1.0
          ports:
            - name: http
              containerPort: 3000
          resources:
            requests:
              cpu: 200m
              memory: 192Mi
            limits:
              memory: 256Mi
          readinessProbe:
            httpGet:
              path: /api/health
              port: http
            periodSeconds: 5
          livenessProbe:
            httpGet:
              path: /api/live
              port: http
            periodSeconds: 10
            failureThreshold: 3
Разберём поля, которые определяют поведение. spec.selector должен совпадать с метками шаблона, и после создания его нельзя изменить. replicas: 3 — желаемое число копий; если Deployment управляется HPA, это поле лучше не указывать в манифесте, чтобы повторный kubectl apply не сбрасывал решение автомасштабирования. В resources задан запрос процессора без лимита и лимит памяти с запасом над запросом — класс Burstable. readinessProbe использует /api/health, проверяющий базу: копия, которая не может достучаться до базы, не получает трафик. livenessProbe использует /api/live, который отвечает 200 без обращения к базе, то есть проверяет только «процесс жив и обслуживает HTTP». Изменение любого поля внутри template — образа, переменной окружения, пробы — создаёт новую версию шаблона и запускает обновление; изменение replicas обновления не вызывает.
Альтернатива стратегии RollingUpdate — Recreate: сначала удалить все старые поды, потом создать новые. Она даёт простой, но нужна, когда две версии не могут работать одновременно, например если новая версия меняет схему базы данных несовместимо со старой.
Постепенное обновление по шагам
Стратегия RollingUpdate задаётся двумя параметрами 11. maxSurge — сколько подов сверх replicas можно создать во время обновления. maxUnavailable — на сколько число доступных подов может опуститься ниже replicas. Оба задаются числом или процентом от replicas; при пересчёте процента maxSurge округляется вверх, а maxUnavailable — вниз. Значения по умолчанию — 25 % и 25 %. Оба параметра не могут одновременно быть нулём, иначе обновление не сможет сделать ни шага.
Для 10 реплик со значениями по умолчанию: \lceil 10 \cdot 0{,}25 \rceil = \lceil 2{,}5 \rceil = 3 и \lfloor 2{,}5 \rfloor = 2. Значит, во время обновления подов будет не больше 10 + 3 = 13, а доступных — не меньше 10 - 2 = 8. Контроллер Deployment на каждой итерации проверяет оба ограничения: он увеличивает новый ReplicaSet, пока общее число подов не достигнет 13, и уменьшает старый, пока число доступных не опустится до 8. Дальше он ждёт, пока новые поды станут готовыми, и повторяет.
Рисунок ниже показывает обновление при replicas: 4, maxSurge: 1, maxUnavailable: 0. Это самый осторожный режим: доступных подов всегда не меньше четырёх, лишних ресурсов нужно ровно на один под, а обновление идёт по одному поду за шаг.
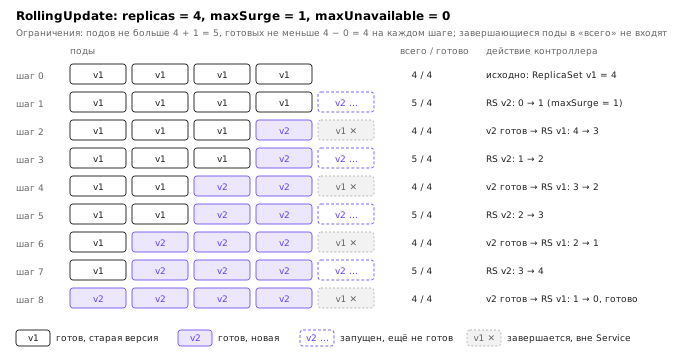
На шаге 1 создаётся один под новой версии; общее число становится 5, это предел. Пока новый под не прошёл readinessProbe, удалять старые нельзя: доступных стало бы 3. Когда он готов (шаг 2), контроллер уменьшает старый ReplicaSet до 3, и освободившееся место позволяет создать следующий новый под. Весь цикл повторяется четыре раза. Отсюда видно, почему readinessProbe — обязательное условие обновления без простоя: без неё под считается готовым, как только запущен процесс, и старые поды удаляются до того, как новые реально могут обслуживать запросы.
Тот же механизм защищает от плохой версии. Если образ новой версии не загружается (ImagePullBackOff) или новые поды не проходят пробу готовности, на шаге 1 обновление останавливается: новый под не становится готовым, старые не удаляются, сервис продолжает работать на старой версии. Через progressDeadlineSeconds (по умолчанию 600 с) Deployment получает условие Progressing=False с причиной ProgressDeadlineExceeded, и kubectl rollout status завершается с ошибкой. Автоматического отката Kubernetes не делает — это решение остаётся за человеком или системой доставки:
kubectl -n lab07 rollout status deployment/echo --timeout=60s
kubectl -n lab07 rollout history deployment/echo
kubectl -n lab07 rollout undo deployment/echo
Waiting for deployment "echo" rollout to finish: 1 out of 4 new replicas have been updated...
error: timed out waiting for the condition
deployment.apps/echo
REVISION  CHANGE-CAUSE
1         <none>
2         <none>
deployment.apps/echo rolled back
При maxUnavailable больше нуля плохая версия успеет заменить часть подов, прежде чем обновление остановится, поэтому выбор параметров — это компромисс между скоростью обновления, запасом ресурсов кластера и риском.
Корректное завершение пода
Отсутствие ошибок во время обновления зависит не только от проб, но и от того, как завершаются старые поды. Когда под удаляется, параллельно происходят две независимые цепочки событий 1112:
- kubelet узла получает отметку удаления, выполняет хук
preStop, если он задан, и посылает основному процессу контейнера SIGTERM. ЧерезterminationGracePeriodSeconds(по умолчанию 30 с) оставшиеся процессы получают SIGKILL; - контроллер EndpointSlice помечает адрес пода как завершающийся и неготовый, kube-proxy на каждом узле получает это изменение через watch и перестраивает правила, Ingress-контроллер обновляет свой список адресов.
Вторая цепочка не мгновенна: она проходит через сервер API и через каждый узел кластера и занимает от долей секунды до нескольких секунд. Если приложение по SIGTERM сразу закрывает порт, часть новых соединений, отправленных по ещё не обновлённым правилам, получит отказ. Это и есть причина редких ошибок «connection refused» во время обновлений, которые не устраняются никакими пробами. Решение — продолжать обслуживание ещё несколько секунд после SIGTERM: приложение перестаёт отвечать «готов» на readinessProbe, доделывает текущие запросы, принимает новые, пока правила не обновятся, и только потом завершается. Если приложение этого не умеет, тот же эффект даёт хук preStop с паузой (команда sleep 5 в контейнере или встроенное действие sleep, которое kubelet выполняет сам, без утилиты sleep в образе). Сюда же относится урок темы 5: SIGTERM должен дойти до приложения, то есть процесс приложения должен быть PID 1 или получать сигнал от корректного init-процесса, иначе каждый под будет ждать все 30 секунд до SIGKILL.
Учебный сервис лабораторной работы реализует именно такое поведение: после SIGTERM он SHUTDOWN_DELAY секунд отвечает 503 на /readyz, но продолжает обслуживать запросы, и в работе можно сравнить число ошибок при задержке 5 с и при нулевой.
DaemonSet, Job и CronJob
Deployment подходит для сервисов без состояния, где копии взаимозаменяемы и их число задаётся. Другие формы нагрузки обслуживают другие контроллеры:
| Контроллер | Что обеспечивает | Типичное применение |
|---|---|---|
| Deployment | N взаимозаменяемых копий, постепенное обновление | веб-сервисы, API, backend «Заметок» |
| StatefulSet | N копий с устойчивыми именами и томами, упорядоченный запуск | базы данных, брокеры; подробно — в теме 8 |
| DaemonSet | ровно один под на каждом подходящем узле | агенты узлов: сбор журналов и метрик, CNI, kube-proxy |
| Job | под или несколько подов выполняются до успешного завершения | миграция схемы БД, пакетная обработка |
| CronJob | создаёт Job по расписанию в формате cron | ночное резервное копирование, очистка |
DaemonSet не использует replicas: число подов равно числу подходящих узлов, и при добавлении узла под на нём появляется автоматически. Поды DaemonSet получают допуски к unreachable и not-ready без ограничения времени, поэтому никогда не выселяются с недоступного узла — им некуда переезжать, их место именно на этом узле 8. Job отличается от Deployment смыслом успеха: завершение контейнера с кодом 0 — это не сбой, который нужно лечить перезапуском, а выполненная работа. У пода Job restartPolicy равна OnFailure или Never, а поле backoffLimit (по умолчанию 6) ограничивает число повторов при неудаче. CronJob добавляет расписание и политику одновременного выполнения concurrencyPolicy: разрешить, запретить или заменить предыдущий незавершённый запуск. Для «Заметок» естественное применение Job — миграция схемы перед обновлением backend, CronJob — ежесуточный дамп базы в объектное хранилище (тема 10).
Сеть сервисов и автомасштабирование
Service, EndpointSlice и kube-proxy
Сетевая модель Kubernetes требует, чтобы каждый под имел собственный IP-адрес и мог обратиться к любому другому поду кластера по этому адресу без трансляции адресов. Реализует модель сетевой модуль (англ. Container Network Interface, CNI), например kindnet в minikube, Calico или Cilium. Но адреса подов непригодны как точка обращения: при каждом пересоздании под получает новый адрес, а копий много. Эту задачу решает Service — объект, дающий группе подов устойчивое имя и устойчивый виртуальный адрес. Устройство показано на рисунке ниже.
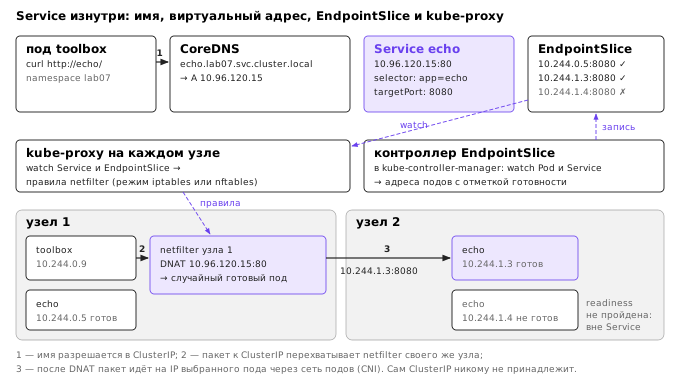
Service с селектором app: echo получает адрес из выделенного диапазона, ClusterIP. Этот адрес не принадлежит ни одному интерфейсу и ни одному процессу: на него нельзя ответить ping, его нет в выводе ip addr ни на одном узле. Он существует только как ключ в правилах netfilter. Контроллер EndpointSlice следит за подами и сервисами и для каждого Service поддерживает объекты EndpointSlice со списком адресов подходящих подов и их состоянием: ready, serving, terminating 12. Под, не прошедший readinessProbe, остаётся в слайсе, но с ready: false, и трафик на него не направляется. В одном слайсе по умолчанию не больше 100 адресов; у большого сервиса их несколько, и изменение одного пода меняет только один слайс, а не огромный список целиком, как было в старом API Endpoints, объявленном устаревшим в Kubernetes 1.33.
kube-proxy на каждом узле подписан на Service и EndpointSlice и программирует ядро узла. В режиме iptables, используемом по умолчанию, это цепочки правил в таблице nat: пакет к 10.96.120.15:80 попадает в цепочку сервиса, где правило со случайным выбором отправляет его в цепочку одного из подов, и там выполняется DNAT на 10.244.1.3:8080 12. Режим nftables (доступен в Linux с ядром 5.13 и новее) делает то же через более эффективный интерфейс ядра и в будущих версиях станет режимом по умолчанию; режим ipvs объявлен устаревшим в Kubernetes 1.35. Некоторые сетевые модули, например Cilium, заменяют kube-proxy полностью программами eBPF. Во всех режимах важно одно: балансировка выполняется в ядре узла-отправителя, при установлении соединения. Отдельного процесса-балансировщика, через который шёл бы трафик, нет; kube-proxy лишь пишет правила. Следствие, которое часто удивляет: долгоживущие соединения, например пул подключений к базе или HTTP/2 с keep-alive, «прилипают» к поду, выбранному при подключении, и не перераспределяются при добавлении новых копий.
Пустой слайс — характерный признак ошибки в селекторе:
kubectl -n lab07 get endpointslices -l kubernetes.io/service-name=web
kubectl -n lab07 describe service web
NAME        ADDRESSTYPE   PORTS     ENDPOINTS   AGE
web-xk2pq   IPv4          <unset>   <unset>     2m
...
Selector:          app=echo,tier=frontend
Endpoints:
Для Service без готовых адресов kube-proxy ставит правило, отвергающее соединение, поэтому клиент получает не тайм-аут, а немедленный отказ — «Connection refused».
Типы Service и DNS
Тип Service определяет, откуда он доступен:
| Тип | Как доступен | Механизм |
|---|---|---|
ClusterIP (по умолчанию) | только изнутри кластера | виртуальный адрес и правила kube-proxy на каждом узле |
NodePort | снаружи по адрес_любого_узла:порт | к ClusterIP добавляется порт из диапазона 30000–32767 на каждом узле |
LoadBalancer | снаружи по адресу внешнего балансировщика | к NodePort добавляется балансировщик провайдера, его создаёт cloud-controller-manager |
ExternalName | имя-псевдоним | CNAME в DNS на внешнее имя, без проксирования |
headless (clusterIP: None) | изнутри по именам подов | DNS возвращает адреса подов напрямую; используется со StatefulSet (тема 8) |
Каждый следующий из первых трёх типов включает предыдущий. В minikube нет облачного балансировщика, поэтому Service типа LoadBalancer остаётся с внешним адресом <pending>, пока не запущен minikube tunnel.
Имена сервисов разрешает CoreDNS. Service echo в пространстве имён lab07 получает имя echo.lab07.svc.cluster.local, где cluster.local — домен кластера. kubelet записывает в /etc/resolv.conf каждого пода адрес CoreDNS и список доменов поиска:
search lab07.svc.cluster.local svc.cluster.local cluster.local
nameserver 10.96.0.10
options ndots:5
Поэтому под из lab07 может обращаться к сервису просто как echo, а к сервису другого пространства имён — как db.notes. Параметр ndots:5 означает: если в имени меньше пяти точек, сначала перебираются домены поиска и только потом имя пробуется как есть. У этого есть цена. Запрос к внешнему api.example.com (две точки) порождает сначала запросы api.example.com.lab07.svc.cluster.local, api.example.com.svc.cluster.local, api.example.com.cluster.local — все с ответом «нет такого имени», — и только четвёртым идёт правильный; если клиент запрашивает и A, и AAAA, запросов вдвое больше. Для приложений, активно обращающихся к внешним именам, это заметная нагрузка на CoreDNS и добавка к задержке; помогает запись полного имени с точкой на конце (api.example.com.).
Ingress и Gateway API
Service решает задачу балансировки на транспортном уровне: он не видит HTTP, не различает имена хостов и пути. Публиковать каждый HTTP-сервис отдельным LoadBalancer дорого — это отдельный внешний адрес и отдельный облачный балансировщик на каждый сервис. Ingress — объект, описывающий правила маршрутизации HTTP и HTTPS снаружи кластера к сервисам внутри: по имени хоста и префиксу пути, с завершением TLS 13. Например, для «Заметок» можно направить запросы notes.example.com/api/... прямо в Service backend, а остальные — в Service frontend (в курсовом проекте выбран более простой вариант: весь трафик идёт во frontend, а тот сам проксирует /api в backend).
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: notes
  namespace: notes
spec:
  ingressClassName: nginx
  rules:
    - host: notes.example.com
      http:
        paths:
          - path: /api
            pathType: Prefix
            backend:
              service:
                name: backend
                port:
                  number: 3000
          - path: /
            pathType: Prefix
            backend:
              service:
                name: frontend
                port:
                  number: 80
pathType: Prefix сравнивает путь по элементам, разделённым /: правило /api подходит к /api и /api/notes, но не к /apinotes. Exact требует точного совпадения, ImplementationSpecific оставляет решение контроллеру 13. При нескольких подходящих путях выбирается самый длинный префикс, поэтому порядок правил в манифесте неважен.
Сам объект Ingress ничего не делает. Его исполняет Ingress-контроллер — обычное приложение в кластере, чаще всего обратный прокси (nginx, HAProxy, Envoy, Traefik), которое подписано на объекты Ingress, Service и EndpointSlice и перестраивает свою конфигурацию. Поле ingressClassName указывает, какой из установленных контроллеров отвечает за данный Ingress. Без контроллера Ingress создаётся без ошибок и просто не работает — это ещё один пример «допустимого, но бездействующего» объекта. Сам контроллер публикуется наружу Service'ом типа LoadBalancer или NodePort, так что внешний балансировщик нужен один на все HTTP-сервисы. Большинство контроллеров, в том числе ingress-nginx, отправляют запросы прямо на адреса подов из EndpointSlice, минуя ClusterIP и kube-proxy: так они сами выбирают под и могут держать с ним постоянные соединения.
У API Ingress есть известные ограничения: в нём нет стандартных средств для разделения трафика по весам, перезаписи заголовков, маршрутизации не-HTTP протоколов, и всё это каждый контроллер добавляет своими аннотациями, несовместимыми между реализациями. Поэтому проект Kubernetes заморозил API Ingress: он остаётся стабильным и поддерживаемым, но не развивается, а рекомендуемой заменой назван Gateway API 13. Gateway API разделяет роли тремя типами объектов: GatewayClass описывает реализацию (аналог ingressClassName), Gateway — конкретную точку входа с адресами, портами и сертификатами, которой управляет администратор кластера, а HTTPRoute (а также GRPCRoute и другие) — маршруты приложения, которые пишут разработчики в своих пространствах имён. Веса, заголовки, зеркалирование трафика выражаются стандартными полями. Здесь важно не смешивать две разные вещи — API и его реализацию. Ресурс Ingress — часть API Kubernetes; он заморожен, но остаётся стабильным и поддерживается всеми версиями кластера. Ingress-контроллер — отдельный проект со своей судьбой. Самый распространённый из них, ingress-nginx, снят с поддержки: в ноябре 2025 года проект Kubernetes объявил о прекращении его развития, последние обновления вышли в марте 2026 года, и репозиторий переведён в архив. Новых версий и исправлений уязвимостей больше не будет, хотя существующие установки продолжают работать, а образы остаются доступными. Те же объекты Ingress продолжают обслуживать другие контроллеры — Traefik, HAProxy, Contour, Cilium и многие другие, — поэтому манифесты Ingress при смене контроллера обычно меняются лишь в поле ingressClassName и в аннотациях, специфичных для контроллера. Дополнение ingress в minikube, используемое в лабораторной работе и на первых этапах курсового проекта, по-прежнему разворачивает ingress-nginx: для изучения API Ingress это не имеет значения, а на этапе 6 курсового проекта контроллер заменяется на Traefik. Для новых промышленных установок направление развития — Gateway API и одна из его реализаций.
Горизонтальное автомасштабирование
HorizontalPodAutoscaler (HPA) — контроллер, который меняет replicas у Deployment (или другого объекта с подресурсом scale) так, чтобы метрика на под держалась около целевого значения 14. Чаще всего метрика — загрузка процессора в процентах от запроса. Данные о потреблении ресурсов HPA получает через Metrics API, который реализует отдельный компонент metrics-server: он периодически опрашивает kubelet каждого узла (интервал задаёт флаг --metric-resolution: 15 с в стандартном манифесте проекта, 60 с в дополнении minikube), хранит последние значения в памяти и отдаёт их через сервер API. Без metrics-server HPA показывает цель как <unknown> и ничего не делает; этот же компонент нужен команде kubectl top.
Каждые 15 секунд контроллер HPA вычисляет
\text{desired} = \left\lceil \text{current} \cdot \frac{\text{currentMetric}}{\text{targetMetric}} \right\rceil,
где current — текущее число реплик, currentMetric — среднее значение метрики по подам, targetMetric — целевое 14. Пример: у backend три копии с запросом cpu: 200m и целью 50 %, то есть 100m на под. Под нагрузкой средняя загрузка — 180m, или 90 % от запроса. Тогда \lceil 3 \cdot 90/50 \rceil = \lceil 5{,}4 \rceil = 6: HPA увеличивает число копий до шести. Если нагрузка не изменилась, суммарное потребление 540m распределится на шесть подов по 90m, или 45 %, и следующий расчёт даст \lceil 6 \cdot 45/50 \rceil = \lceil 5{,}4 \rceil = 6 — система пришла в равновесие.
Формула дополнена правилами, без которых она раскачивала бы систему 14:
- допуск (англ. tolerance) 0,1: если отношение текущего значения к целевому лежит между 0,9 и 1,1, масштабирование не выполняется. Четыре копии при загрузке 54 % дают отношение 1,08 и ничего не меняют, хотя формула дала бы \lceil 4{,}32 \rceil = 5;
- окно стабилизации при уменьшении — по умолчанию 300 секунд: HPA выбирает наибольшую из рекомендаций за последние 5 минут, поэтому после спада нагрузки копии убираются не сразу, а через 5 минут. Увеличение по умолчанию выполняется без окна, но не больше чем на 100 % или на 4 пода (что больше) за 15 секунд. Оба поведения настраиваются в
spec.behavior; - только что запущенные поды учитываются осторожно: в первые 5 минут после старта (
--horizontal-pod-autoscaler-cpu-initialization-period) загрузка процессора пода игнорируется, если он не готов или замер сделан не целиком в период готовности. Иначе всплеск процессора при прогреве нового пода вызывал бы новое масштабирование.
HPA работает только с подами, у которых задан запрос процессора: процент считается от запроса, и без него нечего делить. HPA меняет число подов, но не узлов: если новые копии не помещаются на узлы, они останутся в Pending, и добавить узлы может только отдельный компонент — Cluster Autoscaler или аналог в облаке. Наконец, HPA реагирует с запаздыванием: до одного интервала metrics-server на обновление метрик, до 15 секунд на цикл HPA, затем время на размещение, загрузку образа и прохождение readinessProbe. От резкого всплеска трафика он не спасает; запас ёмкости (minReplicas) нужен всё равно.
Диагностика, ограничения и типичные ошибки интерпретации
Состояния пода и где искать причину
Большинство проблем с подами проявляется одним из нескольких состояний в столбце STATUS команды kubectl get pods. Это не фаза пода в строгом смысле (фаз всего пять: Pending, Running, Succeeded, Failed, Unknown), а краткая сводка, которую kubectl собирает из фазы и причин ожидания или завершения контейнеров. Порядок диагностики почти всегда один: kubectl get pods -o wide → kubectl describe pod (раздел Events внизу и Last State контейнера) → kubectl logs, для упавшего контейнера — kubectl logs --previous.
| Состояние | Что означает | Где смотреть | Частые причины |
|---|---|---|---|
Pending, узел не назначен | планировщик не нашёл допустимого узла | событие FailedScheduling | запросы больше свободного по запросам; ограничения без допусков; правила привязки |
ContainerCreating долго | узел назначен, песочница или контейнер не создаются | события пода | проблемы сетевого модуля, загрузка большого образа, тома (тема 8) |
ErrImagePull, ImagePullBackOff | образ не загружается, повторы с растущей задержкой | событие Failed с текстом ошибки реестра | опечатка в имени или теге, нет доступа к закрытому реестру, imagePullPolicy: Always для локального образа |
CrashLoopBackOff | контейнер завершается, kubelet ждёт перед перезапуском | kubectl logs --previous, Last State: Terminated, код выхода | ошибка приложения при старте; неверные аргументы; провал livenessProbe |
OOMKilled | контейнер убит при превышении лимита памяти | Last State: Terminated, Reason: OOMKilled, Exit Code: 137 | лимит меньше реального потребления, утечка памяти |
Running, но READY 0/1 | процесс работает, readinessProbe не проходит | события Unhealthy, EndpointSlice | неверный путь или порт пробы, зависимость недоступна |
Terminating долго | удаление ждёт | узел пода, финализаторы | узел недоступен; приложение игнорирует SIGTERM; финализатор не снят |
Пример вывода для пода, которому не хватило процессора (запрос 3 ядра в кластере из двух узлов по 2 ядра):
kubectl -n lab07 describe pod too-big
...
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  12s   default-scheduler  0/2 nodes are available: 2 Insufficient cpu. preemption: 0/2 nodes are available: 2 No preemption victims found for incoming pod.
Сообщение планировщика построено как сводка фильтрации: сколько узлов отброшено и по какой причине. Слово «preemption» относится к вытеснению подов с меньшим приоритетом, которое планировщик пробует, если под нельзя разместить; здесь вытеснять некого. А так выглядит контейнер, убитый за превышение памяти:
    State:          Waiting
      Reason:       CrashLoopBackOff
    Last State:     Terminated
      Reason:       OOMKilled
      Exit Code:    137
    Restart Count:  3
Код 137 — это 128 + 9, то есть завершение сигналом SIGKILL (тема 5). Сам по себе код 137 не доказывает OOM: тот же код получает контейнер, не успевший завершиться за terminationGracePeriodSeconds. Различает их поле Reason.
Ограничения модели
Декларативная модель с циклами согласования даёт устойчивость, но у неё есть границы, которые нужно знать.
Согласование конечно во времени, но не мгновенно. Между записью объекта и реальным изменением проходят секунды, а при отказах — минуты: 50 секунд на обнаружение недоступного узла, 300 секунд допуска, 15 секунд цикла HPA, задержки CrashLoopBackOff до 5 минут. Любой ответ API «принято» означает только то, что желаемое состояние записано. Скрипты, которые после kubectl apply сразу ждут работающий сервис, должны явно ждать нужного условия (kubectl rollout status, kubectl wait --for=condition=Available).
Kubernetes не делает приложение надёжным само по себе. Он перезапускает процессы и заменяет поды, но не может сделать безопасной повторную обработку запроса, не переносит состояние из памяти упавшего пода и не знает, корректно ли приложение обрабатывает SIGTERM. Две копии backend на одном узле не защищают от отказа узла: для этого нужно правило распределения по узлам, а для отказа зоны доступности — по зонам. Отказоустойчивость складывается из свойств приложения и правильных настроек, а не из самого факта развёртывания в Kubernetes.
Модель ресурсов основана на заявлениях, а не на измерениях. Планировщик верит запросам: завышенные запросы ведут к простаивающим узлам и подам в Pending при почти пустом кластере, заниженные — к перегруженным узлам, дросселированию и вытеснению. Лимит процессора защищает соседей, но добавляет задержку своему приложению. Подбор запросов по фактическому потреблению — постоянная эксплуатационная задача, для которой нужны метрики (тема 12).
Плоскость управления — общая зависимость. etcd с потерянным кворумом или перегруженный сервер API останавливают все контроллеры одновременно. Работающие поды переживают это, но кластер теряет способность реагировать на любые другие отказы. Масштаб тоже ограничен: проект Kubernetes заявляет поддержку кластеров до 5000 узлов и 150 000 подов, а на практике пределы часто наступают раньше — из-за числа объектов и частоты их изменений.
Наконец, сетевые механизмы Service работают на транспортном уровне. Балансировка выполняется при установлении соединения, долгие соединения не перераспределяются, ClusterIP недоступен снаружи кластера и не отвечает на ICMP, а Ingress зависит от установленного контроллера, функциональность которого за пределами базового API не переносится между реализациями.
Типичные ошибки интерпретации
- «Планировщик выбирает наименее загруженный узел». Планировщик сначала отбрасывает узлы, не прошедшие фильтры, а затем складывает оценки многих модулей; оценка ресурсов считается по запросам, а не по фактической загрузке. Самый свободный узел может быть отброшен ограничением, а самый загруженный по факту — выглядеть пустым, если его поды ничего не запросили.
- «Под переезжает на другой узел». Поды не переезжают. При отказе узла или вытеснении контроллер создаёт новый под с новым именем, новым адресом и пустой файловой системой контейнеров; старый под удаляется. Всё, что было в памяти и в слое записи контейнера, теряется (тема 3).
- «Liveness и readiness — одно и то же, можно указать один эндпоинт». Провал
readinessProbeтолько убирает под из балансировки, провалlivenessProbeего перезапускает. Проверка зависимостей вlivenessProbeпревращает отказ базы данных в каскадный перезапуск всех копий сервиса иCrashLoopBackOff. - «Сервис недоступен — значит, сломан Service». Чаще всего Service в порядке, а пуст его EndpointSlice: опечатка в селекторе, поды не проходят
readinessProbeилиtargetPortне совпадает с портом контейнера. Первое, что нужно смотреть, —kubectl get endpointslices -l kubernetes.io/service-name=имя. - «Узел пропал — поды сразу поднимутся на другом». С настройками по умолчанию замена начинается примерно через 5 минут 50 секунд: 50 секунд на признание узла недоступным и 300 секунд допуска. Всё это время ёмкость сервиса снижена.
- «Потеря Control Plane останавливает приложения». Работающие контейнеры, пробы и локальные перезапуски, правила kube-proxy продолжают работать. Останавливается только управление: никакие изменения и восстановление после новых отказов не выполняются.
- «Четыре члена etcd надёжнее трёх». Оба варианта переживают отказ одного члена, но у четырёх кворум больше, и при разделении сети пополам ни одна часть не может продолжать работу.
- «
kubectl applyзавершился успешно — приложение работает». Успехapplyозначает, что объект прошёл проверки и записан в etcd. Запуск подов, загрузка образов и пробы происходят позже и могут не удаться; это проверяется поrollout status, событиям и состоянию подов. - «HPA защитит от всплеска трафика». HPA реагирует за десятки секунд и не добавляет узлы. Он хорошо справляется с плавными суточными колебаниями, но резкий всплеск должен поглощаться запасом
minReplicas.
Итоги темы
Kubernetes превращает набор серверов в единую систему управления контейнерами, построенную на одной идее: пользователь записывает желаемое состояние, а контроллеры в бесконечном цикле приводят к нему фактическое. Контроллеры реагируют на уровень, а не на отдельные события, — они подписываются на изменения через watch, но вычисляют действие по полному текущему состоянию. Поэтому система устойчива к потерянным событиям, перезапускам собственных компонентов и любым причинам расхождения, а сложное поведение складывается из простых контроллеров, каждый из которых отвечает за свой уровень: Deployment управляет ReplicaSet'ами, ReplicaSet — подами, планировщик — назначением узлов, kubelet — контейнерами.
Архитектурно кластер — это хранилище etcd, единственный с ним работающий сервер API и множество клиентов этого API, которые не общаются друг с другом напрямую. etcd согласует записи по Raft и работает, пока доступен кворум \lfloor n/2 \rfloor + 1 членов, поэтому его делают из трёх или пяти машин. Потеря плоскости управления останавливает управление, но не приложения: запущенные контейнеры, пробы и сетевые правила продолжают работать. Отказ узла обнаруживается примерно за 50 секунд, а замена его подов по умолчанию начинается ещё через 300 секунд допуска к ограничению unreachable.
Под — единица размещения с общим сетевым пространством; его ресурсы задаются запросами, по которым планирует планировщик, и лимитами, которые ядро применяет через cgroups, а их сочетание определяет класс QoS и порядок вытеснения. Планировщик фильтрует узлы по запросам, ограничениям и правилам привязки и выбирает лучший по сумме оценок. Три вида проб отвечают на разные вопросы, и главное правило их использования — проба живости не должна зависеть от внешних компонентов. Deployment обновляет приложение, переключая реплики между двумя ReplicaSet в пределах maxSurge и maxUnavailable, и отсутствие простоя обеспечивается сочетанием проб готовности и корректного завершения подов с учётом задержки распространения изменений EndpointSlice.
Сетевая часть строится на Service — устойчивом имени и виртуальном адресе, за которыми стоят EndpointSlice с адресами готовых подов и правила netfilter, записанные kube-proxy на каждом узле. Ingress и пришедший ему на смену Gateway API добавляют маршрутизацию HTTP по именам и путям, а HPA с metrics-server меняет число копий по формуле пропорционального масштабирования с допуском и окном стабилизации. Все эти механизмы объединяет общий способ диагностики: сравнить желаемое с фактическим и по событиям найти звено цепочки, на котором согласование остановилось.
Одна существенная часть приложения пока осталась за рамками темы: конфигурация и данные. Backend «Заметок» нужны параметры подключения и пароль к базе, а PostgreSQL — том, переживающий пересоздание пода. Объектам ConfigMap и Secret, постоянным томам и StatefulSet посвящена тема 8.
Литература
- Burns B., Grant B., Oppenheimer D., Brewer E., Wilkes J. Borg, Omega, and Kubernetes. — Communications of the ACM, 2016, vol. 59, no. 5, P. 50–57. DOI: 10.1145/2890784.
- Ongaro D., Ousterhout J. In Search of an Understandable Consensus Algorithm. — Proceedings of the 2014 USENIX Annual Technical Conference (USENIX ATC '14), 2014, P. 305–319.
- Burns B., Beda J., Hightower K., Evenson L. Kubernetes: Up and Running. 3rd ed. — O'Reilly Media, 2022.
- Kubernetes Documentation. Cluster Architecture. — https://kubernetes.io/docs/concepts/architecture/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Kubernetes API Concepts. — https://kubernetes.io/docs/reference/using-api/api-concepts/ (дата обращения: 22.10.2026).
- etcd Documentation v3.6. Frequently Asked Questions (FAQ). — https://etcd.io/docs/v3.6/faq/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Kubernetes Scheduler. — https://kubernetes.io/docs/concepts/scheduling-eviction/kube-scheduler/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Taints and Tolerations. — https://kubernetes.io/docs/concepts/scheduling-eviction/taint-and-toleration/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Resource Management for Pods and Containers. — https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Configure Liveness, Readiness and Startup Probes. — https://kubernetes.io/docs/tasks/configure-pod-container/configure-liveness-readiness-startup-probes/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Deployments. — https://kubernetes.io/docs/concepts/workloads/controllers/deployment/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Virtual IPs and Service Proxies. — https://kubernetes.io/docs/reference/networking/virtual-ips/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Ingress. — https://kubernetes.io/docs/concepts/services-networking/ingress/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Horizontal Pod Autoscaling. — https://kubernetes.io/docs/concepts/workloads/autoscaling/horizontal-pod-autoscale/ (дата обращения: 22.10.2026).