
Конфигурация и постоянное хранилище в Kubernetes
В теме 7 было показано, как Kubernetes поддерживает желаемое состояние нагрузки: Deployment создаёт ReplicaSet, тот — поды, планировщик выбирает узлы, kubelet запускает контейнеры, а Service даёт им общий адрес. Все поды в этих примерах были взаимозаменяемыми: если под погибал, контроллер создавал новый с другим именем на другом узле, и ничего не терялось, потому что терять было нечего. Такая модель хорошо подходит для backend приложения «Заметки», но не для его базы данных. Остаются два вопроса, на которые тема 7 сознательно не отвечала. Первый: откуда контейнер получает параметры, пароли и конфигурационные файлы, если образ один для всех сред. Второй: где хранить данные, которые должны пережить под, узел и обновление.
Из темы 3 известно, что корневая файловая система контейнера — это слои образа и верхний слой записи overlay2, который исчезает вместе с контейнером. В теме 5 эта проблема решалась на одном хосте Docker-томами и bind mounts: каталог хоста монтировался в контейнер и переживал его пересоздание. В кластере такой приём не работает: под может быть перезапущен на другом узле, где каталога нет, а узел может исчезнуть целиком. Нужен механизм, который отделяет данные от узла, выделяет их по заявке и подключает туда, где запланирован под.
Kubernetes решает обе задачи набором объектов API. Конфигурация хранится в ConfigMap и Secret и доставляется в контейнер переменными окружения или файлами; от способа доставки зависит, увидит ли работающий процесс изменения. Данные хранятся в томах, которые описываются парой PersistentVolume и PersistentVolumeClaim, создаются по профилю StorageClass и подключаются драйвером по стандарту CSI. Приложения, которым нужна устойчивая идентичность и собственный том у каждой реплики, управляются контроллером StatefulSet.
Изложение построено в порядке движения данных. Сначала рассматривается конфигурация и семантика её обновления, затем Secret и то, от чего он на самом деле защищает. Далее — модель томов, жизненный цикл PV, классы хранения и режимы доступа, затем путь тома через CSI от заявки до точки монтирования в поде. Завершают тему StatefulSet, снимки томов и операторы баз данных, а также раздел об ограничениях и типичных ошибках. Сквозной пример — PostgreSQL приложения «Заметки».
Конфигурация вне образа: ConfigMap
Почему конфигурация отделяется от образа
Методология «The Twelve-Factor App» определяет конфигурацию как всё, что меняется между развёртываниями одного и того же кода: адреса баз данных, учётные данные внешних сервисов, флаги функций, уровни журналирования, — и требует хранить её вне кода 1. В контейнерном мире это требование усиливается принципом неизменяемости из темы 5: образ собирается один раз, получает digest и без изменений проходит через тестовую и рабочую среды. Если адрес базы данных зашит в образ, для каждой среды нужен свой образ, и тестировалось уже не то, что выкатывается. Если в образ зашит пароль, он попадает в каждый слой реестра и в каждую копию образа на узлах.
Отсюда два требования к механизму конфигурации. Он должен связывать один образ с разными наборами параметров без пересборки. И он должен быть частью декларативного описания: параметры хранятся в API-сервере как объекты, версионируются в Git вместе с манифестами и попадают в под через тот же цикл согласования, что и всё остальное.
Объект ConfigMap
ConfigMap (англ. ConfigMap) — объект API, хранящий несекретные данные в виде пар «ключ — значение» 2. Значение может быть короткой строкой (LOG_LEVEL: info) или содержимым целого файла (nginx.conf, postgresql.conf). Строковые данные лежат в поле data, двоичные — в binaryData в кодировке base64. Размер объекта ограничен 1 МиБ 2: ConfigMap предназначен для параметров, а не для больших данных.
ConfigMap удобно создавать из файла, чтобы не переписывать содержимое вручную в YAML:
kubectl create configmap pg-config --from-file=postgresql.conf --dry-run=client -o yaml
apiVersion: v1
data:
  postgresql.conf: |
    listen_addresses = '*'
    max_connections = 50
    work_mem = 4MB
kind: ConfigMap
metadata:
  name: pg-config
Сам по себе ConfigMap ни на что не влияет: это просто данные в etcd. Чтобы приложение их увидело, под должен на них сослаться, а приложение — прочитать. Для PostgreSQL это означает, что файл нужно не только смонтировать, но и указать серверу: postgres -c config_file=/etc/postgresql/postgresql.conf. Смонтированный в произвольный каталог файл, на который сервер не смотрит, остаётся мёртвым грузом, и проверять применение конфигурации нужно со стороны приложения (SHOW max_connections;), а не по наличию файла.
Три способа доставки в контейнер
Данные ConfigMap попадают в контейнер тремя способами, и различия между ними важнее, чем кажется по синтаксису.
Первый способ — переменные окружения: отдельный ключ через env.valueFrom.configMapKeyRef или все ключи сразу через envFrom.configMapRef. Значения подставляются kubelet при создании контейнера; через переменные их можно передать и в аргументы команды: запись $(VAR) в command или args раскрывается Kubernetes до запуска процесса.
Второй способ — том типа configMap: каждый ключ становится файлом в смонтированном каталоге. Список items позволяет выбрать отдельные ключи и переименовать файлы, defaultMode — задать права.
Третий способ — тот же том, но смонтированный с полем subPath: в заданный путь контейнера подключается не каталог, а один файл из тома. Так поступают, когда нужно положить файл в каталог, где уже есть другие файлы образа (например, /etc/nginx/conf.d/default.conf), и монтирование целого каталога спрятало бы их.
containers:
  - name: probe
    image: busybox:1.37.0
    env:
      - name: LEVEL                  # способ 1: переменная окружения
        valueFrom:
          configMapKeyRef:
            name: probe-config
            key: level
    volumeMounts:
      - name: cfg                    # способ 2: каталог /cfg-dir/level
        mountPath: /cfg-dir
      - name: cfg                    # способ 3: один файл через subPath
        mountPath: /cfg-sub/level
        subPath: level
volumes:
  - name: cfg
    configMap:
      name: probe-config
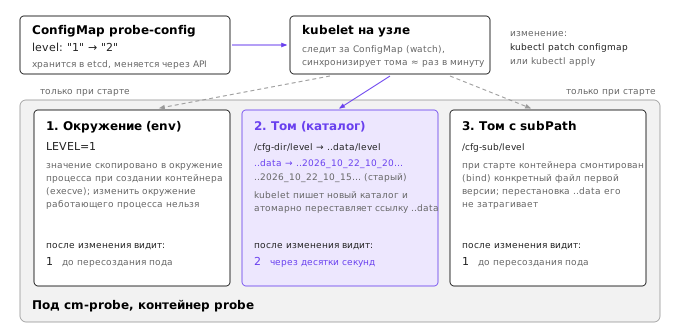
Схема на рисунке ниже показывает, что физически стоит за каждым способом: копия значения в окружении процесса, каталог на узле, который kubelet обновляет, и bind-монтирование конкретного файла, привязанное к его первой версии.
Обновление конфигурации: что видит работающий процесс
Когда ConfigMap изменён в API-сервере, вопрос «применилась ли конфигурация» распадается на два: обновились ли данные внутри контейнера и перечитал ли их процесс.
Переменные окружения процесса — это копия, сделанная при execve. Ни Linux, ни Kubernetes не умеют менять окружение работающего процесса, поэтому значение в env остаётся прежним до пересоздания контейнера 2.
Том configMap kubelet обновляет сам. Устроен он так: в каталоге тома лежит скрытый каталог с меткой времени (..2026_10_22_10_15_00.123456789), символическая ссылка ..data указывает на него, а видимые файлы — это ссылки level -> ..data/level. При обновлении kubelet записывает новый каталог с меткой времени и атомарно переставляет ссылку ..data вызовом rename. Приложение никогда не видит наполовину записанный набор файлов: либо все старые, либо все новые.
Вид каталога изнутри контейнера (вывод сокращён; метка времени будет другой):
kubectl exec cm-probe -- ls -la /cfg-dir
drwxr-xr-x    2 root  root   60 Oct 22 10:15 ..2026_10_22_10_15_00.123456789
lrwxrwxrwx    1 root  root   32 Oct 22 10:15 ..data -> ..2026_10_22_10_15_00.123456789
lrwxrwxrwx    1 root  root   12 Oct 22 10:15 level -> ..data/level
Задержка обновления не нулевая. Документация оценивает её как период синхронизации kubelet плюс задержку распространения кэша; при стратегии по умолчанию (watch) последняя мала, а период синхронизации по умолчанию — 1 минута 2. На практике новое содержимое появляется в поде через десятки секунд, в худшем случае — немного больше минуты, и рассчитывать на мгновенное применение нельзя.
Монтирование через subPath не обновляется никогда 2. Причина в механизме: при старте контейнера kubelet разрешает путь level внутри тома (а это ссылка на файл в каталоге с меткой времени) и делает bind-монтирование конкретного файла. Когда kubelet создаёт новый каталог и переставляет ..data, смонтированный файл по-прежнему указывает на старый inode, и контейнер продолжает видеть первую версию.
| Способ доставки | Где хранится значение | Обновляется в работающем поде | Что нужно для применения |
|---|---|---|---|
env, envFrom | окружение процесса | нет | пересоздать под |
args с $(VAR) | аргументы командной строки | нет | пересоздать под |
| том configMap (каталог) | каталог kubelet на узле | да, с задержкой порядка минуты | процесс должен перечитать файл |
том с subPath | bind-монтирование одного файла | нет | пересоздать под |
Последний столбец не менее важен, чем предпоследний. Новый файл в каталоге ещё не означает новой конфигурации: nginx перечитывает её по сигналу SIGHUP (nginx -s reload), PostgreSQL — по вызову SELECT pg_reload_conf(), а многие приложения читают конфигурацию только при старте. Даже после перечитывания часть параметров не применяется: в PostgreSQL work_mem или log_statement меняются на лету, а max_connections и shared_buffers требуют перезапуска сервера, о чём сообщает столбец pending_restart представления pg_settings 14.
Поэтому в эксплуатации применяют два приёма, которые делают обновление предсказуемым. Первый — хэш конфигурации в аннотации шаблона пода: инструмент развёртывания вычисляет SHA-256 от содержимого ConfigMap и записывает его в spec.template.metadata.annotations. Изменилась конфигурация — изменился шаблон — Deployment или StatefulSet выполняет штатное поэтапное обновление из темы 7, с пробами готовности и возможностью отката. Тот же эффект даёт генератор Kustomize, добавляющий хэш к имени ConfigMap (pg-config-7b9k2m5f4c), и ручная команда kubectl rollout restart, которая записывает в шаблон аннотацию с временем перезапуска. Второй приём — неизменяемые ConfigMap (immutable: true, стабильно с Kubernetes 1.21): объект нельзя изменить, только создать новый под другим именем, а kubelet перестаёт следить за ним, что снижает нагрузку на API-сервер в больших кластерах 2.
Secret: что он защищает и чего не защищает
Устройство объекта Secret
Secret (англ. Secret) — объект API для небольших объёмов конфиденциальных данных: паролей, токенов, ключей TLS 3. Синтаксически он почти совпадает с ConfigMap и доставляется в контейнер теми же тремя способами с той же семантикой обновления. Отличия — в поле type и в обращении с данными на узле.
Поле type задаёт ожидаемую структуру: Opaque — произвольные ключи, kubernetes.io/tls — обязательные tls.crt и tls.key, kubernetes.io/dockerconfigjson — учётные данные реестра образов, kubernetes.io/basic-auth и kubernetes.io/ssh-auth — типовые учётные данные. Тип проверяется API-сервером, но на хранение не влияет.
В поле data значения записываются в base64, в поле stringData — открытым текстом, который API-сервер сам перекодирует при записи. Base64 — кодирование, а не шифрование: оно нужно, чтобы в JSON и YAML помещались произвольные байты, и обращается одной командой без всякого ключа. Шестибайтовый пароль s3cr3t превращается в восемь символов czNjcjN0 (base64 увеличивает объём в 4/3 раза), и любой, кто видит манифест, видит и пароль:
kubectl -n lab08 get secret pg-auth -o jsonpath='{.data.POSTGRES_PASSWORD}' | base64 -d
Там, где Secret всё же обрабатывается иначе, чем ConfigMap, речь идёт об узле. Kubelet получает секрет только для подов, запланированных на этот узел, и при монтировании тома хранит его копию в tmpfs — в оперативной памяти, а не на диске узла 3. Команда kubectl describe secret показывает только имена ключей и размеры значений. Это защита от случайного раскрытия, а не от злоумышленника с правами в кластере.
Кто может прочитать секрет
Значение Secret доступно каждому, кто может получить объект через API: RBAC-правила с глаголами get, list или watch на ресурс secrets в пространстве имён дают доступ ко всем его секретам. Ошибка понимания здесь распространённая: list выглядит как «посмотреть список», но ответ на него содержит объекты целиком, вместе с данными.
Документация указывает и на менее очевидный канал: любой, кто может создать под в пространстве имён, может смонтировать в него любой Secret этого пространства и прочитать его изнутри контейнера 3. Права на создание Deployment, Job или CronJob эквивалентны тому же. Поэтому граница доступа к секретам на деле — пространство имён, а не отдельный объект, и секреты разных команд держат в разных пространствах. Подробная настройка RBAC — в теме 11.
Ещё три канала связаны с доставкой. Переменная окружения видна в /proc/PID/environ любому процессу с правами того же пользователя, наследуется дочерними процессами и нередко попадает в журналы и отчёты об аварии; файл в томе этих недостатков лишён, поэтому для секретов монтирование предпочтительнее. Секрет, созданный командой kubectl create secret --from-literal=password=..., остаётся в истории оболочки и виден в списке процессов во время выполнения. И наконец, резервная копия etcd содержит все секреты кластера — а в каком виде, зависит от настройки шифрования.
Шифрование в etcd: EncryptionConfiguration
По умолчанию Secret хранится в etcd незашифрованным 3. API-сервер сериализует объект в protobuf и записывает в ключ /registry/secrets/<namespace>/<name>; любой, у кого есть доступ к etcd, его снимку или диску узла управления, читает пароли без всякого ключа. Для минимальных кластеров вроде minikube или kubeadm с настройками по умолчанию это именно так; управляемые облачные кластеры, как правило, включают шифрование на стороне провайдера, но это нужно проверять в документации конкретного сервиса, а не предполагать.
Шифрование включается флагом API-сервера --encryption-provider-config, который указывает на файл EncryptionConfiguration 4:
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
      - secrets
    providers:
      - secretbox:                 # первый провайдер шифрует новые записи
          keys:
            - name: key1
              secret: <32 байта в base64>
      - identity: {}               # позволяет читать ещё не зашифрованные объекты
Порядок провайдеров имеет смысл. Первый в списке используется для записи, все — для чтения: API-сервер узнаёт, каким провайдером зашифрован объект, по префиксу значения вида k8s:enc:secretbox:v1:key1:. Провайдер identity означает «без шифрования»; если он стоит первым, шифрования нет, и именно такова конфигурация по умолчанию 4.
Документация сравнивает провайдеры по стойкости и удобству. aescbc не рекомендуется из-за уязвимости режима CBC к атаке padding oracle, aesgcm требует ротации ключа каждые 200 000 записей, secretbox (XSalsa20 и Poly1305) — быстрый и стойкий вариант с локальным ключом 4. У всех трёх ключ лежит в файле на узле управления, и злоумышленник, получивший этот узел, получает и ключ. Провайдер kms v2 (стабилен с Kubernetes 1.29) использует конвертное шифрование: данные шифруются ключом данных, а тот — ключом во внешней службе управления ключами (облачный KMS, HSM, Vault), который никогда не покидает её 4.
Включение шифрования не трогает уже записанные объекты: они остаются открытыми до следующей записи. Поэтому после перезапуска API-сервера все секреты перезаписывают, а результат проверяют прямо в etcd:
kubectl get secrets --all-namespaces -o json | kubectl replace -f -
etcdctl get /registry/secrets/default/secret1 | hexdump -C | head -3
00000000  2f 72 65 67 69 73 74 72  79 2f 73 65 63 72 65 74  |/registry/secret|
00000010  73 2f 64 65 66 61 75 6c  74 2f 73 65 63 72 65 74  |s/default/secret|
00000020  31 0a 6b 38 73 3a 65 6e  63 3a 61 65 73 63 62 63  |1.k8s:enc:aescbc|
Пример вывода взят из документации и показывает провайдер aescbc 4; без шифрования в том же месте был бы виден protobuf с именами ключей и значениями открытым текстом.
Внешние хранилища секретов
Шифрование в etcd закрывает только один канал — носитель данных. Остаются две задачи, которые Secret не решает: как хранить секреты в Git вместе с остальными манифестами и как управлять их ротацией и аудитом централизованно. Для них используются внешние инструменты; ни один не отменяет остальных мер, потому что почти все в итоге создают обычный Secret в кластере.
| Инструмент | Где хранится исходный секрет | Как попадает в под | Когда выбирать |
|---|---|---|---|
| Sealed Secrets | в Git, зашифрован открытым ключом контроллера | контроллер расшифровывает SealedSecret в Secret | GitOps без внешнего хранилища, один кластер |
| SOPS | в Git, зашифрованы значения в YAML (age, PGP, облачный KMS) | расшифровка при развёртывании (Flux, плагины Argo CD) | GitOps, ключ в KMS, читаемые диффы |
| External Secrets Operator | во внешнем хранилище (Vault, AWS Secrets Manager и др.) | оператор периодически синхронизирует в Secret | секреты уже живут во внешнем хранилище, нужна ротация |
| Vault Agent или Secrets Store CSI Driver | во внешнем хранилище | файл в томе пода, без объекта Secret | нужно исключить секрет из etcd, короткоживущие учётные данные |
Sealed Secrets устроен асимметрично: утилита kubeseal шифрует секрет открытым ключом контроллера, получившийся объект SealedSecret можно хранить в публичном репозитории, а закрытый ключ существует только в кластере. SOPS шифрует значения, оставляя ключи YAML открытыми, поэтому изменения видны в истории Git. External Secrets Operator вводит объекты SecretStore (как подключиться к хранилищу) и ExternalSecret (что из него взять и в какой Secret положить). Vault Agent Injector и Secrets Store CSI Driver доставляют секрет файлом прямо в под; второй — через CSI-драйвер, устроенный так же, как драйверы томов, рассмотренные ниже в разделе о CSI. Наиболее сильная модель — динамические учётные данные: Vault создаёт пользователя PostgreSQL на время жизни пода и удаляет его по истечении срока, так что утечка пароля перестаёт быть вечной.
Тома и постоянное хранилище: PV, PVC и StorageClass
От слоя записи к тому
Том (англ. volume) в Kubernetes — каталог, доступный контейнерам пода и подключаемый в их файловые системы через volumeMounts. Тома делятся на эфемерные, живущие столько же, сколько под, и постоянные, существующие независимо от него.
Самый простой эфемерный том — emptyDir: пустой каталог на диске узла (или в памяти при medium: Memory), создаваемый при размещении пода и удаляемый вместе с ним. Он переживает перезапуск контейнера, в отличие от слоя записи overlay2, но не переживает пересоздание пода. Его типичное назначение — обмен файлами между контейнерами пода и кэш. Тома configMap и secret из предыдущих разделов тоже эфемерные. Том hostPath монтирует каталог узла, как bind mount из темы 5, и наследует его недостатки: данные привязаны к узлу, а под получает доступ к его файловой системе, что в многопользовательском кластере опасно.
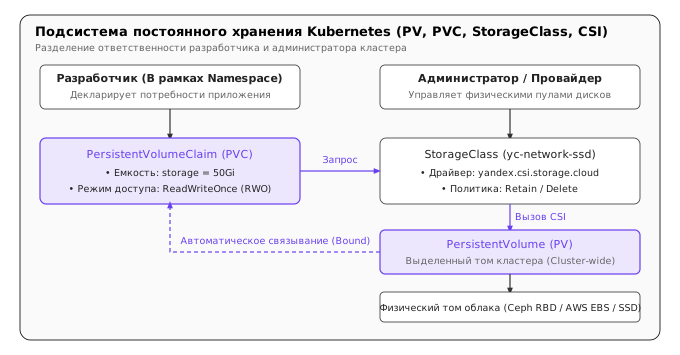
Постоянному хранилищу нужны два свойства, которых нет у перечисленного: данные не должны зависеть от узла и должны выделяться по запросу, без ручной работы администратора для каждого приложения. Kubernetes разделяет эту задачу между тремя объектами. Схема на рисунке ниже показывает разделение ответственности: разработчик описывает потребность (заявку), администратор — профили хранилища, а драйвер превращает одно в другое.
PersistentVolume и PersistentVolumeClaim
PersistentVolume (PV) — объект уровня кластера, представляющий конкретный экземпляр хранилища: облачный диск, LUN системы хранения, экспорт NFS, образ Ceph RBD 5. PV не принадлежит пространству имён и описывает свойства тома: ёмкость, режимы доступа, класс, политику освобождения и источник (для CSI — имя драйвера и идентификатор тома в системе хранения).
PersistentVolumeClaim (PVC) — заявка на хранилище в пространстве имён приложения: «нужно 10 ГиБ класса standard с доступом ReadWriteOnce». Под ссылается на заявку, а не на том, поэтому манифест приложения не меняется от того, работает ли кластер в облаке или в собственном центре обработки данных 12.
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: scratch
  namespace: lab08
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: standard     # пропущено — класс по умолчанию; "" — без динамического выделения
  resources:
    requests:
      storage: 100Mi
Связывание (англ. binding) выполняет контроллер томов в kube-controller-manager. Он ищет PV, который удовлетворяет заявке по классу, режимам доступа, ёмкости (не меньше запрошенной) и селектору, и записывает связь в обе стороны: в PV — поле claimRef с именем и UID заявки, в PVC — volumeName. Связь взаимно-однозначная: один PV связан не более чем с одной заявкой, даже если ёмкость тома больше запрошенной 5. Если подходящего тома нет и класс допускает динамическое выделение, том создаётся по заявке; если нет и этого, PVC остаётся в фазе Pending, а использующий его под — неразмещённым.
Жизненный цикл PV и политика освобождения
У PV четыре фазы 5. Available — том свободен. Bound — связан с заявкой. Released — заявка удалена, но том ещё не возвращён в оборот. Failed — автоматическое освобождение не удалось. У PVC фазы Pending, Bound и Lost (связанный том исчез). Диаграмма на рисунке ниже показывает переходы и роль политики освобождения.
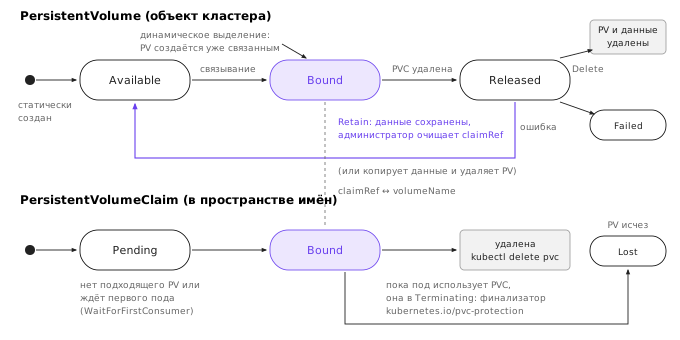
Что случится с данными при kubectl delete pvc, определяет поле PV persistentVolumeReclaimPolicy. При Delete том удаляется вместе с объектом PV и данными в системе хранения; это значение по умолчанию для динамически созданных томов, наследуемое из reclaimPolicy класса. При Retain объект PV переходит в Released, данные остаются, но новая заявка к такому тому сама не привяжется: в claimRef ещё записан UID удалённой заявки. Администратор либо копирует данные и удаляет PV, либо очищает claimRef, после чего том становится Available. Политика Recycle (rm -rf содержимого) объявлена устаревшей 5.
kubectl patch pv pvc-3f1c... -p '{"spec":{"persistentVolumeReclaimPolicy":"Retain"}}'
kubectl delete pvc scratch
kubectl get pv
NAME          CAPACITY   ACCESS MODES   RECLAIM POLICY   STATUS     CLAIM           STORAGECLASS
pvc-3f1c...   100Mi      RWO            Retain           Released   lab08/scratch   standard
Удаление защищено финализаторами. Пока заявку использует хотя бы один под, финализатор kubernetes.io/pvc-protection не даёт ей исчезнуть: kubectl delete pvc переводит её в состояние Terminating, и удаление завершается после остановки пода 5. Аналогично kubernetes.io/pv-protection защищает связанный PV. Это частая причина «зависшего» удаления, и чинится она не снятием финализатора, а поиском пода, который держит том.
Политику полезно выбирать по ценности данных. Для базы данных рабочей среды Retain в классе хранения — страховка от опечатки в kubectl delete; ценой становится ручная уборка освобождённых томов, которые продолжают занимать место и, в облаке, оплачиваться.
StorageClass и динамическое выделение
Статическое выделение — администратор заранее создаёт PV, заявки связываются с ними — сохранилось для особых случаев (импорт существующего диска, локальные диски), но основной путь — динамическое выделение (англ. dynamic provisioning): том создаётся в ответ на заявку по профилю, описанному объектом StorageClass 6.
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
  annotations:
    storageclass.kubernetes.io/is-default-class: "false"
provisioner: ebs.csi.aws.com           # какой драйвер создаёт тома
parameters:                            # передаются драйверу как есть
  type: gp3
  iops: "3000"
reclaimPolicy: Retain                  # по умолчанию Delete
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true
Поле provisioner называет драйвер, parameters интерпретирует только он (тип диска, число реплик, файловая система). Аннотация is-default-class делает класс классом по умолчанию для заявок без storageClassName; в minikube это класс standard с провайдером k8s.io/minikube-hostpath, который создаёт каталоги внутри узла.
Поле volumeBindingMode определяет момент создания тома. При Immediate (по умолчанию) том создаётся сразу после появления заявки, ещё до того, как известен под и его узел. При WaitForFirstConsumer создание откладывается, пока планировщик не выберет узел для первого пода, использующего заявку; выбор записывается в аннотацию PVC volume.kubernetes.io/selected-node, и драйвер создаёт том в топологии этого узла 6.
Разница существенна в кластере из нескольких зон доступности. Облачный блочный диск существует в одной зоне и подключается только к ВМ той же зоны. Рассмотрим численный пример: кластер в трёх зонах, база данных из трёх реплик со строгим правилом антиаффинности «не более одной реплики в зоне». При Immediate зона каждого диска выбирается без учёта будущего пода; если считать выбор равновероятным и независимым, все три диска окажутся в разных зонах с вероятностью
P = \frac{3!}{3^3} = \frac{6}{27} \approx 0{,}22.
С вероятностью около 0,78 два диска попадут в одну зону, и одна из реплик никогда не будет размещена: планировщик сообщит о конфликте узловой аффинности тома (volume node affinity conflict). При WaitForFirstConsumer сначала выбирается узел с учётом всех ограничений пода, затем в его зоне создаётся диск, и конфликт исключён по построению. По той же причине режим WaitForFirstConsumer обязателен для локальных томов, существующих на одном узле.
Поле allowVolumeExpansion: true разрешает увеличивать заявку: пользователь меняет spec.resources.requests.storage в PVC, драйвер расширяет том, а файловая система расширяется на узле, у большинства CSI-драйверов — без остановки пода 5. Уменьшить том нельзя. Класс хранения после создания почти неизменяем: поменять parameters или reclaimPolicy существующего класса нельзя, и для новых свойств создают новый класс.
Режимы доступа
Поле accessModes описывает, как том может быть подключён 5.
| Режим | Сокращение | Смысл | Типичные системы хранения |
|---|---|---|---|
| ReadWriteOnce | RWO | чтение и запись на одном узле | облачные блочные диски, Ceph RBD, iSCSI |
| ReadOnlyMany | ROX | только чтение на многих узлах | NFS, CephFS, снимки-образы |
| ReadWriteMany | RWX | чтение и запись на многих узлах | NFS, CephFS, облачные файловые хранилища |
| ReadWriteOncePod | RWOP | чтение и запись одним подом во всём кластере | CSI-драйверы с поддержкой режима |
Две детали понимаются неверно чаще всего. Во-первых, RWO ограничивает узел, а не под: несколько подов на одном узле могут одновременно смонтировать RWO-том на запись. Именно для исключения этого введён режим ReadWriteOncePod, стабильный с Kubernetes 1.29 и доступный только для CSI-томов 5. Для базы данных, у которой файлы данных должен открывать ровно один сервер, RWOP точнее выражает требование. Во-вторых, режимы доступа используются для сопоставления заявок и томов и для ограничения подключения, но не обеспечивают защиту от записи после монтирования 5. Том, поддерживающий несколько режимов, в каждый момент подключён в одном из них.
Режим доступа отличается от режима тома volumeMode. При Filesystem (по умолчанию) драйвер создаёт на устройстве файловую систему и монтирует каталог; при Block под получает сырое блочное устройство, что нужно некоторым СУБД и системам хранения, управляющим диском самостоятельно.
Container Storage Interface: как том попадает в под
Зачем понадобился CSI
В ранних версиях Kubernetes код подключения каждой системы хранения — AWS EBS, GCE PD, Cinder, Ceph RBD, GlusterFS — находился в основном репозитории (так называемые встроенные, англ. in-tree, плагины). Исправление ошибки в драйвере требовало выпуска новой версии Kubernetes, производители систем хранения зависели от его цикла выпусков, а ошибка в драйвере могла уронить kubelet. Промежуточное решение FlexVolume требовало устанавливать исполняемые файлы на каждый узел.
Container Storage Interface (CSI) — спецификация gRPC-интерфейса между оркестратором и драйвером хранилища 7. Драйвер работает отдельными контейнерами, Kubernetes обращается к нему через Unix-сокет, а один и тот же драйвер пригоден для любого оркестратора, реализующего спецификацию. Спецификация делит интерфейс на три службы:
- Identity — сведения о драйвере и его возможностях (
GetPluginInfo,GetPluginCapabilities,Probe); - Controller — операции, не привязанные к узлу: создание и удаление томов, подключение к узлу, снимки, расширение;
- Node — операции на конкретном узле: подготовка устройства и монтирование.
Встроенные плагины популярных систем хранения сегодня работают через механизм миграции на CSI: старое поле в PV транслируется в вызовы соответствующего CSI-драйвера, а часть встроенных плагинов удалена из кода полностью 5.
Четыре вызова: путь тома от заявки до точки монтирования
Последовательность на рисунке ниже прослеживает путь тома для заявки на облачный блочный диск. Ключевых вызовов четыре, и выполняются они в строгом порядке 78.
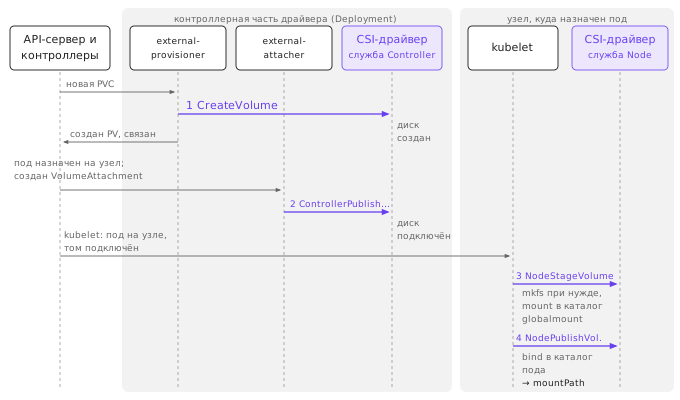
- CreateVolume (служба Controller). Сайдкар external-provisioner видит новую PVC с классом этого драйвера (при
WaitForFirstConsumer— после выбора узла) и вызываетCreateVolumeс размером, параметрами класса и требованиями к топологии. Драйвер создаёт диск через API облака и возвращает его идентификатор; external-provisioner создаёт объект PV, который контроллер томов связывает с заявкой. - ControllerPublishVolume (Controller). Когда под с этой заявкой назначен на узел, контроллер attach/detach в kube-controller-manager создаёт объект VolumeAttachment, сайдкар external-attacher видит его и вызывает
ControllerPublishVolumeс идентификаторами тома и узла. Для облачного диска это вызов API «подключить диск к ВМ»: на узле появляется блочное устройство. Для сетевых файловых систем, где подключать нечего, драйвер объявляет отсутствие этой возможности, и шаг пропускается. - NodeStageVolume (Node). Kubelet на узле вызывает драйвер напрямую через сокет. Драйвер находит устройство, при необходимости создаёт файловую систему и монтирует её в промежуточный каталог узла вида
/var/lib/kubelet/plugins/kubernetes.io/csi/<драйвер>/<хэш>/globalmount. Это делается один раз на узел, сколько бы подов узла ни использовали том. - NodePublishVolume (Node). Kubelet просит драйвер подключить том в каталог конкретного пода
/var/lib/kubelet/pods/<UID пода>/volumes/kubernetes.io~csi/<имя PV>/mount; обычно это bind-монтирование из промежуточного каталога. Именно этот каталог container runtime затем подключает в контейнер поmountPath.
При удалении пода вызовы выполняются в обратном порядке: NodeUnpublishVolume, NodeUnstageVolume (когда том не нужен ни одному поду узла), ControllerUnpublishVolume (отключение диска от ВМ), и при удалении заявки с политикой Delete — DeleteVolume. Разделение stage и publish объясняет поведение RWO: на одном узле устройство подготовлено один раз, и несколько подов узла получают к нему bind-монтирования; на другой узел тот же диск не будет подключён, пока не отключён от первого, и под второго узла ждёт в ContainerCreating с событием Multi-Attach error.
Компоненты драйвера и сайдкары
CSI-драйвер в кластере состоит из двух частей. Контроллерная часть — Deployment (или StatefulSet) из одной-двух реплик с контейнером драйвера и набором стандартных сайдкаров. Узловая часть — DaemonSet, под которого работает на каждом узле с доступом к /dev и каталогам kubelet. Сайдкары — общие для всех драйверов контейнеры проекта kubernetes-csi, которые следят за объектами API и переводят их в вызовы CSI, так что автору драйвера не нужно писать контроллеры Kubernetes 8.
| Компонент | Где работает | Следит за | Вызывает |
|---|---|---|---|
| external-provisioner | контроллерная часть | PVC | CreateVolume, DeleteVolume |
| external-attacher | контроллерная часть | VolumeAttachment | ControllerPublishVolume, ControllerUnpublishVolume |
| external-resizer | контроллерная часть | изменение размера PVC | ControllerExpandVolume |
| external-snapshotter | контроллерная часть | VolumeSnapshotContent | CreateSnapshot, DeleteSnapshot |
| node-driver-registrar | узловая часть | — | регистрирует сокет драйвера в kubelet |
| livenessprobe | обе части | — | Probe для проверки живости |
| kubelet (не сайдкар) | каждый узел | поды узла | NodeStageVolume, NodePublishVolume, NodeExpandVolume |
Объект CSIDriver сообщает Kubernetes свойства драйвера, например attachRequired: false для драйверов без шага подключения к узлу. Объект CSINode хранит, какие драйверы зарегистрированы на узле и какой топологии он принадлежит. Когда под висит в ContainerCreating с событием о неудачном подключении тома, именно по этой цепочке ищут место обрыва: есть ли PV, есть ли VolumeAttachment и в каком он состоянии, что в журналах сайдкара и узловой части драйвера.
Снимки и клонирование: VolumeSnapshot
API снимков томов (стабилен с Kubernetes 1.20) повторяет модель PV и PVC 10. VolumeSnapshotClass — профиль, аналог StorageClass; VolumeSnapshot — запрос пользователя на снимок конкретной PVC в пространстве имён; VolumeSnapshotContent — объект кластера, представляющий снимок в системе хранения, аналог PV. Работу выполняют снимковый контроллер и сайдкар external-snapshotter, вызывающий CreateSnapshot драйвера; поэтому снимки доступны только для CSI-драйверов с этой возможностью, а объекты API — пользовательские ресурсы, которые устанавливаются в кластер отдельно.
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: data-pg-0-before-upgrade
  namespace: lab08
spec:
  volumeSnapshotClassName: csi-snapclass
  source:
    persistentVolumeClaimName: data-pg-0
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: data-pg-restore
  namespace: lab08
spec:
  storageClassName: fast-ssd
  dataSource:                       # новый том из снимка
    apiGroup: snapshot.storage.k8s.io
    kind: VolumeSnapshot
    name: data-pg-0-before-upgrade
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 10Gi
Восстановление — это создание новой заявки с полем dataSource; так же, указав в dataSource существующую PVC, выполняется клонирование тома.
Снимок тома и резервная копия базы данных — не одно и то же 13. Снимок фиксирует блоки диска в некоторый момент, и для работающей СУБД он согласован лишь на уровне аварийного отключения (англ. crash-consistent): после восстановления PostgreSQL выполнит восстановление по журналу предзаписи (WAL), как после внезапного отключения питания. Обычно это работает, но гарантию даёт согласованность на уровне приложения: pg_basebackup и архивирование WAL, позволяющие восстановиться на произвольный момент времени. Кроме того, место хранения снимка зависит от системы: снимки дисков AWS EBS хранятся в отдельной службе, а снимки Ceph RBD — в том же кластере Ceph, и его потеря уносит и том, и снимки. Наконец, ни том, ни снимок не защищают от логической ошибки: DELETE без WHERE успешно реплицируется и сохраняется. Резервная копия — это копия, хранящаяся вне системы, которую она защищает, и проверенная восстановлением; объектное хранилище из темы 10 — типичное место для неё.
Приложения с состоянием: StatefulSet
Идентичность реплик и почему Deployment не подходит
Deployment из темы 7 исходит из того, что реплики взаимозаменяемы: у подов случайные суффиксы имён, при обновлении новые поды создаются раньше, чем удаляются старые, а все реплики используют один и тот же шаблон, в том числе одну и ту же заявку на том. Для базы данных каждое из этих свойств — проблема. Реплики кластера PostgreSQL неравноправны (одна ведущая, остальные — ведомые), им нужны стабильные адреса друг друга и у каждой свой каталог данных.
Даже одиночная база в Deployment требует осторожности. При стратегии RollingUpdate новый под стартует до остановки старого; если оба оказались на одном узле, RWO-том успешно смонтируется в оба, и два процесса PostgreSQL откроют один каталог данных. Поэтому для базы данных в Deployment обязательна стратегия Recreate, а при отказе узла Deployment создаёт замену, не дожидаясь подтверждения, что старый под действительно остановлен. В курсовом проекте PostgreSQL допустимо запускать в Deployment с одной репликой и стратегией Recreate — это простейший вариант, — но различие стоит понимать и обосновывать.
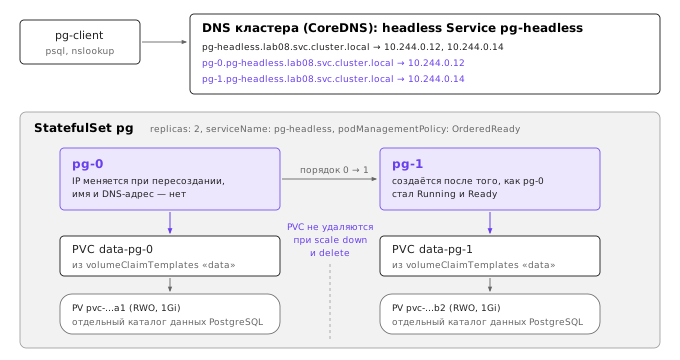
StatefulSet (англ. StatefulSet) — контроллер, который управляет подами из одного шаблона, но закрепляет за каждым устойчивую идентичность: порядковый номер, имя, DNS-имя и собственный том 912. Поды StatefulSet pg с тремя репликами называются pg-0, pg-1, pg-2; при пересоздании pg-1 новый под получит то же имя, тот же DNS-адрес и тот же том, на каком бы узле он ни оказался. Контроллер гарантирует, что под с данной идентичностью существует не более чем в одном экземпляре: замена создаётся только после того, как старый под удалён из API. Поэтому при отказе узла под StatefulSet остаётся в состоянии Terminating или Unknown, пока узел не вернётся или администратор не убедится, что узел выключен, и не удалит под принудительно. Принудительное удаление без такой проверки разрушает именно ту гарантию, ради которой StatefulSet выбран.
Headless Service и стабильные DNS-имена
Обычный Service из темы 7 даёт виртуальный ClusterIP и балансирует соединения между подами. Для реплик базы данных это неприемлемо: запись должна идти на ведущую реплику, а не на случайную. Headless Service (англ. headless service) — Service с clusterIP: None: у него нет виртуального адреса, а DNS-запрос к его имени возвращает A-записи всех готовых подов 9. Для StatefulSet, у которого поле serviceName указывает на такой Service, DNS дополнительно публикует имя каждого пода по шаблону $(имя пода).$(имя Service).$(пространство имён).svc.cluster.local.
apiVersion: v1
kind: Service
metadata:
  name: pg-headless
  namespace: lab08
spec:
  clusterIP: None
  selector:
    app: pg
  ports:
    - name: postgres
      port: 5432
Примерный вывод для StatefulSet из двух реплик (адреса будут другими):
kubectl -n lab08 exec pg-client -- nslookup pg-headless.lab08.svc.cluster.local
kubectl -n lab08 exec pg-client -- nslookup pg-0.pg-headless.lab08.svc.cluster.local
Name:   pg-headless.lab08.svc.cluster.local
Address: 10.244.0.12
Name:   pg-headless.lab08.svc.cluster.local
Address: 10.244.0.14

Name:   pg-0.pg-headless.lab08.svc.cluster.local
Address: 10.244.0.12
IP-адрес пода после пересоздания изменится, а имя pg-0.pg-headless — нет; на это и рассчитана настройка репликации, где ведомый указывает адрес ведущего. Схема на рисунке ниже сводит вместе имена подов, DNS-записи и персональные заявки на тома.
Две оговорки. В DNS попадают только готовые поды, если у Service не задано publishNotReadyAddresses: true, — это важно для баз данных, которым нужно найти друг друга до прохождения проб. И DNS кэширует отрицательные ответы: если имя запрошено до создания пода, клиент может ещё некоторое время получать «не найдено»; документация упоминает кэш CoreDNS в 30 секунд 9.
volumeClaimTemplates, порядок запуска и обновления
Поле volumeClaimTemplates — шаблон заявки, по которому контроллер создаёт отдельную PVC для каждого пода с именем <имя шаблона>-<имя пода>: data-pg-0, data-pg-1. Под pg-1 всегда подключает data-pg-1, поэтому после пересоздания на другом узле он получает свои данные, а не данные соседа.
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: pg
  namespace: lab08
spec:
  serviceName: pg-headless
  replicas: 2
  podManagementPolicy: OrderedReady
  selector:
    matchLabels:
      app: pg
  template:
    metadata:
      labels:
        app: pg
    spec:
      containers:
        - name: postgres
          image: postgres:17.11-alpine
          args:
            - "-c"
            - "config_file=/etc/postgresql/postgresql.conf"
          volumeMounts:
            - name: data
              mountPath: /var/lib/postgresql/data
  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
            storage: 1Gi
Заявки, созданные по шаблону, не удаляются ни при уменьшении числа реплик, ни при удалении самого StatefulSet 9. Это сделано намеренно: данные ценнее автоматической уборки. Если уменьшить StatefulSet с трёх реплик до одной, data-pg-1 и data-pg-2 останутся связанными со своими томами, а при обратном увеличении pg-1 и pg-2 получат прежние данные. Поведение настраивается полем persistentVolumeClaimRetentionPolicy (стабильно с Kubernetes 1.32) с политиками whenDeleted и whenScaled, каждая из которых равна Retain (по умолчанию) или Delete 9. Обратная сторона — забытые тома: три реплики по 50 ГиБ, уменьшенные до одной, оставляют 100 ГиБ занятого и оплачиваемого хранилища, которое не видно в списке подов.
Поле podManagementPolicy задаёт порядок создания и удаления. По умолчанию действует OrderedReady: поды создаются по порядку от 0 до N−1, и следующий создаётся только после того, как предыдущий стал Running и Ready; удаляются в обратном порядке 9. Это удобно для систем, где первый экземпляр инициализирует кластер, а остальные присоединяются к нему. Политика Parallel создаёт и удаляет все поды одновременно. Цена порядка — время: если PostgreSQL с инициализацией каталога данных становится готовым за 40 с, то StatefulSet из трёх реплик в режиме OrderedReady поднимается примерно за 3 × 40 = 120 с, а в режиме Parallel — примерно за 40 с. Политика касается только масштабирования; обновления подчиняются отдельному полю updateStrategy.
Стратегия обновления RollingUpdate (по умолчанию) пересоздаёт поды по одному в обратном порядке номеров — от N−1 до 0, дожидаясь готовности каждого. Параметр partition ограничивает обновление подами с номером не меньше заданного: при partition: 2 новый шаблон получит только pg-2, что позволяет проверить новую версию на одной реплике (канареечное обновление). Стратегия OnDelete не обновляет поды сама — новый шаблон применяется, когда под удалён вручную, — что используют операторы, управляющие порядком обновления реплик сами.
Наконец, у StatefulSet есть неизменяемые поля: после создания нельзя поменять volumeClaimTemplates, serviceName и selector. Чтобы увеличить том, изменяют каждую PVC отдельно (при allowVolumeExpansion: true в классе), а шаблон остаётся старым; чтобы поменять класс хранения, StatefulSet пересоздают, сохраняя PVC (kubectl delete statefulset pg --cascade=orphan удаляет контроллер, не трогая поды).
Операторы баз данных
StatefulSet даёт идентичность и тома, но ничего не знает о PostgreSQL. Две реплики StatefulSet — это два независимых сервера с двумя независимыми каталогами данных; потоковую репликацию между ними, выбор ведущего, переключение при отказе, резервное копирование и обновление основной версии кто-то должен выполнять. Это работа администратора баз данных, и оператор (англ. operator) автоматизирует её по образцу цикла согласования из темы 7: пользовательский ресурс описывает желаемое состояние кластера баз данных, а контроллер-оператор приводит к нему реальное.
CloudNativePG — оператор PostgreSQL, проект CNCF. Кластер описывается ресурсом Cluster:
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: notes-db
spec:
  instances: 3
  storage:
    storageClass: fast-ssd
    size: 20Gi
По этому описанию оператор создаёт ведущий экземпляр и две реплики с потоковой репликацией, Service для записи (notes-db-rw, всегда указывает на ведущий) и для чтения (notes-db-ro), при отказе ведущего повышает одну из реплик и переключает Service, а резервное копирование выполняет в объектное хранилище. Показательно, что CloudNativePG не использует StatefulSet: он управляет подами и PVC напрямую собственным контроллером 11. Документация проекта объясняет это ограничениями StatefulSet, в частности невозможностью изменить размер томов через шаблон и жёстким порядком обновления, в котором неизвестно, какая реплика ведущая. Это хороший пример того, что StatefulSet — универсальный строительный блок, а не готовое решение для конкретной СУБД. Другие операторы PostgreSQL — Zalando Postgres Operator (на основе Patroni), Crunchy PGO, StackGres.
Ограничения и типичные ошибки интерпретации
Ошибки в работе с конфигурацией и секретами
«Изменил ConfigMap — приложение перенастроилось». Это верно только для тома без subPath и только если приложение перечитывает файл. Переменные окружения и subPath не обновляются никогда, а том обновляется с задержкой порядка минуты. Надёжный способ применить конфигурацию — изменить шаблон пода (хэш конфигурации в аннотации) и получить контролируемое поэтапное обновление.
«Смонтировал файл — конфигурация применилась». Файл, о котором приложение не знает, ничего не меняет; PostgreSQL читает postgresql.conf из каталога данных, пока ему не указан -c config_file=.... Обратная ошибка — полная замена конфигурации: файл, переданный через config_file, заменяет весь postgresql.conf, и если в нём нет listen_addresses = '*', сервер будет слушать только localhost, а проба pg_isready изнутри пода при этом продолжит проходить.
«Secret зашифрован». В etcd по умолчанию — нет; в манифесте — тем более нет, base64 обращается без ключа. Secret отличается от ConfigMap доставкой на узел (tmpfs, только нужным узлам) и тем, что на него обычно навешивают более строгие правила RBAC. Без EncryptionConfiguration резервная копия etcd — это открытый файл со всеми паролями кластера. Манифест Secret с data в публичном репозитории — утечка, даже если «там только base64».
«Права на секреты закрыты RBAC». Чтение через API закрыто, но право создавать поды в пространстве имён позволяет прочитать любой его Secret через монтирование. Граница доверия для секретов — пространство имён.
Ошибки в работе с томами
«Удалю PVC, а данные останутся на PV». При политике Delete, которая по умолчанию стоит у динамически созданных томов, удаление заявки удаляет и том с данными. Политику проверяют командой kubectl get pv до, а не после удаления; для ценных данных ставят Retain в классе хранения или заранее меняют её на конкретном PV.
«RWO значит один под». RWO ограничивает узел; два пода на одном узле, например старый и новый при RollingUpdate, оба получат том на запись. Нужна стратегия Recreate, StatefulSet или режим ReadWriteOncePod.
«Том реплицирован, значит есть резервная копия». Репликация в системе хранения защищает от отказа диска, снимок — от неудачного обновления в пределах той же системы, и ни то ни другое не защищает от DROP TABLE, ошибки приложения и потери всей системы хранения. Резервная копия хранится отдельно и проверяется восстановлением.
«PVC в Pending — значит, кончилось место». Причин несколько: нет класса с указанным именем, нет класса по умолчанию, драйвер не установлен или не может создать том, а при WaitForFirstConsumer заявка законно ждёт первого пода. Разбор начинается с kubectl describe pvc, где в событиях указана причина.
«Обновлю образ базы — данные на томе подхватятся». Внутри одной основной версии PostgreSQL это так, между основными — нет: формат файлов данных несовместим, и переход требует pg_upgrade или выгрузки и загрузки. Кроме того, официальный образ PostgreSQL 18 перенёс каталог данных по умолчанию из /var/lib/postgresql/data в /var/lib/postgresql/18/docker, и манифест, монтирующий том по старому пути без явного PGDATA, с новым образом не запустится. Поэтому тег образа базы данных в манифесте фиксируется как минимум до основной версии (postgres:17.11-alpine, а не postgres:alpine).
Отдельная оговорка касается учебной среды. В minikube из одного узла провайдер k8s.io/minikube-hostpath создаёт тома как каталоги /tmp/hostpath-provisioner/<пространство имён>/<имя PVC> внутри узла. Такие тома не ограничивают размер (запрошенные 1 ГиБ — лишь число в объекте), не имеют шагов attach и stage и не могут переехать на другой узел. На одном узле нельзя наблюдать ни ошибку Multi-Attach, ни топологию зон, ни перенос пода с томом между узлами: механизмы те же, но их физическая сторона в учебном стенде вырождена.
Когда базе данных не место в Kubernetes
Kubernetes дал базам данных всё необходимое: устойчивые имена, персональные тома, порядок запуска, операторы. Из этого не следует, что любую базу нужно держать в кластере. Против говорят три обстоятельства. Отказ узла для StatefulSet не обрабатывается автоматически, и без оператора восстановление требует ручной работы администратора, знающего и Kubernetes, и СУБД. Производительность базы определяется системой хранения, и сетевой блочный том с задержкой в доли миллисекунды на операцию ведёт себя иначе, чем локальный NVMe-диск. Наконец, управляемая облачная СУБД снимает с команды резервное копирование, обновления и переключение при отказе, а её цена часто ниже стоимости компетенции, нужной для безопасной эксплуатации собственного кластера.
Разумная практика выглядит так: учебные и тестовые базы, а также базы, для которых есть зрелый оператор и команда, умеющая с ним работать, — в Kubernetes через оператор вроде CloudNativePG; критичные базы рабочей среды без такого опыта — в управляемом сервисе; одиночный StatefulSet без оператора — только там, где потеря данных за период между резервными копиями приемлема.
Итоги темы
Конфигурация отделяется от образа объектами ConfigMap и Secret, и главное, что нужно о них помнить, — семантика обновления. Переменные окружения и subPath фиксируются при создании контейнера, том обновляется kubelet атомарной перестановкой ссылки ..data с задержкой порядка минуты, а применение новой конфигурации зависит ещё и от того, перечитывает ли её приложение и не требует ли параметр перезапуска. Предсказуемое обновление получают изменением шаблона пода, то есть тем же механизмом поэтапного обновления, что и для новой версии образа.
Secret — это не хранилище секретов, а объект с более аккуратной доставкой на узел. Base64 не шифрует, в etcd данные по умолчанию лежат открытыми, а читать секреты может любой, кто может создавать поды в пространстве имён. Шифрование включается EncryptionConfiguration на API-сервере, лучше с провайдером KMS v2; хранение секретов в Git и их ротацию решают Sealed Secrets, SOPS, External Secrets Operator и Vault.
Постоянное хранилище построено на разделении заявки и тома. PVC описывает потребность приложения, PV — конкретный том, StorageClass — профиль, по которому том создаётся динамически. Судьбу данных при удалении заявки определяет политика освобождения, момент создания тома — volumeBindingMode, и в многозонном кластере WaitForFirstConsumer исключает тома, недоступные из зоны пода. Драйвер подключается по стандарту CSI, и путь тома всегда один и тот же: CreateVolume, ControllerPublishVolume, NodeStageVolume, NodePublishVolume, причём первые два выполняют сайдкары контроллерной части, а последние два — kubelet.
StatefulSet даёт каждой реплике устойчивое имя, DNS-адрес через headless Service и персональную PVC, которая не удаляется вместе с подом, а по умолчанию — и вместе с самим StatefulSet. Но он не знает ничего о репликации и резервном копировании конкретной СУБД; эту работу выполняют операторы, такие как CloudNativePG, а снимки томов и резервные копии остаются разными инструментами.
Тема 9 переходит от объектов внутри кластера к описанию самой инфраструктуры кодом: кластеры, сети и диски создаются OpenTofu по тому же декларативному принципу. Тема 10 рассматривает объектное хранилище, куда уходят резервные копии баз данных и вложения «Заметок», а тема 11 — RBAC и политики, которые закрывают доступ к секретам, упомянутый здесь лишь в общих чертах.
Литература
- Wiggins A. The Twelve-Factor App. — 2011. https://12factor.net/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. ConfigMaps. — https://kubernetes.io/docs/concepts/configuration/configmap/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Secrets. — https://kubernetes.io/docs/concepts/configuration/secret/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Encrypting Confidential Data at Rest. — https://kubernetes.io/docs/tasks/administer-cluster/encrypt-data/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Persistent Volumes. — https://kubernetes.io/docs/concepts/storage/persistent-volumes/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Storage Classes. — https://kubernetes.io/docs/concepts/storage/storage-classes/ (дата обращения: 22.10.2026).
- Container Storage Interface (CSI) Specification. Version 1.13.0. — https://github.com/container-storage-interface/spec/blob/master/spec.md (дата обращения: 22.10.2026).
- Kubernetes CSI Developer Documentation. — https://kubernetes-csi.github.io/docs/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. StatefulSets. — https://kubernetes.io/docs/concepts/workloads/controllers/statefulset/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Volume Snapshots. — https://kubernetes.io/docs/concepts/storage/volume-snapshots/ (дата обращения: 22.10.2026).
- CloudNativePG Documentation. Custom Pod Controller. — https://cloudnative-pg.io/docs/current/controller (дата обращения: 22.10.2026).
- Luksa M. Kubernetes in Action. — Manning, 2018.
- Burns B., Beda J., Hightower K., Evenson L. Kubernetes: Up and Running. 3rd ed. — O'Reilly Media, 2022.
- PostgreSQL 17 Documentation. 19.1. Setting Parameters. — https://www.postgresql.org/docs/17/config-setting.html (дата обращения: 22.10.2026).