
Облачные хранилища данных: блочные, файловые и объектные
К этой теме приложение «Заметки» уже умеет хранить данные. В теме 5 база PostgreSQL получила Docker-том, переживающий пересоздание контейнера; в теме 8 тот же PostgreSQL переехал в StatefulSet с постоянным томом, который Kubernetes запрашивает у хранилища через PersistentVolumeClaim и драйвер CSI. Там же появились режимы доступа ReadWriteOnce и ReadWriteMany, но вопрос, почему один том можно смонтировать на многих узлах, а другой — только на одном, остался без ответа: Kubernetes лишь передаёт пожелание драйверу, а возможности определяются устройством хранилища за ним.
Открытыми остаются и практические вопросы. Куда положить вложения заметок — фотографии и документы, которые пользователи загружают через браузер, — чтобы их не терять при отказе узла и не раздувать базу? Где хранить ночные резервные копии базы так, чтобы их не смог удалить злоумышленник, получивший доступ к кластеру? Где OpenTofu из темы 9 держит файл состояния и как организована его блокировка? Куда Loki из темы 12 складывает сжатые журналы? Ответ во всех четырёх случаях один — в объектное хранилище с интерфейсом S3. Этот интерфейс не похож ни на диск, ни на файловую систему, и чтобы пользоваться им правильно, нужно понимать его модель.
Изложение построено так. Первый раздел сравнивает три модели доступа к данным — блочную, файловую и объектную — и показывает, где в каждой находится файловая система и что из этого следует для совместного доступа. Второй раздел объясняет, как хранилище переживает отказы дисков: репликацией или кодами стирания, — с расчётом накладных расходов. Третий раздел разбирает S3 как протокол поверх HTTP: модель данных, сырой запрос, подпись SigV4 и presigned URL. Четвёртый посвящён жизни объекта: версиям и маркерам удаления, правилам жизненного цикла, составной загрузке и согласованности. Пятый — доступу и защите: политикам бакета, блокировке публичного доступа, шифрованию и Object Lock. Шестой собирает вопросы эксплуатации: классы хранения и стоимость, использование S3 из Kubernetes, ограничения и типичные ошибки. Учебный сервер S3 в лабораторной работе — RustFS 1.0.3; выводы команд версионирования, политик, presigned URL и составной загрузки в тексте получены на нём с клиентом AWS CLI v2.
Три модели доступа к данным
Блочное устройство: диск без смысла
Блочное устройство (англ. block device) — хранилище, которое предоставляет клиенту пронумерованный массив блоков фиксированного размера и две операции: прочитать блок с номером N и записать блок с номером N. Номер называется логическим адресом блока (англ. logical block address, LBA), размер блока исторически 512 байт, у современных дисков — 4 КиБ. Устройство ничего не знает о файлах, каталогах и правах: для него запись в блок 8 391 000 ничем не отличается от записи в блок 0. Смысл байтам придаёт файловая система — ext4, XFS, NTFS, — которая работает в ядре клиентской операционной системы и сама решает, в каких блоках лежат индексные дескрипторы, журнал и данные файлов.
Сетевое блочное хранилище сохраняет этот интерфейс, но переносит блоки на удалённые серверы. Виртуальная машина видит обычный диск /dev/vdb через паравиртуальный драйвер virtio-blk (тема 2), а гипервизор пересылает операции по сети в систему хранения. Другие способы доставки блочного протокола — iSCSI (команды SCSI поверх TCP), NVMe over Fabrics и собственные протоколы распределённых систем, например RBD (англ. RADOS Block Device) в Ceph. В Ceph блочный том разрезан на объекты по 4 МиБ, которые распределяются по серверам кластера алгоритмом CRUSH и реплицируются 2; клиенту же по-прежнему показан непрерывный диск. Облачные диски — Amazon EBS, диски Yandex Compute Cloud, тома OpenStack Cinder — устроены по той же схеме.
Главное следствие блочной модели касается совместного доступа. Файловая система кеширует метаданные и данные в памяти своего ядра, ведёт журнал и предполагает, что больше никто не меняет блоки под ней. Если один и тот же том смонтировать с ext4 на двух машинах на запись, каждая будет перезаписывать блоки, не зная о кеше и журнале другой, и файловая система разрушится — без какой-либо ошибки со стороны хранилища, которое честно выполняет все записи. Поэтому облачный диск подключается к одной виртуальной машине, а в Kubernetes такой том имеет режим ReadWriteOnce (тема 8). Существуют кластерные файловые системы (GFS2, OCFS2), которые координируют доступ нескольких узлов к одному блочному устройству через распределённый менеджер блокировок, но это отдельный класс программ, а не свойство блочного хранилища.
Достоинство блочной модели — минимум посредников. Операция fsync в PostgreSQL превращается в запись нескольких блоков и команду сброса кеша устройства; транзакционная база рассчитывает именно на такой путь: частичная перезапись страницы в 8 КиБ посреди файла данных, точный порядок записей журнала, предсказуемая задержка. Поэтому база «Заметок» живёт на блочном томе.
Файловое хранилище: общая файловая система по сети
Файловое хранилище (англ. file storage) переносит файловую систему на сервер. Клиент монтирует удалённый каталог и выполняет обычные системные вызовы — open, read, write, rename, flock, — а клиент сетевой файловой системы в ядре превращает их в запросы протокола: NFS (англ. Network File System) в мире Unix, SMB в мире Windows. Сервер хранит каталоги, имена, права и блокировки и потому может обслуживать много клиентов одновременно: это и есть режим ReadWriteMany. Распределённые файловые системы — CephFS, Amazon EFS — выносят метаданные на отдельные серверы метаданных, а данные раскладывают по узлам хранения, но для клиента остаются той же файловой системой 2.
Ценность файловой модели — семантика POSIX (англ. Portable Operating System Interface): иерархия каталогов, частичная перезапись файла по смещению, дозапись в конец, атомарное переименование и консультативные блокировки. Атомарный rename — основа множества приёмов: программа пишет новую версию конфигурации во временный файл и переименовывает его поверх старого, и любой читатель видит либо старый файл целиком, либо новый. Блокировки позволяют двум процессам на разных узлах не писать в один файл одновременно. NFS версии 4 встраивает блокировки в протокол и связывает их с арендой (англ. lease): сервер считает блокировку живой, пока клиент периодически продлевает аренду, и освобождает её, если клиент пропал 4.
Полную семантику локальной файловой системы сетевая всё же не даёт. Клиенты NFS кешируют данные, и стандарт гарантирует согласованность «закрыть — открыть» (англ. close-to-open): изменения, сделанные одним клиентом, гарантированно видны другому, если первый закрыл файл, а второй открыл его после этого 4. Два процесса на разных узлах, одновременно держащие файл открытым, могут видеть разное содержимое. Каждая операция с метаданными — проверка существования файла, чтение атрибутов, создание — превращается в сетевой запрос, поэтому приложения, создающие миллионы мелких файлов, на сетевой файловой системе работают на порядки медленнее, чем на локальной.
Когда режим RWX действительно нужен? Когда несколько экземпляров приложения обязаны работать с одним деревом файлов именно как с файлами: унаследованная CMS, которая пишет загрузки пользователей в каталог uploads/; конвейер обработки, в котором стороннее ПО читает и пишет файлы по путям; общая домашняя директория пользователей вычислительного кластера. Если же приложение пишется заново и файловая семантика ему не нужна — как backend «Заметок», которому достаточно «сохранить вложение» и «отдать вложение», — общая файловая система добавляет единую точку отказа и масштабируется хуже объектного хранилища.
Объектное хранилище: ключ, байты, метаданные, HTTP
Объектное хранилище (англ. object storage) отказывается и от блоков, и от файловой системы. Единица хранения — объект (англ. object): последовательность байтов произвольного размера вместе с метаданными, адресуемая строковым ключом (англ. key) внутри бакета (англ. bucket) — именованного контейнера объектов. Операции выполняются над объектом целиком и передаются по HTTP: PUT записывает объект, GET читает его (возможно, диапазон байтов), HEAD возвращает метаданные, DELETE удаляет. Изменить десять байтов в середине объекта нельзя: можно только записать объект заново. Нет и каталогов: ключ att/2026/10/42.jpg — одна строка, а косые черты в ней ничего не создают.
Строение объекта показано на рисунке ниже. Кроме байтов данных у объекта есть системные метаданные (Content-Type, Content-Length, Last-Modified, ETag — идентификатор содержимого), пользовательские метаданные в заголовках x-amz-meta-* и, если в бакете включено версионирование, идентификатор версии.
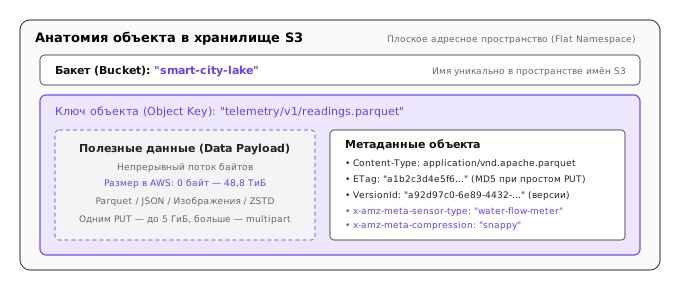
Отказ от файловой семантики — не недостаток, а цена масштабирования. Объект неизменяем после записи, поэтому его можно разрезать на части и разложить по сотням серверов, не заботясь о том, что кто-то перепишет середину. Нет иерархии каталогов — нет и узкого места в виде сервера метаданных, который должен атомарно переименовывать поддеревья. Нет открытых файлов и блокировок — сервер не хранит состояние клиента между запросами, и любой запрос можно направить на любой экземпляр шлюза. Протокол HTTP проходит через балансировщики, прокси и сети доставки контента и понятен браузеру: картинку из бакета можно показать на странице прямой ссылкой. Де-факто стандартом интерфейса стал API Amazon S3 (англ. Simple Storage Service), который реализуют и публичные облака, и открытые серверы 5.
Сравнение моделей и выбор для «Заметок»
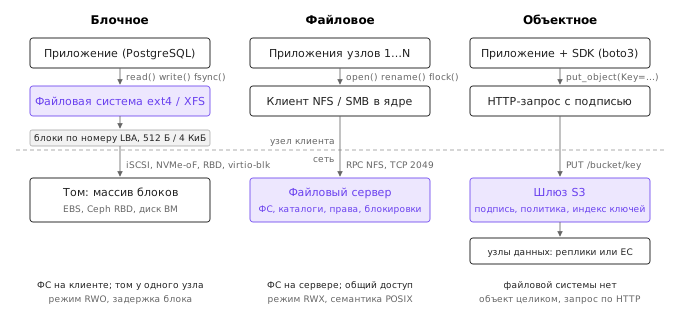
Рисунок ниже показывает путь запроса в трёх моделях. Главное различие — где находится файловая система. В блочной модели она на клиенте, и потому том принадлежит одному узлу. В файловой — на сервере, и узлов может быть много, но каждый вызов становится сетевым запросом с семантикой, близкой к POSIX. В объектной файловой системы нет вовсе: приложение через библиотеку (SDK) формирует HTTP-запросы, а шлюз хранилища проверяет подпись и права, находит объект по ключу и обращается к узлам данных.
| Свойство | Блочное | Файловое | Объектное |
|---|---|---|---|
| Единица данных | блок 512 Б или 4 КиБ | файл в дереве каталогов | объект целиком |
| Интерфейс | драйвер блочного устройства | системные вызовы POSIX через NFS, SMB | HTTP API S3 через SDK |
| Изменение части данных | да, любой блок | да, по смещению | нет, только запись объекта заново |
| Одновременный доступ узлов | один узел на запись (RWO) | много узлов (RWX) | неограниченно, каждый запрос независим |
| Атомарное переименование | средствами ФС клиента | да | нет: копирование и удаление |
| Задержка операции | минимальная из трёх | выше блочной: сетевой круг на вызов | HTTP-запрос с подписью и поиском ключа; измеряется в ЛР 10 |
| Типичное применение | СУБД, диски ВМ | общие каталоги, унаследованные приложения | вложения, резервные копии, журналы, артефакты, состояние IaC |
| Примеры | EBS, Ceph RBD, iSCSI | NFS, SMB, CephFS, EFS | Amazon S3, Ceph RGW, RustFS, SeaweedFS |
Таблица намеренно не содержит абсолютных чисел задержки: они зависят от реализации, сети, размера объекта и нагрузки, и любые «типичные» значения без условий измерения вводят в заблуждение. В лабораторной работе латентность PUT и GET мелких объектов на учебном сервере измеряется и сравнивается с записью и чтением локальных файлов; порядок разницы — несколько сотен раз для чтения из кеша страниц — виден сразу.
Для «Заметок» выбор получается естественным. PostgreSQL остаётся на блочном томе ReadWriteOnce: ему нужны частичная перезапись и fsync. Вложения уходят в объектное хранилище: бакет notes-att, ключ вида att/<id заметки>/<имя файла>, ссылка на ключ — в строке таблицы заметок. Резервные копии базы, получаемые pg_dump, складываются в тот же или отдельный бакет с префиксом backups/. Общая файловая система не нужна вовсе.
Как хранилище переживает отказы дисков
Репликация
Любое хранилище, рассчитанное на годы работы, должно пережить отказ дисков и серверов: при тысячах дисков в кластере отказ какого-то из них — ежедневное событие. Простейший способ — репликация (англ. replication): каждый блок или объект хранится в r полных копиях на разных дисках, а лучше — на разных серверах и стойках. Запись подтверждается, когда её сохранили все копии или их кворум; чтение может обслужить любая копия; после отказа диска система копирует недостающие реплики с уцелевших на новые места 12.
Ceph по умолчанию использует три копии, как и большинство распределённых систем. Тройная репликация переживает потерю любых двух копий, но обходится дорого: на каждый терабайт полезных данных расходуется три терабайта дисков, накладные расходы — 200 %. Для базы данных, где важны задержка записи и скорость восстановления, эта цена оправдана. Для петабайтов вложений и резервных копий — нет: здесь решающим становится коэффициент расхода дискового пространства.
Коды стирания
Код стирания (англ. erasure code) делит объект на k фрагментов данных и вычисляет по ним m фрагментов чётности так, что объект восстанавливается по любым k из k+m фрагментов. Классический пример — коды Рида — Соломона, построенные на арифметике конечных полей 3; простейший частный случай с m = 1 — чётность XOR в RAID 5. Фрагменты раскладываются по k+m разным дискам, а лучше по разным серверам, и система переживает потерю любых m из них. Схему обозначают «k+m»: 4+2, 8+3, 10+4.
Коэффициент расхода пространства (сколько байтов на дисках приходится на байт данных) и доля избыточности равны
\text{коэффициент} = \frac{k+m}{k}, \qquad \text{избыточность} = \frac{m}{k}.
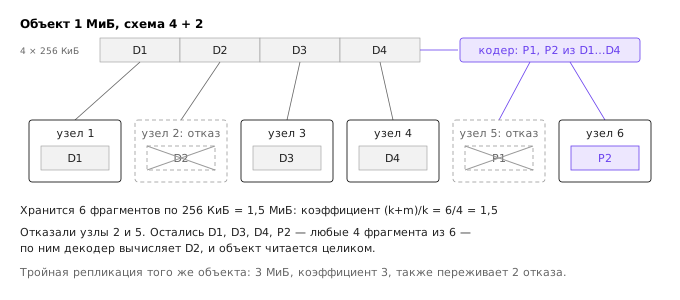
Рассмотрим объект размером 1 МиБ в схеме 4+2. Он режется на четыре фрагмента данных D1–D4 по 256 КиБ; кодер вычисляет два фрагмента чётности P1 и P2 по 256 КиБ; шесть фрагментов записываются на шесть узлов. На дисках занято 6 \cdot 256 КиБ = 1{,}5 МиБ, коэффициент \frac{4+2}{4} = 1{,}5, избыточность 50 %. Если отказали узлы с D2 и P1, оставшиеся D1, D3, D4 и P2 — четыре фрагмента — достаточны, чтобы декодер вычислил D2 и отдал объект целиком. Рисунок ниже показывает именно эту ситуацию. Тройная репликация того же объекта заняла бы 3 МиБ и пережила бы те же два отказа: при равной устойчивости коды стирания расходуют вдвое меньше дисков.
| Схема | Коэффициент (k+m)/k | Избыточность | Переживает отказов | Узлов не меньше |
|---|---|---|---|---|
| репликация ×3 | 3 | 200 % | 2 | 3 |
| 2+2 | 2 | 100 % | 2 | 4 |
| 4+2 | 1,5 | 50 % | 2 | 6 |
| 8+3 | 1,375 | 37,5 % | 3 | 11 |
| 10+4 | 1,4 | 40 % | 4 | 14 |
| 12+4 | 1,33 | 33 % | 4 | 16 |
Из таблицы видно, что число переживаемых отказов определяется только m, а не долей дисков. Утверждение «коды стирания переживают потерю половины дисков» верно лишь для схем с m = k (2+2, 4+4); схема 12+4 теряет данные при отказе пяти узлов из шестнадцати, то есть менее трети. Рост k при фиксированном m снижает коэффициент, но увеличивает число узлов, которые должны участвовать в каждой операции.
Цена кодов стирания: восстановление, мелкие объекты, домены отказа
Экономия дискового пространства оплачивается тремя способами. Первый — стоимость восстановления. При репликации потерянная копия восстанавливается чтением одной уцелевшей копии того же размера. При коде Рида — Соломона, чтобы заново вычислить один потерянный фрагмент, нужно прочитать k фрагментов: в схеме 4+2 восстановление 256 КиБ требует чтения 1 МиБ по сети, в схеме 10+4 — в десять раз больше данных, чем восстанавливается. После отказа сервера с десятками терабайт такой трафик заметно нагружает сеть кластера; ради его снижения разработаны локально восстанавливаемые коды, в которых часть чётности вычисляется по небольшим группам фрагментов.
Второй — мелкие объекты и задержка. Объект в 4 КиБ в схеме 4+2 превращается в шесть фрагментов по килобайту на шести дисках: шесть операций ввода-вывода и шесть наборов метаданных вместо одной записи. Чтение требует ответа k узлов, и задержку определяет самый медленный из них. Поэтому реализации хранят мелкие объекты иначе: встраивают данные прямо в файл метаданных объекта или реплицируют их. В RustFS, например, каждый объект на диске — каталог с файлом xl.meta, и у небольших объектов, судя по составу каталога, отдельных файлов данных нет. Для блочных томов с их мелкими случайными записями коды стирания тоже менее удобны, чем для объектов, записываемых целиком; Ceph поддерживает оба типа пулов и позволяет выбирать по назначению 2.
Третий — домены отказа (англ. failure domains). Схема 4+2 переживает два отказа, только если шесть фрагментов лежат в шести независимых местах. Если два фрагмента оказались на двух дисках одного сервера, отказ блока питания этого сервера стоит сразу двух «отказов» из бюджета. Поэтому распределённые системы раскладывают фрагменты по иерархии «диск — сервер — стойка — зона доступности»: правила CRUSH в Ceph описывают эту иерархию явно 2. Amazon заявляет для S3 Standard проектную долговечность 99,999999999 % и хранение данных минимум в трёх зонах доступности региона 5; это свойство организации хранения, а не одной схемы кодирования. Учебный сервер в лабораторной работе работает на одном каталоге одного диска и не переживает ни одного отказа: он воспроизводит интерфейс S3, а не его надёжность. При запуске RustFS на нескольких дисках (например, четырёх томах) он объединяет их в набор стирания (англ. erasure set) и раскладывает фрагменты объектов по ним.
S3: модель данных и протокол
Бакеты, ключи и префиксы
Пространство имён S3 двухуровневое. Бакет имеет имя длиной от 3 до 63 символов из строчных латинских букв, цифр, точек и дефисов; в AWS имя уникально во всём разделе облака, поэтому notes-att почти наверняка уже кем-то занят и в реальных системах в имя добавляют суффикс организации или аккаунта 5. Ключ объекта — произвольная строка UTF-8 длиной до 1024 байтов. Пользовательские метаданные ограничены 2 КБ на объект и задаются при записи; изменить их без перезаписи объекта нельзя — даже метаданные копируются операцией CopyObject в новый объект.
Иерархия «папок», которую показывают веб-консоли, — иллюзия, построенная операцией листинга. ListObjectsV2 с параметром prefix=att/ возвращает ключи, начинающиеся с этой строки, а с параметром delimiter=/ сворачивает всё, что после следующей косой черты, в «общие префиксы» (англ. common prefixes). Вывод ниже показан схематично и сокращён:
aws s3api list-objects-v2 --bucket notes-att --prefix att/ --delimiter /
{
    "Contents": [
        { "Key": "att/readme.txt", "Size": 120, ... }
    ],
    "CommonPrefixes": [
        { "Prefix": "att/41/" },
        { "Prefix": "att/42/" }
    ],
    "KeyCount": 3,
    ...
}
Префиксов att/41/ и att/42/ как сущностей нет: они вычислены из ключей att/41/a.png, att/42/b.pdf и исчезнут, когда будут удалены последние такие объекты. «Переименовать папку» в S3 означает скопировать каждый объект под новым ключом и удалить старый — операция не атомарна и стоит два запроса на каждый объект. Листинг возвращает не более 1000 ключей за запрос, остальное — через маркер продолжения, поэтому подсчёт объектов в бакете с миллионами ключей — тысячи запросов.
Ключ входит и в масштабирование. AWS документирует производительность в расчёте на префикс: не менее 3500 запросов PUT/COPY/POST/DELETE и 5500 запросов GET/HEAD в секунду на каждый префикс, причём число префиксов не ограничено 5. Нагрузку, которая упирается в этот предел, распределяют по нескольким префиксам.
Бакет адресуется двумя способами. В адресации path-style (англ. path-style) имя бакета — первая часть пути: http://127.0.0.1:9000/notes-att/att/42/b.pdf. В адресации virtual-hosted-style (англ. virtual-hosted-style) имя бакета — часть имени хоста: https://notes-att.s3.us-east-1.amazonaws.com/att/42/b.pdf. AWS считает основной вторую и объявила о планах прекратить поддержку path-style 5; S3-совместимые серверы, наоборот, по умолчанию понимают path-style, а для virtual-hosted-style им нужно знать собственное доменное имя и иметь DNS-записи вида *.s3.example.com. Расхождение стилей адресации — частая причина ошибки NoSuchBucket при подключении SDK к собственному серверу; ему посвящена одна из частей лабораторной работы.
Сырой HTTP-запрос и подпись SigV4
Каждая операция S3 — один HTTP-запрос. Запись объекта att/n.txt с телом из трёх байтов v2\n в бакет notes-att выглядит так (заголовки сокращены до значимых):
PUT /notes-att/att/n.txt HTTP/1.1
Host: 127.0.0.1:9000
Content-Length: 3
X-Amz-Date: 20261021T210642Z
X-Amz-Content-SHA256: 81db67b6a5702b9b68f0016f061c409bf3fb16d062fc854d1b424bb4e9c28c56
Authorization: AWS4-HMAC-SHA256 Credential=lab10admin/20261021/us-east-1/s3/aws4_request, SignedHeaders=host;x-amz-content-sha256;x-amz-date, Signature=e5a5fc49733bde62070262cb4f529f285058fb94b6163e8c07511d77f88515e5

v2
HTTP/1.1 200 OK
ETag: "e30260020baeb0398ff07b37dd33ed16"
x-amz-version-id: a92d97c0-6e89-4432-bf08-86e977285e33
x-amz-request-id: ...
Content-Length: 0
ETag здесь — MD5 трёх байтов тела в шестнадцатеричной записи; для объектов, записанных одним PUT без шифрования ключом KMS, это верно и в AWS, но в общем случае ETag — непрозрачный идентификатор содержимого, а не контрольная сумма (для составной загрузки он вычисляется иначе, см. ниже). Заголовок x-amz-version-id появляется, когда в бакете включено версионирование.
Самое интересное в запросе — заголовок Authorization. Секретный ключ по сети не передаётся. Клиент и сервер оба знают пару «идентификатор ключа доступа — секретный ключ» (здесь lab10admin и секрет учебного стенда), клиент вычисляет по запросу подпись HMAC-SHA256, а сервер, получив запрос, повторяет вычисление своей копией секрета и сравнивает результаты. Алгоритм называется Signature Version 4, SigV4 7. Он состоит из четырёх шагов.
Шаг 1 — канонический запрос (англ. canonical request): запрос приводится к однозначной текстовой форме, чтобы клиент и сервер хешировали одну и ту же строку. Это шесть строк: метод, путь в URL-кодировке, отсортированные параметры запроса (здесь их нет — пустая строка), канонические заголовки (имена в нижнем регистре, отсортированы, каждый с переводом строки), список подписанных заголовков и SHA-256 тела:
PUT
/notes-att/att/n.txt

host:127.0.0.1:9000
x-amz-content-sha256:81db67b6a5702b9b68f0016f061c409bf3fb16d062fc854d1b424bb4e9c28c56
x-amz-date:20261021T210642Z

host;x-amz-content-sha256;x-amz-date
81db67b6a5702b9b68f0016f061c409bf3fb16d062fc854d1b424bb4e9c28c56
Шаг 2 — строка для подписи (англ. string to sign): название алгоритма, время запроса, область действия (англ. credential scope) «дата/регион/сервис/aws4_request» и SHA-256 канонического запроса:
AWS4-HMAC-SHA256
20261021T210642Z
20261021/us-east-1/s3/aws4_request
58f5245dc5122a9ef42619c160526b863fa5d57e5e2638413153679ae9dea20a
Шаг 3 — ключ подписи (англ. signing key) выводится из секрета цепочкой HMAC, каждое звено которой сужает область действия:
kDate    = HMAC-SHA256("AWS4" + секрет, "20261021")
kRegion  = HMAC-SHA256(kDate,    "us-east-1")
kService = HMAC-SHA256(kRegion,  "s3")
kSigning = HMAC-SHA256(kService, "aws4_request")
Шаг 4 — подпись: Signature = hex(HMAC-SHA256(kSigning, строка для подписи)). Она вместе с идентификатором ключа, областью действия и списком подписанных заголовков помещается в Authorization.
Каждый элемент конструкции защищает от конкретной атаки. Хеш тела в каноническом запросе не позволяет подменить данные при неизменных заголовках. Подписанный Host не позволяет переслать запрос на другой сервер или в другой бакет при virtual-hosted-style. Время запроса не позволяет бесконечно воспроизводить перехваченный запрос: AWS отклоняет запросы, время которых расходится со временем сервера больше чем на 15 минут, с ошибкой RequestTimeTooSkewed 7. Поэтому неверно выставленные часы клиента — классическая причина отказа всех запросов к S3 при правильных ключах. Цепочка HMAC позволяет серверу кешировать производный ключ на сутки и регион, не храня секрет в каждом сервисе. Подпись можно вычислить без каких-либо библиотек AWS — скрипт sigv4_manual.py из окружения лабораторной работы делает это на стандартной библиотеке Python и проверяет себя на примере из документации Amazon S3.
Тело запроса не обязательно хешировать заранее: для больших потоков SDK используют либо значение UNSIGNED-PAYLOAD в x-amz-content-sha256 (целостность тогда обеспечивают TLS и контрольные суммы), либо потоковую подпись по кускам. Современные версии AWS CLI и SDK вдобавок по умолчанию передают контрольную сумму тела в заголовке x-amz-checksum-crc64nvme; сервер, не знающий этого заголовка, может отвечать ошибкой — с этим сталкиваются старые S3-совместимые реализации.
Presigned URL
Подпись не обязана находиться в заголовке. Если все её компоненты перенести в параметры запроса, получится presigned URL — заранее подписанная ссылка, которая разрешает одну конкретную операцию над одним объектом до заданного момента. Владелец ключа выпускает ссылку локально, без обращения к серверу:
aws s3 presign s3://notes-att/att/private.txt --expires-in 300
http://127.0.0.1:9000/notes-att/att/private.txt?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=lab10admin%2F20261021%2Fus-east-1%2Fs3%2Faws4_request&X-Amz-Date=20261021T210842Z&X-Amz-Expires=300&X-Amz-SignedHeaders=host&X-Amz-Signature=...
В подпись входят метод, путь, все параметры X-Amz-*, кроме самой подписи, и заголовок Host; тело не хешируется (UNSIGNED-PAYLOAD). Получатель ссылки выполняет обычный GET (или PUT, если ссылка выпущена для записи) без каких-либо ключей, а сервер проверяет подпись, срок X-Amz-Date + X-Amz-Expires и права того, кто подписал. На учебном сервере изменение одного символа ключа объекта, срока или подписи даёт 403 SignatureDoesNotMatch, истечение срока — 403 AccessDenied с сообщением Request has expired, а срок больше 604 800 секунд — 400 AuthorizationQueryParametersError: в AWS presigned URL с подписью SigV4 действителен не более 7 суток 5.
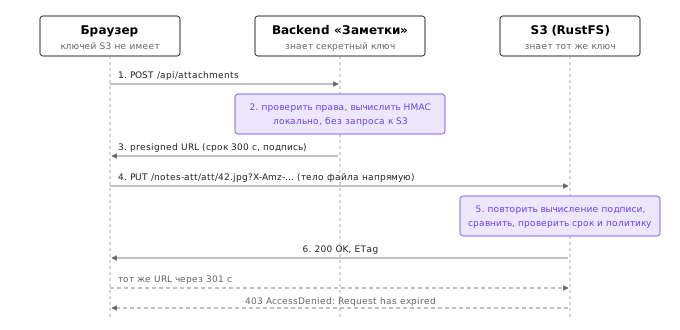
Схема на рисунке ниже показывает типичное применение в «Заметках». Браузер не получает ключей S3 и не передаёт файл через backend. Он просит backend разрешить загрузку; backend проверяет права пользователя, выбирает ключ объекта и выпускает presigned URL для PUT на несколько минут; браузер загружает файл прямо в хранилище. Backend не тратит память и сеть на пересылку мегабайтов, а хранилище получает только разрешённую операцию над заранее выбранным ключом.
У presigned URL есть свойства, которые нужно учитывать. Это токен на предъявителя: любой, кто получил ссылку (из журнала прокси, истории браузера, переписки), может воспользоваться ею до истечения срока. Отдельную ссылку нельзя отозвать: она не хранится на сервере. Прекратить её действие можно только лишив прав того, кто её подписал, или сменив его ключ — что отзовёт сразу все выпущенные им ссылки. Если ссылка подписана временными учётными данными (тема 11), она перестаёт работать, когда истекают эти учётные данные, даже если её собственный срок ещё не прошёл. Отсюда практика: короткие сроки (минуты для загрузки, часы для скачивания), отдельная учётная запись с минимальными правами для подписи ссылок и ключи объектов, которые нельзя угадать.
S3-совместимые серверы и судьба MinIO
Интерфейс S3 реализуют многие системы, и слово «совместимый» в их описании означает разное. Ceph RGW — шлюз S3 и Swift поверх распределённого хранилища RADOS, промышленная система для больших кластеров. SeaweedFS — распределённая файловая система с S3-шлюзом. Garage — лёгкий геораспределённый сервер, который по собственной таблице совместимости не поддерживает версионирование и политики бакета. versitygw — шлюз, отображающий S3 на обычный POSIX-каталог. RustFS — сервер на Rust под лицензией Apache-2.0 с версионированием, правилами жизненного цикла, Object Lock и кодами стирания. Перед выбором сервера нужно сверить таблицу поддерживаемых операций с тем, что требуется приложению: «S3-совместимый» без версионирования не годится для резервных копий, которые должны переживать удаление.
Долгое время стандартным выбором для учебных стендов и локальной разработки был MinIO. Ситуация изменилась в 2025–2026 годах. 15 октября 2025 года README репозитория объявил, что community-редакция распространяется только в исходных кодах, без готовых исполняемых файлов и образов; 3 декабря 2025 года проект переведён в режим сопровождения; в феврале 2026 года README сообщает, что репозиторий больше не сопровождается, и предлагает коммерческие продукты компании 13. На октябрь 2026 года репозитории minio/minio и клиента minio/mc находятся в архиве, а образы minio/minio и minio/mc на Docker Hub недоступны. Многие руководства и примеры в интернете по-прежнему начинаются с docker run minio/minio; они перестали работать, и это наглядный пример того, почему зависимость от одного поставщика открытого ПО — риск, который стоит учитывать при выборе инфраструктуры. В курсе используется RustFS 1.0.3 с клиентами AWS CLI v2 и boto3, которые не привязаны к конкретному серверу.
Жизнь объекта: версии, жизненный цикл, составная загрузка, согласованность
Версионирование и маркеры удаления
Без версионирования PUT по существующему ключу безвозвратно заменяет объект, а DELETE безвозвратно удаляет его. Версионирование (англ. versioning) включается на уровне бакета и меняет обе операции 5. Каждый PUT создаёт новую версию с уникальным идентификатором VersionId, старые версии сохраняются. DELETE без указания версии ничего не удаляет: он добавляет поверх стека версий маркер удаления (англ. delete marker) — особую версию без тела. Обычный GET по ключу, текущая версия которого — маркер, возвращает 404 Not Found с заголовком x-amz-delete-marker: true, и объект выглядит удалённым. DELETE с параметром versionId удаляет конкретную версию навсегда — в том числе и сам маркер.
Отсюда способ восстановить «удалённый» объект: найти маркер удаления и удалить его по идентификатору версии. Текущей снова станет предыдущая версия. На учебном сервере последовательность из двух PUT и DELETE выглядит так:
aws s3api delete-object --bucket notes-att --key att/n.txt
aws s3api list-object-versions --bucket notes-att --prefix att/n.txt
{
    "DeleteMarker": true,
    "VersionId": "1b990464-80ab-49f8-afd0-5a7daa659d52"
}
{
    "Versions": [
        { "Key": "att/n.txt", "VersionId": "a92d97c0-6e89-4432-bf08-86e977285e33", "IsLatest": false, "Size": 3, ... },
        { "Key": "att/n.txt", "VersionId": "16e7d32e-cab2-4239-95c6-c4c645f426e2", "IsLatest": false, "Size": 3, ... }
    ],
    "DeleteMarkers": [
        { "Key": "att/n.txt", "VersionId": "1b990464-80ab-49f8-afd0-5a7daa659d52", "IsLatest": true, ... }
    ]
}
Маркер имеет IsLatest: true, обе версии данных на месте. После aws s3api delete-object --bucket notes-att --key att/n.txt --version-id 1b990464-... обычный GET снова возвращает версию a92d97c0-... с содержимым v2. Временная шкала на рисунке ниже показывает тот же сценарий.
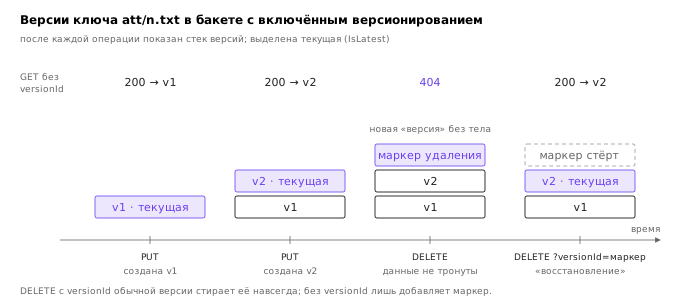
У бакета три состояния версионирования: не включено, включено (Enabled) и приостановлено (Suspended). Вернуть бакет в состояние «не включено» нельзя; приостановка прекращает создание новых версий, но сохраняет существующие. В AWS после первого включения версионирования изменение может распространяться по системе до 15 минут, и в это время записи могут вести себя как в неверсионированном бакете 5. Каждая версия хранится и оплачивается как отдельный объект: файл в 100 МБ, перезаписанный сто раз, занимает 10 ГБ. Поэтому версионирование почти всегда сопровождается правилом жизненного цикла, удаляющим неактуальные версии.
Правила жизненного цикла
Правила жизненного цикла (англ. lifecycle rules) — конфигурация бакета, по которой хранилище само удаляет объекты или переводит их в другой класс хранения в зависимости от возраста 8. Правило выбирает объекты фильтром (префикс ключа, теги, размер) и содержит одно или несколько действий:
Expiration— удалить текущую версию через N дней после создания (в версионированном бакете — добавить маркер удаления);Transition— перевести объект в другой класс хранения через N дней;NoncurrentVersionExpiration— окончательно удалить версию через N дней после того, как она перестала быть текущей;AbortIncompleteMultipartUpload— прервать составную загрузку, не завершённую за N дней, и удалить её части;- флаг
ExpiredObjectDeleteMarkerв действииExpiration— удалить маркер удаления, под которым не осталось версий.
Конфигурация для бакета вложений «Заметок» из лабораторной работы: неактуальные версии вложений хранятся сутки, временные объекты в tmp/ удаляются через сутки, незавершённые загрузки прерываются через сутки.
{
  "Rules": [
    { "ID": "expire-noncurrent-attachments", "Status": "Enabled",
      "Filter": { "Prefix": "att/" },
      "NoncurrentVersionExpiration": { "NoncurrentDays": 1 } },
    { "ID": "expire-tmp", "Status": "Enabled",
      "Filter": { "Prefix": "tmp/" },
      "Expiration": { "Days": 1 } },
    { "ID": "abort-incomplete-mpu", "Status": "Enabled",
      "Filter": { "Prefix": "" },
      "AbortIncompleteMultipartUpload": { "DaysAfterInitiation": 1 } }
  ]
}
aws s3api put-bucket-lifecycle-configuration --bucket notes-att \
    --lifecycle-configuration file://policies/lifecycle.json
aws s3api get-bucket-lifecycle-configuration --bucket notes-att
Важно понимать, когда правило срабатывает. Хранилище не ставит таймер на каждый объект: фоновый процесс периодически просматривает объекты и ставит подходящие в очередь на асинхронное выполнение. AWS отсчитывает дни от создания объекта и округляет момент срабатывания до ближайшей следующей полуночи по UTC, а между наступлением срока и фактическим удалением возможна задержка; за хранение уже просроченного объекта плата не взимается 8. Наименьшая единица срока — сутки, поэтому в рамках одной лабораторной работы увидеть удаление нельзя: проверяемым результатом становится то, что сервер принял правила и возвращает их без искажений. Наблюдение за срабатыванием — задача на следующий день.
Составная загрузка
Загрузка большого объекта одним PUT плоха по трём причинам: обрыв соединения на 99 % требует начинать сначала, одно TCP-соединение плохо использует широкий канал, а размер данных надо знать заранее (заголовок Content-Length). Составная загрузка (англ. multipart upload) решает все три проблемы 5. Клиент вызывает CreateMultipartUpload и получает идентификатор загрузки UploadId; затем загружает части (англ. parts) запросами UploadPart с номерами от 1 до 10 000 — независимо, в любом порядке, параллельно, с повтором только неудавшихся; в конце вызывает CompleteMultipartUpload со списком номеров и ETag частей, и сервер собирает из них объект. AbortMultipartUpload отменяет загрузку и удаляет части.
| Ограничение Amazon S3 | Значение |
|---|---|
Размер объекта, загружаемого одним PUT | до 5 ГиБ |
| Число частей одной загрузки | от 1 до 10 000 |
| Размер части | от 5 МиБ до 5 ГиБ; последняя часть может быть меньше 5 МиБ |
| Максимальный размер объекта | 48,8 ТиБ (50 ТБ) |
Частей в одном ответе ListParts | до 1000 |
Максимальный размер объекта вырос в декабре 2025 года: до этого он составлял 5 ТиБ, и это значение до сих пор встречается в книгах и статьях 6. Нынешний предел — прямое следствие двух других: 10\,000 \times 5 ГиБ = 50\,000 ГиБ \approx 48{,}8 ТиБ. Обратный расчёт полезен на практике: при минимальной части 5 МиБ наибольший объект составит 10\,000 \times 5 МиБ \approx 48{,}8 ГиБ, поэтому для резервной копии в 1 ТиБ часть должна быть не меньше \frac{1\,048\,576 \text{ МиБ}}{10\,000} \approx 105 МиБ. Утилиты (aws s3 cp, менеджеры передачи в SDK) подбирают размер части сами; при ручной загрузке через s3api или собственный код это забота программиста. AWS рекомендует переходить на составную загрузку с объектов от 100 МБ — это рекомендация, а не правило 5.
ETag объекта после составной загрузки — не MD5 содержимого. Он вычисляется как MD5 от склеенных двоичных MD5 всех частей с суффиксом «-число частей». Для файла в 12 МиБ, загруженного частями 5 + 5 + 2 МиБ, учебный сервер вернул "12fe8e66682a0511b94a7f4cb257cbc5-3", и то же значение получается локально:
split -b 5M -d big.bin part.
for f in part.0*; do md5sum "$f" | cut -c1-32; done | xxd -r -p | md5sum
12fe8e66682a0511b94a7f4cb257cbc5 -
Отсюда два следствия: сравнивать ETag с md5sum файла можно только для простых загрузок, а один и тот же файл, загруженный с разным размером частей, получит разные ETag. Части незавершённых загрузок не видны в листинге объектов, но занимают место и оплачиваются; найти их можно командой aws s3api list-multipart-uploads, а убирать — правилом AbortIncompleteMultipartUpload.
Согласованность чтения после записи
Распределённое хранилище, раскладывающее данные и индекс ключей по многим серверам, может отвечать на чтение по устаревшей копии индекса. До декабря 2020 года Amazon S3 давал согласованность в конечном счёте (англ. eventual consistency) для перезаписи и удаления: после успешного PUT по существующему ключу GET некоторое время мог возвращать старое содержимое, а только что удалённый объект — появляться в листинге. Приложения обходили это записью под уникальными ключами и внешними индексами. 1 декабря 2020 года AWS объявила строгую согласованность чтения после записи (англ. strong read-after-write consistency) для всех операций PUT и DELETE с объектами во всех регионах без изменения цены и производительности 11: после успешного ответа на запись любой последующий GET, HEAD и LIST видит её результат 5.
Строгая согласованность отдельной операции не означает транзакций. Два клиента, одновременно записывающие объект под одним ключом, не получат ошибки: побеждает последняя запись (в версионированном бакете сохранятся обе версии). Механизма блокировки объекта в S3 нет; есть условная запись: заголовок If-None-Match: * в PUT заставляет сервер отказать, если объект уже существует, а If-Match с ETag — если объект изменился после того, как клиент его прочитал 5. Именно условная запись позволила OpenTofu отказаться от отдельной таблицы блокировок: с параметром use_lockfile бэкенд создаёт файл блокировки рядом с состоянием (тема 9). Конфигурация самого бакета — политики, правила жизненного цикла, настройка версионирования — в AWS распространяется с задержкой, о чём сказано выше. S3-совместимые серверы реализуют согласованность по-своему, и обещание AWS на них автоматически не переносится: свойство нужно проверять по документации конкретного сервера.
Доступ и защита данных
Политика бакета и порядок её вычисления
Подпись SigV4 устанавливает, кто выполняет запрос, — это аутентификация. Решение, можно ли ему это сделать, принимает авторизация, и в S3 её основной инструмент — политики в формате JSON, подробно разбираемые в теме 11. Политика бакета (англ. bucket policy) прикрепляется к самому бакету и может давать права в том числе анонимным клиентам. Политика из лабораторной работы разрешает всем читать объекты под префиксом public/:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "PublicReadOfPublicPrefix",
      "Effect": "Allow",
      "Principal": "*",
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::notes-att/public/*"
    }
  ]
}
Поле Principal: "*" означает «любой, включая неаутентифицированных», Action — разрешённую операцию API, Resource — ARN объектов (у бакета и объектов разные ARN: arn:aws:s3:::notes-att и arn:aws:s3:::notes-att/*, и действие s3:ListBucket относится к первому). Вычисление следует общему правилу IAM: по умолчанию всё запрещено (неявный запрет), явное Allow разрешает, явное Deny побеждает любое Allow. На учебном сервере с этой политикой анонимный curl к public/h.txt получает 200, а к att/private.txt, к листингу бакета и анонимный PUT в public/ — 403 AccessDenied: политика разрешила ровно одно действие на одном префиксе.
Явный запрет полезен для обязательных требований. Например, правило с "Effect": "Deny", "Action": "s3:*" и условием "Bool": { "aws:SecureTransport": "false" } отвергает любые запросы к бакету по незашифрованному HTTP, кто бы их ни подписал.
Кроме политик у S3 есть списки управления доступом (англ. access control lists, ACL) — механизм первых лет сервиса, в котором права задаются на каждом объекте отдельно и принадлежат загрузившему его аккаунту. Совмещение ACL и политик затрудняет ответ на вопрос «кто имеет доступ к этому объекту». С апреля 2023 года новые бакеты в AWS по умолчанию создаются с отключёнными ACL (владелец бакета владеет всеми объектами), и AWS рекомендует управлять доступом только политиками 5.
Блокировка публичного доступа
Утечки данных из бакетов, открытых на чтение всем, — один из самых частых инцидентов облачной безопасности: достаточно одной ошибочной строки "Principal": "*" с "Resource": "arn:aws:s3:::bucket/*". Блокировка публичного доступа (англ. Block Public Access) — набор из четырёх флагов на уровне бакета или всего аккаунта, которые перекрывают политики и ACL 5:
| Флаг | Действие |
|---|---|
BlockPublicAcls | отвергать запросы, устанавливающие публичные ACL |
IgnorePublicAcls | игнорировать уже существующие публичные ACL |
BlockPublicPolicy | отвергать установку политики бакета, дающей публичный доступ |
RestrictPublicBuckets | при наличии публичной политики пропускать только запросы субъектов того же аккаунта и сервисов AWS |
Новые бакеты в AWS создаются со всеми четырьмя флагами. Блокировка работает как предохранитель уровнем выше: даже если кто-то по ошибке напишет публичную политику, она не подействует, пока блокировку явно не снимут. На учебном сервере после установки флагов анонимный запрос к public/h.txt, только что отдававшийся со статусом 200, получает 403, хотя политика осталась прежней. Правильная схема для «Заметок» — держать блокировку включённой, а публичную раздачу картинок, если она нужна, выполнять через presigned URL или сеть доставки контента с собственной идентичностью доступа к бакету.
Шифрование на стороне сервера и на стороне клиента
Шифрование данных в состоянии покоя (англ. encryption at rest) в S3 выполняется на стороне сервера (англ. server-side encryption, SSE) в одном из трёх вариантов, различающихся тем, кто управляет ключами 10:
- SSE-S3 — сервис шифрует каждый объект ключом, которым полностью управляет сам (AES-256). С 5 января 2023 года в AWS это шифрование применяется ко всем новым объектам автоматически и бесплатно. Защищает от утечки физических дисков, но не от того, кто имеет право на
s3:GetObject: расшифровка выполняется прозрачно для любого авторизованного запроса; - SSE-KMS — ключ объекта шифруется ключом из сервиса управления ключами (англ. Key Management Service, KMS), то есть применяется конвертное шифрование (англ. envelope encryption). Чтобы прочитать объект, нужно право не только на
s3:GetObject, но и наkms:Decryptдля этого ключа; каждое использование ключа записывается в журнал аудита. Это вторая, независимая граница доступа, но и дополнительные запросы к KMS с их ценой и лимитами; - SSE-C — клиент передаёт ключ шифрования в заголовках каждого запроса, сервер шифрует им данные и забывает ключ, сохраняя лишь его хеш для проверки. Потеря ключа означает потерю данных; передавать ключ можно только по HTTPS.
Шифрование на стороне клиента (англ. client-side encryption) — четвёртый вариант: приложение шифрует данные до отправки, и хранилище никогда не видит открытого текста. Это единственный вариант, защищающий от компрометации самого поставщика хранения, но он лишает сервер возможности что-либо делать с содержимым и перекладывает управление ключами на приложение.
Важно точно понимать, от чего шифрование на стороне сервера не защищает. Если утёк ключ доступа backend «Заметок», злоумышленник читает вложения через обычный API, и SSE-S3 расшифрует их для него так же услужливо, как для backend. Защитой от этого служат узкие политики, короткоживущие учётные данные (тема 11) и, для SSE-KMS, отдельные права на ключ.
Object Lock и защита резервных копий
Версионирование защищает от случайного удаления, но не от намеренного: тот, у кого есть право s3:DeleteObjectVersion, удалит все версии. Сценарий атаки программ-вымогателей на облачную инфраструктуру выглядит именно так: получив ключи администратора, злоумышленник сначала удаляет резервные копии, затем шифрует или удаляет основные данные. Object Lock — механизм хранения по модели WORM (англ. write once, read many), запрещающий удалять и перезаписывать версию объекта до заданной даты 9. Он работает только в версионированном бакете и защищает конкретную версию: новые версии и маркеры удаления поверх неё создавать можно, но защищённую версию удалить нельзя.
Срок хранения (англ. retention period) задаётся для версии явно или по умолчанию для всего бакета и действует в одном из двух режимов. В режиме управления (англ. governance mode) пользователи с особым правом s3:BypassGovernanceRetention могут снять защиту, передав заголовок обхода; режим удобен для проверки настроек. В режиме соответствия (англ. compliance mode) удалить версию до истечения срока не может никто, включая администратора аккаунта, а срок можно только продлевать. Отдельно существует юридическое удержание (англ. legal hold) — защита без срока, действующая до явного снятия. Документация AWS описывает также переменный срок, отсчитываемый от события.
Для «Заметок» отсюда следует схема резервного копирования: ночной pg_dump записывается в отдельный бакет с Object Lock в режиме соответствия на 30 дней, учётная запись, которая пишет копии, имеет право только на s3:PutObject, а правило жизненного цикла удаляет версии старше срока хранения. Даже полный захват кластера и ключей backend не позволит уничтожить копии последних 30 дней. Цена — невозможность удалить данные раньше срока, в том числе по ошибке записанные; поэтому режим соответствия включают после проверки настроек в режиме управления.
Эксплуатация: стоимость, Kubernetes, ограничения
Классы хранения и расчёт стоимости
Счёт за объектное хранилище в публичном облаке складывается из трёх частей: хранение (за гигабайт в месяц), запросы (за тысячу операций) и исходящий трафик в интернет (за гигабайт). Классы хранения (англ. storage classes) меняют соотношение между ними: чем дешевле хранение, тем дороже обращение и тем дольше минимальный оплачиваемый срок. Цены ниже взяты из прайс-листа AWS для региона us-east-1 (публикация 15.10.2026) 14; в других регионах и у других поставщиков они иные, но структура та же.
| Класс | Хранение, долл./ГБ·мес | Извлечение, долл./ГБ | Минимальный срок | Особенности |
|---|---|---|---|---|
| S3 Standard | 0,023 (первые 50 ТБ) | — | — | запросы: PUT 0,005 и GET 0,0004 за 1000 |
| S3 Standard-IA | 0,0125 | 0,01 | 30 дней | объект меньше 128 КБ оплачивается как 128 КБ; PUT 0,01 и GET 0,001 за 1000 |
| S3 Glacier Instant Retrieval | 0,004 | 0,03 | 90 дней | чтение в миллисекундах, дорогие запросы |
| S3 Glacier Flexible Retrieval | 0,0036 | от 0 до 0,03 по скорости | 90 дней | объект нужно сначала восстановить — минуты или часы |
| S3 Glacier Deep Archive | около 0,001 | от 0,0025 | 180 дней | восстановление — часы |
Числовой пример. Вложения «Заметок» занимают 1024 ГБ, средний объект — 256 КиБ. За месяц пользователи загружают 500 000 вложений и скачивают 2 000 000, все скачивания идут в интернет: 2\,000\,000 \times 256 КиБ \approx 488 ГБ трафика. Исходящий трафик стоит 0,09 долл./ГБ для первых 10 ТБ (бесплатный ежемесячный объём не учитываем). Для класса Standard в долларах США:
\begin{aligned} \text{хранение} &= 1024 \times 0{,}023 = 23{,}55 \\ \text{PUT} &= 500 \times 0{,}005 = 2{,}50 \\ \text{GET} &= 2000 \times 0{,}0004 = 0{,}80 \\ \text{трафик} &= 488 \times 0{,}09 = 43{,}95 \\ \text{итого в месяц} &\approx 70{,}80. \end{aligned}
Для Standard-IA хранение дешевле (1024 \times 0{,}0125 = 12{,}80), но запросы дороже (5{,}00 + 2{,}00) и добавляется плата за извлечение (488 \times 0{,}01 = 4{,}88); с тем же трафиком итог около 68,63 долл. Выводы из расчёта важнее чисел. Во-первых, для данных, которые активно скачивают, главная статья расхода — исходящий трафик (62 % счёта), и выбор класса хранения меняет итог лишь на несколько процентов; экономить здесь нужно кешированием и сетью доставки контента. Во-вторых, «холодный» класс выгоден только для действительно холодных данных: если бы те же вложения скачивали десять раз в месяц, плата за извлечение в Standard-IA превысила бы экономию на хранении. Для резервных копий картина обратная: терабайт копий в Standard стоит 23,55 долл. в месяц, в Glacier Instant Retrieval — 4,10 долл., а извлекаются они только при восстановлении. Перевод копий в холодный класс через 7–30 дней — типичное правило Transition. В-третьих, миллионы мелких объектов дороги не хранением, а запросами: миллион объектов по 1 КБ занимает около гигабайта (2–3 цента в месяц), а их однократная запись стоит 5 долл.
У собственного S3-совместимого сервера структура затрат другая: оплачиваются диски с учётом коэффициента кодирования из второго раздела, серверы, сеть и труд эксплуатации, а запросы и трафик внутри своей сети бесплатны. Сравнение «своё против облака» без учёта этих статей некорректно.
S3 в Kubernetes: SDK против монтирования
Приложение в Kubernetes обращается к S3 так же, как вне кластера: через SDK по HTTPS. Конфигурацию — адрес сервера, имя бакета, регион — передают через ConfigMap, а учётные данные либо через Secret (тема 8), либо, что лучше, через идентичность нагрузки: в облаке под получает короткоживущие учётные данные, привязанные к его ServiceAccount, и статический ключ не нужен вовсе (тема 11). Для backend «Заметок» это выглядит как несколько переменных окружения и вызовы put_object, get_object и generate_presigned_url в коде.
Соблазнительная альтернатива — смонтировать бакет как каталог и оставить приложение работать с файлами. Для этого есть FUSE-драйверы: s3fs-fuse, Mountpoint for Amazon S3, драйверы CSI на их основе. Но монтирование не превращает объектное хранилище в файловое; оно лишь переводит системные вызовы в запросы S3, и всё, чего нет в модели S3, либо эмулируется дорого, либо не поддерживается. Документация Mountpoint формулирует это прямо 12: запись поддерживается только в новые файлы, последовательно с начала (перезапись существующего файла — только с отдельным флагом и усечением до нуля), файл становится виден другим клиентам только после закрытия; дозапись и переименование работают лишь для особого класса S3 Express One Zone; каталоги нельзя удалять и переименовывать; жёстких и символических ссылок нет; права chmod/chown не меняются; операции, которые нельзя выполнить эффективно, завершаются ошибкой ввода-вывода. s3fs-fuse идёт другим путём и эмулирует больше — например, частичную запись через загрузку и повторную выгрузку всего объекта, переименование через копирование и удаление, — но эти операции неатомарны, медленны и не согласованы между несколькими клиентами.
Отсюда простое правило. Монтирование уместно для неизменяемых данных, которые читаются последовательно большими кусками приложением, не умеющим работать с S3: обучающие наборы данных, архивы журналов для анализа, медиафайлы для перекодирования. Монтирование — ошибка для всего, что рассчитывает на семантику POSIX. База данных на смонтированном бакете не работает: PostgreSQL перезаписывает страницы по 8 КиБ в середине файлов данных, дописывает журнал WAL и вызывает fsync, а каждая такая операция превратилась бы в перезапись многомегабайтного объекта или ошибку. Именно поэтому СУБД нельзя развернуть прямо поверх S3 без промежуточного слоя: даже системы, хранящие данные в объектном хранилище (Loki из темы 12, Thanos, аналитические движки), пишут туда неизменяемые блоки целиком и держат изменяемое состояние на локальном диске. Резервные копии базы в S3 — правильное решение; база на S3 — нет.
Ограничения и типичные ошибки интерпретации
Модель S3 проста, и именно поэтому её часто понимают по аналогии с файловой системой, а аналогия подводит. Ниже собраны ошибки, которые встречаются чаще всего.
«В бакете есть папки». Есть только ключи. Пустую «папку» веб-консоли создают объектом нулевого размера с ключом, оканчивающимся на /; переименование «папки» — копирование и удаление каждого объекта; права на «папку» — политика на префикс ключей.
«Объект можно дописать или поправить». Нельзя: любое изменение — запись объекта целиком. Журнал, в который приложение пишет строку за строкой, хранят локально и выгружают в S3 готовыми блоками.
«Версионирование — это резервная копия». Версии живут в том же бакете и том же аккаунте и удаляются правом s3:DeleteObjectVersion; удаление бакета или аккаунта уносит их вместе с данными. Защиту от злонамеренного удаления дают Object Lock, репликация в другой аккаунт и раздельные учётные записи.
«Правило жизненного цикла сработает сразу». Правило выполняется фоновым процессом с точностью до суток, и между сроком и удалением возможна задержка. Для удаления «через пять минут» оно не предназначено.
«Presigned URL можно отозвать». Отдельную ссылку — нельзя: только лишить прав или ключа того, кто её подписал, вместе со всеми остальными его ссылками. Срок должен быть коротким с самого начала.
«Шифрование на стороне сервера защищает от утечки ключей доступа». Не защищает: сервер расшифровывает данные для любого авторизованного запроса. От утечки ключей защищают узкие политики, короткоживущие учётные данные и отдельные права на ключ KMS.
«ETag — это MD5 файла». Только для объектов, загруженных одним PUT без SSE-KMS. После составной загрузки ETag зависит от размера частей.
«Коды стирания переживают потерю половины дисков». Схема k+m переживает ровно m отказов в разных доменах отказа; доля дисков зависит от соотношения k и m.
«S3-совместимый — значит, совместимый во всём». Реализации различаются набором операций (версионирование, политики, Object Lock, условная запись), стилем адресации по умолчанию, поддержкой новых заголовков контрольных сумм и гарантиями согласованности. Перед выбором сервера и при обновлении SDK нужна проверка именно тех операций, на которые рассчитывает приложение.
«Объектное хранилище медленное» или «быстрое». Задержка одной операции определяется HTTP-запросом, подписью, поиском ключа и сетью и заметно выше, чем у локального диска; суммарная пропускная способность параллельных запросов к многим ключам может быть очень высокой. Без указания операции, размера объекта, степени параллелизма и условий измерения такие утверждения бессмысленны — поэтому в лабораторной работе задержка измеряется, а не берётся из таблицы.
Наконец, учебный сервер на одном диске проверяет протокол, но не надёжность: он не переживает отказа своего диска, не реплицирует данные и не показывает поведения под нагрузкой. Выводы о долговечности и производительности делаются по документации и измерениям промышленной конфигурации.
Итоги темы
Хранилища различаются прежде всего тем, где находится файловая система. Блочное хранилище отдаёт клиенту массив блоков, и файловая система клиента полностью им распоряжается — отсюда минимальная задержка, частичная перезапись и fsync, нужные базе данных, и принципиально один узел на запись. Файловое хранилище держит файловую систему на сервере и даёт многим клиентам общее дерево каталогов с близкой к POSIX семантикой — режим RWX, нужный унаследованным приложениям, ценой сетевого запроса на каждую операцию с метаданными и ослабленной согласованности кешей. Объектное хранилище файловой системы не имеет вовсе: объект записывается целиком по HTTP и адресуется ключом в плоском пространстве имён, и это позволяет масштабировать его почти без координации.
Надёжность обеспечивается избыточностью двух видов. Репликация проста и быстро восстанавливается, но тройная копия расходует втрое больше дисков. Код стирания k+m переживает m отказов с коэффициентом (k+m)/k — в схеме 4+2 это 1,5 вместо 3, — платя усиленным трафиком при восстановлении, неудобством для мелких объектов и требованием разнести фрагменты по независимым доменам отказа.
S3 — это протокол поверх HTTP. Каждая операция — отдельный запрос, аутентифицированный подписью SigV4: канонический запрос, строка для подписи, ключ из цепочки HMAC и сама подпись, чувствительная к каждому байту пути, к заголовку Host и к часам клиента. Presigned URL — та же подпись, перенесённая в параметры, то есть временное разрешение одной операции, которое нельзя отозвать по отдельности. Версионирование превращает удаление в добавление маркера, правила жизненного цикла выполняются фоновым процессом с точностью до суток, составная загрузка ограничена 10 000 частей от 5 МиБ, а с декабря 2020 года чтение после записи в AWS строго согласовано. Доступ определяют политики с приоритетом явного запрета и предохранитель Block Public Access; шифрование на стороне сервера защищает диски, а не данные от владельца украденного ключа; от уничтожения резервных копий защищает Object Lock.
На практике это означает: база данных — на блочном томе, вложения и резервные копии — в объектном хранилище через SDK и presigned URL, общая файловая система — только там, где без неё нельзя, а монтирование бакета — только для неизменяемых данных. Тема 11 продолжает разговор о доступе: политики IAM, идентичность нагрузок вместо статических ключей S3 и изоляция компонентов «Заметок» внутри кластера. S3-совместимый сервер этой темы служит бэкендом состояния OpenTofu в теме 9, а в теме 12 объектное хранилище появляется как долговременная память систем журналов и метрик.
Литература
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017.
- Weil S. A., Brandt S. A., Miller E. L., Long D. D. E., Maltzahn C. Ceph: A Scalable, High-Performance Distributed File System. — Proceedings of the 7th Symposium on Operating Systems Design and Implementation (OSDI '06), 2006, P. 307–320.
- Reed I. S., Solomon G. Polynomial Codes Over Certain Finite Fields. — Journal of the Society for Industrial and Applied Mathematics, 1960, vol. 8, no. 2, P. 300–304, DOI: 10.1137/0108018.
- Haynes T., Noveck D. (eds.) Network File System (NFS) Version 4 Protocol. — RFC 7530, IETF, 2015. https://www.rfc-editor.org/rfc/rfc7530
- Amazon Simple Storage Service User Guide. — https://docs.aws.amazon.com/AmazonS3/latest/userguide/Welcome.html (дата обращения: 22.10.2026).
- Amazon S3 increases the maximum object size to 50 TB. — AWS What's New, 02.12.2025. https://aws.amazon.com/about-aws/whats-new/2025/12/amazon-s3-maximum-object-size-50-tb/ (дата обращения: 22.10.2026).
- Amazon S3 API Reference. Authenticating Requests (AWS Signature Version 4). — https://docs.aws.amazon.com/AmazonS3/latest/API/sig-v4-authenticating-requests.html (дата обращения: 22.10.2026).
- Amazon S3 User Guide. Managing the lifecycle of objects. — https://docs.aws.amazon.com/AmazonS3/latest/userguide/object-lifecycle-mgmt.html (дата обращения: 22.10.2026).
- Amazon S3 User Guide. Locking objects with Object Lock. — https://docs.aws.amazon.com/AmazonS3/latest/userguide/object-lock.html (дата обращения: 22.10.2026).
- Amazon S3 User Guide. Protecting data with encryption. — https://docs.aws.amazon.com/AmazonS3/latest/userguide/UsingEncryption.html (дата обращения: 22.10.2026).
- Barr J. Amazon S3 Update — Strong Read-After-Write Consistency. — AWS News Blog, 01.12.2020. https://aws.amazon.com/blogs/aws/amazon-s3-update-strong-read-after-write-consistency/ (дата обращения: 22.10.2026).
- Mountpoint for Amazon S3. File system behavior. — https://github.com/awslabs/mountpoint-s3/blob/main/doc/SEMANTICS.md (дата обращения: 22.10.2026).
- MinIO. README репозитория minio/minio (история изменений октябрь 2025 — февраль 2026). — https://github.com/minio/minio (дата обращения: 22.10.2026).
- Amazon S3 Pricing; AWS Price List API, offer AmazonS3 и AWSDataTransfer, us-east-1, публикация 15.10.2026. — https://aws.amazon.com/s3/pricing/ (дата обращения: 22.10.2026).