
Облачная безопасность и управление доступом
К этой теме приложение «Заметки» уже прошло весь путь от исходного кода до кластера: образы собраны (тема 4), компоненты запущены в Kubernetes и связаны через Service и DNS (тема 7), пароль базы лежит в Secret, а данные — на постоянном томе (тема 8), инфраструктура описана в OpenTofu (тема 9), вложения хранятся в S3 (тема 10). Всё это работает, но ни один из механизмов не отвечал на вопрос, кто имеет право выполнять действия и что произойдёт, если одна из частей системы окажется в руках злоумышленника. По умолчанию ответ неутешителен: любой под кластера может открыть соединение с любым другим подом, процесс в контейнере обычно работает от root, токен для обращения к API Kubernetes монтируется в каждый под, а образы содержат сотни пакетов, о большинстве которых автор приложения ничего не знает.
Безопасность облачного приложения не сводится к одному средству. Она складывается из нескольких независимых рубежей, каждый из которых закрывает свой класс угроз: управление доступом к API облака и кластера, изоляция процесса внутри узла, изоляция подов в сети, контроль происхождения и содержимого образов, журналирование действий. Если один рубеж прорван — уязвимость в приложении позволила выполнить код, — следующие ограничивают последствия. Этот принцип называют эшелонированной защитой (англ. defense in depth).
Изложение построено от угроз к механизмам. Первый раздел формулирует модель угроз облачного приложения и делит ответственность между провайдером и клиентом. Второй посвящён управлению доступом в облаке: сущностям IAM, вычислению политик, учётным записям для экстренного доступа и идентичности нагрузок. Третий прослеживает запрос к API Kubernetes через аутентификацию, авторизацию RBAC и контроль допуска. Четвёртый описывает изоляцию пода средствами Pod Security Standards и securityContext, пятый — сетевую изоляцию NetworkPolicy. Шестой раздел охватывает цепочку поставок образов, аудит и типичные ошибки. Примеры строятся на «Заметках» и на стенде лабораторной работы 11.
Модель угроз и разделение ответственности
Что атакуют в облачном приложении
Модель угроз (англ. threat model) — описание того, что в системе ценно, кто и какими путями может до этого добраться и какие механизмы этому препятствуют. Для «Заметок» ценны содержимое базы (заметки пользователей), учётные данные (пароль PostgreSQL, ключи доступа к S3, токены API кластера) и сама вычислительная мощность (захваченный кластер используют для майнинга или как плацдарм для атаки на другие системы). Модель угроз полезна тем, что превращает расплывчатое «сделать безопасно» в перечень конкретных вопросов, на каждый из которых есть проверяемый ответ.
Многие известные инциденты в облаках начинались не с изощрённых уязвимостей, а с ошибок конфигурации и управления доступом: утёкших долговременных ключей, избыточных прав, открытых наружу ресурсов. Рекомендации NIST по безопасности контейнеров выделяют риски образов, реестра, оркестратора, контейнеров и хоста 2; в таблице ниже они сведены в перечень, который определяет структуру темы.
| Угроза | Как выглядит на практике | Чем закрывается | Где в теме |
|---|---|---|---|
| Утечка долговременных ключей | ключ доступа к облаку в git, в слое образа, в переменной CI | короткоживущие учётные данные, идентичность нагрузок | раздел 2 |
| Избыточные права | приложению выдана роль администратора «чтобы работало» | политики IAM, RBAC, наименьшие привилегии | разделы 2, 3 |
| Открытые ресурсы | публичный бакет, панель мониторинга без пароля, API без аутентификации | политики доступа (тема 10), аутентификация, NetworkPolicy | разделы 3, 5 |
| Выход за пределы контейнера | процесс от root с лишними возможностями ядра получает доступ к узлу | Pod Security Standards, securityContext | раздел 4 |
| Боковое перемещение | захваченный frontend подключается напрямую к базе | NetworkPolicy, default-deny | раздел 5 |
| Уязвимые и подменённые образы | старый базовый образ с известными CVE, образ из чужого реестра | сканирование, подпись, политики допуска | раздел 6 |
| Незамеченная атака | действия злоумышленника не оставляют следов | аудит API | раздел 6 |
Заметим, что ни одна строка таблицы не закрывается одним механизмом полностью. Сканер находит известные уязвимости, но не ошибки в логике приложения; NetworkPolicy ограничивает соединения, но не то, что передаётся по разрешённому соединению. Поэтому механизмы рассматриваются как слои, и для каждого важно понимать не только что он делает, но и что он не делает.
Разделение ответственности между провайдером и клиентом
В собственном центре обработки данных за всё отвечает одна организация: от охраны здания до пароля в конфигурации приложения. В облаке ответственность делится. Провайдер отвечает за безопасность самого облака (англ. security of the cloud): физические площадки, оборудование, гипервизор, сеть между центрами данных, программное обеспечение управляемых сервисов. Клиент отвечает за безопасность в облаке (англ. security in the cloud): за то, как он настроил выданные ему ресурсы, кому дал доступ, какие данные и как хранит 4. Эту договорённость называют моделью разделения ответственности (англ. shared responsibility model); схема на рисунке ниже показывает её в общем виде.
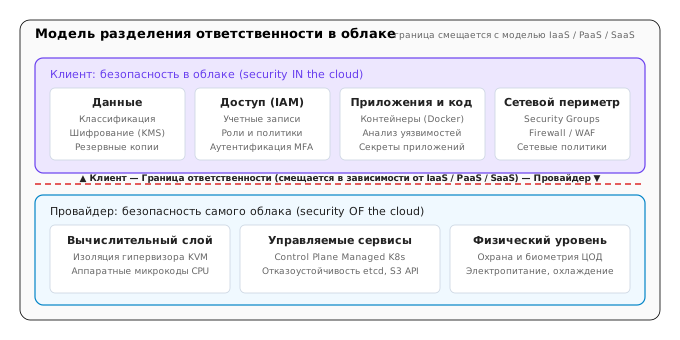
Граница смещается вместе с сервисной моделью из темы 1. В модели IaaS клиент получает виртуальную машину и отвечает за гостевую ОС, её обновления, межсетевой экран и всё, что выше. В управляемом Kubernetes провайдер обновляет и защищает плоскость управления (apiserver, etcd, планировщик), а рабочие узлы, как правило, остаются в общей зоне: провайдер выпускает обновлённые образы узлов, но решение о применении и окно обновления часто остаются за клиентом. В SaaS клиенту остаются по существу только учётные записи и данные.
| Уровень | IaaS (ВМ) | Управляемый Kubernetes | SaaS |
|---|---|---|---|
| Здания, оборудование, гипервизор | провайдер | провайдер | провайдер |
| Гостевая ОС, обновления ядра | клиент | узлы — совместно | провайдер |
| Плоскость управления Kubernetes | — | провайдер | — |
Образы, манифесты, securityContext | клиент | клиент | — |
| Учётные записи, права, политики IAM | клиент | клиент | клиент |
| Данные и их классификация | клиент | клиент | клиент |
Две нижние строки не уходят к провайдеру ни в одной модели. Именно на них приходится большинство инцидентов: провайдер не может знать, что бакет с резервными копиями не должен быть публичным, а сервисной учётной записи CI не нужны права на удаление базы данных. Отсюда практический вывод: механизмы управления доступом — главная зона ответственности клиента в любом облаке.
Нулевое доверие и принцип наименьших привилегий
Классическая модель безопасности сети опиралась на периметр: всё внутри корпоративной сети считалось доверенным, всё снаружи — нет. В облаке и тем более внутри кластера периметр размыт: поды разных команд делят одну сеть, сервисы обращаются к API провайдера через интернет, разработчики работают из дома. Архитектура нулевого доверия (англ. zero trust architecture), описанная в NIST SP 800-207, отказывается от доверия на основании сетевого расположения: каждый запрос к ресурсу аутентифицируется и авторизуется по отдельности, с учётом идентичности субъекта, состояния устройства и контекста, а доступ выдаётся минимально необходимый и на ограниченное время 1.
Для этой темы из нулевого доверия следуют три рабочих правила. Первое: идентичность важнее адреса — правило «разрешить подам из подсети 10.244.0.0/16» слабее правила «разрешить учётной записи notes-backend». Второе: принцип наименьших привилегий (англ. principle of least privilege) — каждому субъекту выдаются только те права, которые нужны для его задачи, и только на те ресурсы, с которыми он работает. Третье: исходить из предположения о компрометации — проектировать так, чтобы захват одного компонента не давал доступа ко всему остальному. Все механизмы следующих разделов — реализации этих правил на разных уровнях.
Управление идентификацией и доступом в облаке
Сущности IAM: субъект, ресурс, действие, политика, условие
Система управления идентификацией и доступом (англ. Identity and Access Management, IAM) облачного провайдера отвечает на один вопрос: может ли данный субъект выполнить данное действие над данным ресурсом в данных условиях. У разных провайдеров разные названия, но сущности одни и те же:
- субъект (англ. principal) — тот, от чьего имени выполняется запрос: пользователь-человек, группа, сервисная учётная запись, роль, которую временно принял субъект, или внешняя идентичность (например, под Kubernetes через федерацию);
- ресурс (англ. resource) — объект, над которым выполняется действие, с глобально уникальным именем: в AWS это ARN, например
arn:aws:s3:::notes-attachments/2026/a.png; - действие (англ. action) — операция API:
s3:GetObject,ec2:TerminateInstances,compute.instances.start; - политика (англ. policy) — документ, разрешающий или запрещающий набор действий над набором ресурсов; в одних облаках политика прикрепляется к субъекту или ресурсу (AWS), в других роль связывается с субъектом на уровне ресурса привязкой (англ. binding, так устроены Google Cloud и RBAC Kubernetes);
- условие (англ. condition) — дополнительное ограничение на контекст запроса: адрес источника, использование TLS, наличие MFA, время, метки ресурса.
Аутентификация (англ. authentication) устанавливает, кто выполняет запрос: проверяет подпись запроса ключом, пароль с вторым фактором, токен федерации. Авторизация (англ. authorization) решает, можно ли этому субъекту выполнить действие. Это две разные стадии с разными ошибками: неверный ключ приводит к отказу аутентификации, правильный ключ без нужной политики — к отказу авторизации. В теме 10 подпись SigV4 была механизмом аутентификации запроса к S3; политика бакета из той же темы — механизмом авторизации.
Политика в формате JSON и порядок её вычисления
Рассмотрим политику AWS IAM, которую можно прикрепить к роли backend «Заметок». Она разрешает читать и записывать вложения, но запрещает любые операции с бакетом без TLS и удаление резервных копий.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AttachmentsReadWrite",
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:PutObject"],
      "Resource": "arn:aws:s3:::notes-attachments/*"
    },
    {
      "Sid": "DenyPlainHTTP",
      "Effect": "Deny",
      "Action": "s3:*",
      "Resource": ["arn:aws:s3:::notes-attachments", "arn:aws:s3:::notes-attachments/*"],
      "Condition": { "Bool": { "aws:SecureTransport": "false" } }
    },
    {
      "Sid": "DenyDeleteBackups",
      "Effect": "Deny",
      "Action": "s3:DeleteObject",
      "Resource": "arn:aws:s3:::notes-attachments/backups/*"
    }
  ]
}
Поле Version — версия языка политик, а не дата документа; значение 2012-10-17 текущее. Каждый элемент Statement состоит из эффекта (Allow или Deny), списка действий, списка ресурсов и необязательного условия. Шаблоны * допускаются в действиях и ресурсах, но именно они чаще всего превращают узкую политику в широкую: "Action": "s3:*", "Resource": "*" разрешает всё во всех бакетах аккаунта.
Порядок вычисления определяет, что делать, когда несколько утверждений и политик противоречат друг другу 5. Исходное решение — неявный запрет: всё, что не разрешено, запрещено. Затем просматриваются все применимые политики; если хотя бы одно утверждение с Deny подходит к запросу, результат — явный запрет, и никакое Allow его не отменяет. Если явного запрета нет, запрос разрешается, только когда его разрешает политика субъекта или ресурса и не ограничивают ограничители более высокого уровня: политики управления организацией (SCP), границы полномочий (англ. permissions boundary), политики сессии. Правило «явный запрет побеждает» позволяет администратору организации поставить ограждение, которое не обойдёт никакая политика внутри аккаунта.
Проверим порядок вычисления на конкретных запросах роли с этой политикой (других политик нет):
| Запрос | Подходящие утверждения | Решение |
|---|---|---|
GetObject attachments/7.png по HTTPS | Allow из AttachmentsReadWrite | разрешено |
GetObject attachments/7.png по HTTP | Allow и Deny из DenyPlainHTTP | явный запрет |
DeleteObject attachments/7.png по HTTPS | ни одного | неявный запрет |
PutObject backups/2026-10-21.dump по HTTPS | Allow (шаблон /* покрывает backups/) | разрешено |
DeleteObject backups/2026-10-21.dump по HTTPS | Deny из DenyDeleteBackups | явный запрет |
Третья и пятая строки дают одинаковый результат по разным причинам, и разница существенна. Неявный запрет снимается тем, что кто-то добавит политику с Allow на удаление. Явный запрет не снимет никакая дополнительная политика — для этого нужно изменить или удалить само запрещающее утверждение. Четвёртая строка показывает типичную ошибку проектирования: шаблон ресурса шире, чем подразумевал автор, и роль может перезаписать резервную копию. Защитой здесь служит либо более узкий шаблон, либо Object Lock из темы 10.
Учётные записи для экстренного доступа
Принцип наименьших привилегий не означает, что учётных записей с полными правами не должно существовать. Кто-то должен иметь возможность восстановить доступ, если сломан провайдер единого входа, удалена ключевая политика или заблокированы все администраторы. Для этого заводят учётные записи экстренного доступа (англ. break-glass accounts, по аналогии с «разбейте стекло» у пожарной кнопки). Их отличает не уровень прав, а режим использования: их не применяют в повседневной работе; их немного (обычно две, чтобы потеря одной не лишала доступа); учётные данные хранятся раздельно и физически защищены (аппаратные ключи второго фактора в сейфе); любое их использование немедленно вызывает оповещение; процедуру входа периодически проверяют, чтобы в момент аварии она сработала.
В Kubernetes аналогом служит конфигурация с сертификатом группы system:masters. Эта группа обрабатывается авторизатором особо и получает все права, минуя RBAC, поэтому отозвать её удалением привязки нельзя — только отзывом сертификата, что на практике означает перевыпуск центра сертификации кластера. Начиная с версии 1.29 kubeadm разделяет повседневный admin.conf (группа kubeadm:cluster-admins, права через обычную привязку RBAC, которую можно удалить) и super-admin.conf (группа system:masters) — второй и есть учётная запись экстренного доступа, и хранить его на рабочей станции администратора не следует.
Идентичность нагрузок вместо статических ключей
Приложению в облаке тоже нужна идентичность: backend «Заметок» обращается к S3. Простейшее решение — создать пользователя IAM, выпустить ему ключ доступа и положить ключ в Secret. У этого решения три недостатка. Ключ бессрочен: если он утёк в лог, в образ или в публичный репозиторий, им можно пользоваться до тех пор, пока кто-то не заметит утечку. Ключ не привязан к месту использования: с ним работают с любого компьютера в мире. Ключ нужно вручную менять, а смена в нескольких местах одновременно — источник аварий, поэтому её откладывают.
Идентичность нагрузок (англ. workload identity) заменяет хранимый секрет выдачей короткоживущих учётных данных на основании того, чем является нагрузка. В Kubernetes основой служит токен ServiceAccount (подробно — в разделе 3): kubelet получает от apiserver подписанный JWT, привязанный к конкретному поду и действующий ограниченное время, и монтирует его в контейнер. Облачный провайдер настраивается доверять издателю этих токенов. В Amazon EKS механизм называется IAM Roles for Service Accounts (IRSA) 6: кластер публикует открытые ключи издателя по протоколу OIDC; в под монтируется токен с аудиторией sts.amazonaws.com; SDK приложения вызывает sts:AssumeRoleWithWebIdentity, предъявляя токен, и получает временные ключи роли. В политике доверия роли условие ограничивает, какая учётная запись какого пространства имён может её принять:
{
  "Effect": "Allow",
  "Principal": { "Federated": "arn:aws:iam::111122223333:oidc-provider/oidc.eks.eu-central-1.amazonaws.com/id/EXAMPLE" },
  "Action": "sts:AssumeRoleWithWebIdentity",
  "Condition": {
    "StringEquals": {
      "oidc.eks.eu-central-1.amazonaws.com/id/EXAMPLE:sub": "system:serviceaccount:notes:notes-backend",
      "oidc.eks.eu-central-1.amazonaws.com/id/EXAMPLE:aud": "sts.amazonaws.com"
    }
  }
}
В Google Kubernetes Engine та же идея реализована как Workload Identity Federation, в Azure — Microsoft Entra Workload ID; в EKS появился и альтернативный механизм EKS Pod Identity с агентом на узле. Детали отличаются, а выигрыш один: в кластере не хранится ни одного долговременного ключа облака. Украденный токен живёт час, работает только для одной роли и только до удаления пода.
Доступ к API Kubernetes
Конвейер запроса: аутентификация, авторизация, допуск
Каждое действие в кластере — от kubectl get pods до создания пода контроллером ReplicaSet — это HTTPS-запрос к kube-apiserver (тема 7). Прежде чем объект будет записан в etcd, запрос проходит цепочку стадий, и каждая может его отклонить 7. Схема на рисунке ниже показывает эту цепочку и коды ответа при отказе.
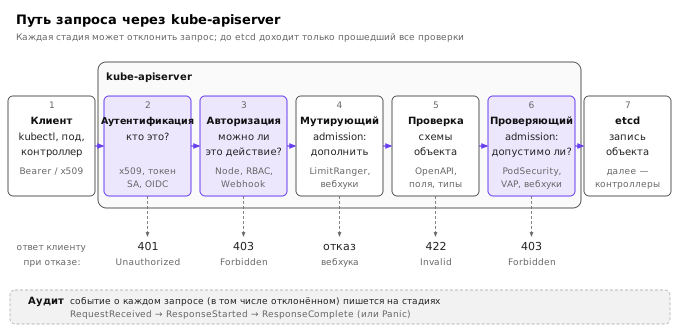
Аутентификация устанавливает имя пользователя и группы. Kubernetes не хранит объектов «пользователь»: имя берётся из клиентского сертификата (поле CN — имя, поля O — группы), из токена ServiceAccount, из токена OIDC внешнего провайдера или из ответа вебхука. Аутентификаторы опрашиваются по очереди, первый успешный определяет субъект. Если токен предъявлен, но недействителен, ответ — 401 Unauthorized. Если учётных данных нет вовсе, а анонимный доступ включён (так по умолчанию в кластерах kubeadm и minikube), запрос получает имя system:anonymous и идёт дальше — чтобы почти сразу получить отказ авторизации.
Авторизация решает, разрешено ли субъекту действие. Запрос описывается атрибутами: пользователь и группы, глагол (get, list, create, delete и т. д.), группа API, ресурс и подресурс, пространство имён, имя объекта. Авторизаторы — обычно Node (права kubelet на объекты своего узла) и RBAC, иногда вебхук — опрашиваются по очереди; достаточно одного разрешения. Если не разрешил никто, ответ — 403 Forbidden. Важное отличие от IAM облака: в стандартном RBAC нет запрещающих правил, только разрешающие, поэтому вопрос «что побеждает» не возникает.
Контроль допуска (англ. admission control) выполняется только для запросов, изменяющих объекты, и смотрит уже на содержимое объекта. Мутирующие контроллеры допуска дополняют объект: проставляют учётную запись по умолчанию, ограничения ресурсов, внедряют вспомогательные контейнеры. Затем объект проверяется на соответствие схеме. Проверяющие контроллеры допуска решают, допустим ли объект: здесь работают встроенный PodSecurity (раздел 4), политики ValidatingAdmissionPolicy на языке CEL и внешние вебхуки Kyverno или OPA Gatekeeper (раздел 6). Разделение ролей между стадиями стоит запомнить: RBAC отвечает на вопрос «может ли этот субъект создавать поды в этом пространстве имён», а контроль допуска — «допустим ли этот конкретный под».
ServiceAccount и его токены
ServiceAccount — объект Kubernetes, представляющий идентичность процессов в подах. У каждого пространства имён есть учётная запись default; под, в котором serviceAccountName не указан, работает от её имени. Полное имя субъекта для авторизации — system:serviceaccount:<пространство>:<имя>, а группы — system:serviceaccounts и system:serviceaccounts:<пространство>.
До версии 1.22 токен ServiceAccount был бессрочным JWT, хранившимся в Secret; кто однажды прочитал этот Secret, мог пользоваться токеном, пока Secret не удалят. Современный механизм — привязанные (англ. bound) токены, которые kubelet получает через API TokenRequest и монтирует в под как спроецированный том (англ. projected volume) 9. Такой токен имеет срок действия, аудиторию (для кого он выпущен) и привязку к объекту пода: после удаления пода apiserver перестаёт его принимать, даже если срок не истёк. Начиная с версии 1.24 секреты с бессрочными токенами автоматически не создаются. Kubelet обновляет спроецированный токен, когда тот прожил 80 % срока или больше 24 часов, а приложение должно перечитывать файл, а не кешировать токен навсегда.
Токен — обычный JWT из трёх частей в base64url, и его полезную нагрузку можно прочитать без ключа. Для учётной записи notes-viewer стенда ЛР 11 токен выпускается командой kubectl create token; ниже показана примерная структура его полей (значения идентификаторов сокращены):
kubectl -n lab11 create token notes-viewer --duration=10m | python3 scripts/jwt-claims.py
header: {"alg": "RS256", "kid": "..."}
{
  "aud": ["https://kubernetes.default.svc.cluster.local"],
  "exp": 1792000600,
  "iat": 1792000000,
  "iss": "https://kubernetes.default.svc.cluster.local",
  "kubernetes.io": {
    "namespace": "lab11",
    "serviceaccount": {"name": "notes-viewer", "uid": "..."}
  },
  "nbf": 1792000000,
  "sub": "system:serviceaccount:lab11:notes-viewer"
}
срок жизни: 600 с (0.17 ч), истекает ...
Поле sub — имя субъекта для RBAC, iss — издатель (его открытые ключи и проверяет облако при федерации), aud — аудитория: apiserver отвергнет токен, выпущенный для другой аудитории, например для sts.amazonaws.com. Разность exp − iat = 600 с — это срок жизни. У токена, смонтированного kubelet в под, в поле kubernetes.io дополнительно присутствует объект pod с именем и UID — это и есть привязка. По умолчанию kubelet запрашивает токен на 3607 секунд, но apiserver с включённым по умолчанию флагом --service-account-extend-token-expiration выдаёт его на больший срок ради совместимости со старыми клиентами, которые не перечитывают файл; поэтому в ЛР 11 срок проверяется на поде с явно заданным expirationSeconds.
Большинству подов токен API не нужен вовсе: backend «Заметок» обращается к PostgreSQL и S3, а не к Kubernetes. Поле automountServiceAccountToken: false в спецификации пода или в объекте ServiceAccount отключает монтирование, и захваченный под не сможет даже попробовать обратиться к apiserver от своего имени.
RBAC: Role, ClusterRole и привязки
Авторизатор RBAC (англ. Role-Based Access Control) работает с четырьмя типами объектов 8. Role — набор правил в пределах одного пространства имён; ClusterRole — набор правил без привязки к пространству имён, который может описывать и кластерные ресурсы (узлы, PersistentVolume, сами пространства имён). RoleBinding связывает субъекты с ролью внутри одного пространства имён, ClusterRoleBinding — во всём кластере. Схема на рисунке ниже показывает эти объекты.
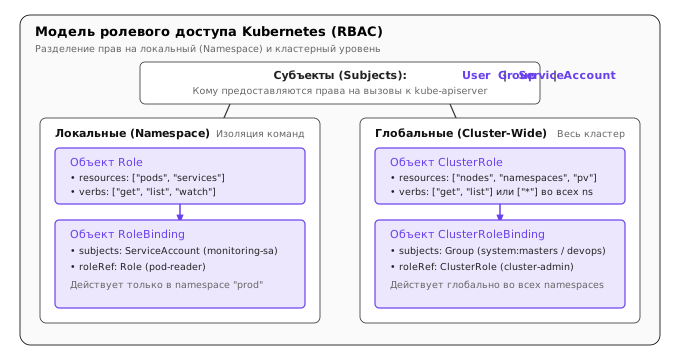
Правило роли состоит из групп API ("" — основная группа, где лежат pods, services, secrets; apps — Deployment и StatefulSet), ресурсов и подресурсов (pods/log, pods/exec), глаголов и, при необходимости, имён конкретных объектов (resourceNames). Роль стенда ЛР 11 разрешает только чтение подов и их журналов:
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: pod-reader
  namespace: lab11
rules:
  - apiGroups: [""]
    resources: ["pods", "pods/log"]
    verbs: ["get", "list", "watch"]
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: notes-viewer-pod-reader
  namespace: lab11
subjects:
  - kind: ServiceAccount
    name: notes-viewer
    namespace: lab11
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: pod-reader
Поле roleRef неизменяемо: чтобы привязать субъекта к другой роли, привязку удаляют и создают заново. Распространённый и полезный приём, который не виден на схеме, — RoleBinding, ссылающийся на ClusterRole: правила описываются один раз как ClusterRole, а действуют только в пространстве имён привязки. Так устроены встроенные роли view, edit и admin, которые выдают командам в их пространствах имён. Роль view намеренно не включает чтение Secret, edit — включает.
Проверять права нужно не чтением YAML, а вопросом к самому авторизатору. Команда kubectl auth can-i отправляет запрос SelfSubjectAccessReview — с флагом --as от имени олицетворяемого субъекта, — и apiserver отвечает, разрешил бы он действие:
kubectl auth can-i list pods -n lab11 --as=system:serviceaccount:lab11:notes-viewer
kubectl auth can-i list secrets -n lab11 --as=system:serviceaccount:lab11:notes-viewer
kubectl auth can-i list pods -n default --as=system:serviceaccount:lab11:notes-viewer
yes
no
no
Флаг --as сам по себе использует право олицетворения, о котором пойдёт речь ниже; у администратора кластера оно есть. Настоящий запрос с токеном учётной записи даёт тот же результат, но в виде HTTP-ответа: список подов с кодом 200 и для секретов — объект Status с кодом 403 и сообщением вида secrets is forbidden: User "system:serviceaccount:lab11:notes-viewer" cannot list resource "secrets" in API group "" in the namespace "lab11". Сообщение называет все атрибуты запроса, которые проверял авторизатор, и по нему удобно искать, какого правила не хватает.
Опасные права
Некоторые права в RBAC значат гораздо больше, чем подсказывает их название, потому что позволяют получить другие права 8. Документация Kubernetes выделяет их отдельно, и их полезно знать наизусть.
| Право | Почему опасно |
|---|---|
get/list/watch на secrets | list и watch возвращают объекты целиком, то есть содержимое всех секретов пространства имён, включая токены и пароли; различие «только list, без get» иллюзорно |
create на pods (и на Deployment, Job и т. п.) | можно создать под с любым ServiceAccount и любым Secret этого пространства имён и прочитать их изнутри — право косвенно даёт все права учётных записей пространства имён |
create на pods/exec, pods/attach | выполнение команд в чужом контейнере с его файлами, переменными окружения и токеном |
escalate на roles/clusterroles | позволяет создать или изменить роль, содержащую права, которых нет у самого субъекта |
bind на roles/clusterroles | позволяет создать привязку к роли с правами, которых нет у самого субъекта |
impersonate на users/groups/serviceaccounts | позволяет выполнять запросы от чужого имени, в том числе от группы system:masters |
доступ к nodes/proxy, create на serviceaccounts/token | прямое обращение к API kubelet на узле в обход контроля допуска или выпуск токенов за другие учётные записи |
любые права через * | автоматически включают и ресурсы, и глаголы, которые появятся в будущих версиях |
Без глаголов escalate и bind RBAC защищён от повышения привилегий: apiserver не даст создать роль или привязку, дающую больше, чем есть у создающего. Именно поэтому их выдача — по сути выдача всех прав. Практический вывод для приложений: учётной записи backend не нужны права на API вовсе, учётной записи CI достаточно edit в одном пространстве имён, а Prometheus из темы 12 получает ClusterRole только с get, list, watch на поды, сервисы и EndpointSlice.
Изоляция пода: Pod Security Standards и securityContext
Почему root в контейнере опасен
В теме 3 было показано, что контейнер — обычный процесс Linux в отдельных пространствах имён и группах cgroups, работающий на общем ядре узла. Пространство имён пользователей Kubernetes по умолчанию не включает, поэтому UID 0 внутри контейнера — тот же UID 0, что и на узле. От полного root его отделяют три механизма. Возможности (англ. capabilities) делят привилегии суперпользователя на около сорока частей; среда выполнения по умолчанию оставляет контейнеру лишь часть из них (у Docker — 14, среди них CHOWN, DAC_OVERRIDE, SETUID, SETGID, NET_RAW, NET_BIND_SERVICE, KILL). Фильтр системных вызовов seccomp запрещает опасные вызовы ядра. Модули LSM (AppArmor, SELinux) ограничивают доступ к файлам и операциям 3.
Каждый из этих механизмов можно ослабить в манифесте одной строкой, и тогда граница исчезает. Под с privileged: true получает все возможности и доступ к устройствам узла; с hostPID: true видит все процессы узла; с томом hostPath: / может прочитать и изменить файловую систему узла, включая учётные данные kubelet. Но и без этих крайностей root в контейнере увеличивает последствия ошибки: уязвимость ядра, достижимая только из-под UID 0 или требующая конкретной возможности, становится доступной; DAC_OVERRIDE позволяет игнорировать права файлов на смонтированных томах; NET_RAW позволяет формировать произвольные пакеты в сети узла. Процесс веб-сервера, работающий от непривилегированного UID без возможностей, при захвате даёт злоумышленнику существенно меньше.
Три профиля Pod Security Standards
Pod Security Standards — три профиля, которые определяют, какие поля спецификации пода допустимы 10. Они описывают политику, а реализует её встроенный контроллер допуска Pod Security Admission, ставший стабильным в версии 1.25 и заменивший удалённый в той же версии PodSecurityPolicy.
| Профиль | Назначение | Что запрещает (основное) |
|---|---|---|
privileged | системные компоненты: CNI, драйверы CSI, агенты мониторинга узла | ничего |
baseline | большинство приложений без переделки | privileged, hostNetwork/hostPID/hostIPC, hostPath, hostPort, добавление возможностей сверх стандартного набора, отключение seccomp и AppArmor, небезопасные sysctl |
restricted | приложения, написанные с учётом безопасности | всё из baseline, а также требует runAsNonRoot: true, allowPrivilegeEscalation: false, capabilities.drop со значением ALL (добавить можно только NET_BIND_SERVICE), seccomp RuntimeDefault или Localhost; ограничивает типы томов (configMap, secret, emptyDir, projected, PVC, CSI, downwardAPI, ephemeral) |
Профиль включается метками пространства имён. Каждая метка задаёт режим и уровень: enforce — под, нарушающий профиль, отклоняется; warn — запрос выполняется, но клиент получает предупреждение; audit — нарушение записывается в аудит. Дополнительные метки ...-version фиксируют версию правил, чтобы обновление кластера не ужесточило профиль внезапно.
apiVersion: v1
kind: Namespace
metadata:
  name: lab11-web
  labels:
    pod-security.kubernetes.io/enforce: restricted
    pod-security.kubernetes.io/enforce-version: latest
    pod-security.kubernetes.io/warn: restricted
    pod-security.kubernetes.io/warn-version: latest
Режимы различаются не только реакцией, но и объектами. enforce применяется только к подам. warn и audit применяются ещё и к объектам с шаблоном пода — Deployment, StatefulSet, Job. Отсюда характерная ловушка: если включён только enforce, Deployment с нарушающим шаблоном создаётся без единого сообщения, а поды не появляются; причина видна лишь в событиях ReplicaSet (FailedCreate ... violates PodSecurity "restricted:latest"). Поэтому enforce почти всегда дополняют warn того же уровня. Перед включением на существующем пространстве имён полезна проверка kubectl label --dry-run=server --overwrite ns <имя> pod-security.kubernetes.io/enforce=restricted: apiserver перечислит уже работающие поды, которые нарушают профиль, ничего не меняя.
Поля securityContext
Профиль только проверяет; соответствовать ему должен сам манифест. Безопасные значения задаются в securityContext — на уровне пода (действуют на все контейнеры) и на уровне контейнера (переопределяют значения пода для этого контейнера). Ниже — frontend «Заметок» на nginx, приведённый к профилю restricted; это тот же манифест, что в ЛР 11.
apiVersion: v1
kind: Pod
metadata:
  name: web
  namespace: lab11-web
spec:
  automountServiceAccountToken: false
  securityContext:                     # уровень пода
    runAsNonRoot: true
    runAsUser: 101
    runAsGroup: 101
    seccompProfile:
      type: RuntimeDefault
  containers:
    - name: nginx
      image: nginxinc/nginx-unprivileged:1.31.7-alpine3.24
      ports:
        - containerPort: 8080
      securityContext:                 # уровень контейнера
        allowPrivilegeEscalation: false
        readOnlyRootFilesystem: true
        capabilities:
          drop: ["ALL"]
      volumeMounts:
        - name: tmp
          mountPath: /tmp
  volumes:
    - name: tmp
      emptyDir:
        sizeLimit: 16Mi
Разберём поля по одному.
runAsNonRoot: true — требование, а не действие: kubelet перед запуском контейнера проверяет, что процесс не будет работать от UID 0, и отказывается запускать его, если это не так. Проверка опирается на runAsUser, а если он не задан — на инструкцию USER образа (тема 4). Здесь кроется частая ошибка: если в Dockerfile написано USER node или USER app — имя, а не число, — kubelet не может узнать UID, не заглянув в /etc/passwd образа, и под не запускается со статусом CreateContainerConfigError и сообщением container has runAsNonRoot and image has non-numeric user (node), cannot verify user is non-root. Исправлений два: указывать в Dockerfile числовой UID (USER 10001 или USER 10001:10001) или задавать runAsUser в манифесте. Образ nginxinc/nginx-unprivileged уже содержит USER 101, а в манифесте UID продублирован явно. Обычный образ nginx инструкции USER не имеет, работает от root и слушает порт 80 — поэтому для профиля restricted выбран вариант образа, рассчитанный на непривилегированный запуск и слушающий порт 8080.
readOnlyRootFilesystem: true монтирует корневую файловую систему контейнера — верхний слой overlay2 из темы 3 — только для чтения. Злоумышленник, получивший выполнение кода, не сможет подменить файлы приложения или записать и запустить свой исполняемый файл. Но приложению обычно нужно куда-то писать: nginx-unprivileged кладёт в /tmp pid-файл и временные файлы прокси. Для таких каталогов монтируется emptyDir — временный том, живущий столько же, сколько под; sizeLimit ограничивает его размер, а при medium: Memory он размещается в памяти и учитывается в лимите памяти контейнера.
capabilities.drop: ALL удаляет все возможности, включая стандартный набор среды выполнения. Веб-серверу на порту выше 1024 ни одна из них не нужна. Если процесс всё же должен слушать порт 80 без root, в список capabilities.add добавляют ровно одну — NET_BIND_SERVICE.
allowPrivilegeEscalation: false устанавливает процессу флаг ядра no_new_privs: после этого ни запуск setuid-программ (su, sudo, ping в старых дистрибутивах), ни файловые возможности не могут дать процессу больше прав, чем у родителя. Для контейнеров с privileged: true или с возможностью CAP_SYS_ADMIN повышение привилегий всегда считается разрешённым — им повышать уже нечего.
seccompProfile.type: RuntimeDefault включает профиль seccomp среды выполнения (containerd, CRI-O), который запрещает системные вызовы, редко нужные приложениям и часто встречающиеся в эксплойтах: загрузку модулей ядра, kexec_load, reboot, часть операций с ключами ядра и т. п. Существенная деталь: в Kubernetes без явного указания контейнеры работают без seccomp (Unconfined), в отличие от Docker, где профиль по умолчанию включён. Kubelet можно настроить флагом --seccomp-default использовать RuntimeDefault для всех подов, но по умолчанию он выключен.
Последнее поле — automountServiceAccountToken: false — не входит в securityContext и не требуется профилем, но относится к той же задаче: не давать поду то, что ему не нужно.
Сетевая изоляция: NetworkPolicy
Модель: изолированные поды и аддитивные правила
Сетевая модель Kubernetes (тема 7) требует, чтобы любой под мог связаться с любым другим подом без NAT. Это упрощает построение приложений и одновременно означает, что захваченный frontend «Заметок» может напрямую подключиться к PostgreSQL на порт 5432, обойдя backend со всей его проверкой прав. NetworkPolicy — объект, ограничивающий, какие соединения разрешены на уровне IP-адресов и портов (уровни 3 и 4) 11.
Модель NetworkPolicy строится на понятии изоляции. Под, который не выбран ни одной политикой, не изолирован: ему разрешено всё входящее и исходящее. Как только хотя бы одна политика выбирает под полем podSelector и содержит в policyTypes значение Ingress, под становится изолированным для входящих соединений: теперь к нему допускается только то, что явно разрешено правилами ingress хотя бы одной из выбирающих его политик. То же независимо для Egress. Политики только разрешают, запрещающих правил в стандартном API нет. Поэтому политики аддитивны: итоговое множество разрешённых соединений — объединение правил всех политик, выбирающих под, и порядок применения политик не важен.
Из модели следуют два свойства, которые часто упускают. Первое: соединение проходит, только если его разрешают обе стороны — egress-политики пода-источника и ingress-политики пода-назначения. Второе: правила относятся к установлению соединения; ответные пакеты уже разрешённого соединения пропускаются автоматически, отдельное правило для них не нужно.
Важнее всех деталей синтаксиса одно условие: NetworkPolicy реализует сетевой плагин CNI, а не apiserver. Apiserver примет и сохранит объект при любом CNI. Если плагин политики не поддерживает, объект просто ничего не делает: трафик идёт, как шёл, и никаких ошибок нет. Документация Kubernetes прямо предупреждает, что политика без реализующего её контроллера не действует 11; документация minikube уточняет, что сетевой плагин minikube по умолчанию политики не реализует и кластер для работы с ними создают с флагом --cni=calico. Calico и Cilium поддерживают политики, Flannel — нет. Поэтому любую политику проверяют попыткой соединения, которое она должна запретить, а не наличием объекта в kubectl get networkpolicy.
default-deny и разрешающие политики
Надёжная схема начинается с запрета всего и добавления узких разрешений: политика по умолчанию «запретить» (англ. default-deny). Пустой podSelector: {} выбирает все поды пространства имён, а отсутствие правил ingress при значении Ingress в policyTypes ничего не разрешает:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
  namespace: lab11
spec:
  podSelector: {}
  policyTypes: ["Ingress"]
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: db-allow-from-backend
  namespace: lab11
spec:
  podSelector:
    matchLabels:
      app: db
  policyTypes: ["Ingress"]
  ingress:
    - from:
        - podSelector:
            matchLabels:
              app: backend
      ports:
        - protocol: TCP
          port: 5432
Первая политика изолирует все поды для входящих соединений — изнутри кластера и снаружи. Вторая добавляет одно разрешение: к подам app=db на 5432/TCP от подов app=backend того же пространства имён. Рисунок ниже показывает стенд ЛР 11 до появления политик и после полного набора: default-deny в обе стороны и явные разрешения.
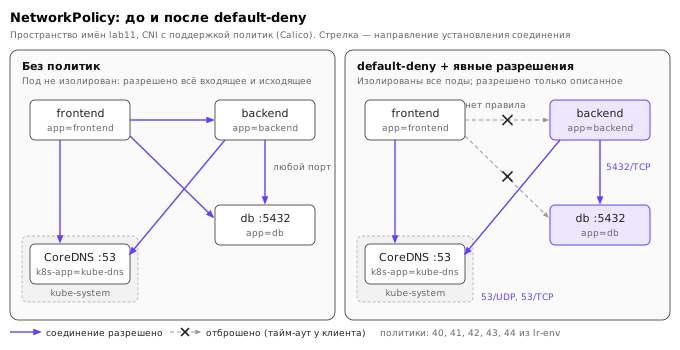
Заметим, что порт в правиле — порт пода (containerPort), а не порт Service. Политики вообще формулируются в терминах подов, а не сервисов: в распространённых реализациях соединение с ClusterIP сначала транслируется kube-proxy в адрес конкретного пода, и уже этот адрес сопоставляется с правилами. Отброшенное соединение выглядит у клиента как тайм-аут, а не как отказ: Calico и большинство других плагинов молча отбрасывают пакеты, и pg_isready или curl ждут до истечения своего тайм-аута.
Исходящий трафик и ловушка DNS
Ограничение входящего трафика защищает базу от frontend, но не мешает захваченному поду устанавливать соединения наружу: выгружать данные, скачивать инструменты, подключаться к серверу управления. Для этого нужна изоляция исходящего трафика. Её включают так же — политикой default-deny со значением Egress в policyTypes — и именно на этом шаге чаще всего ломают работающее приложение.
Причина — DNS. Backend обращается к базе по имени db, и первым делом его библиотека отправляет запрос к CoreDNS (тема 7) — исходящее соединение на порт 53 пода в пространстве имён kube-system. После default-deny egress этот запрос отбрасывается, имя не разрешается, и приложение сообщает об ошибке подключения к базе, хотя правило «backend → db» на месте. Разрешение DNS выписывают отдельно, для всех подов пространства имён:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns-egress
  namespace: lab11
spec:
  podSelector: {}
  policyTypes: ["Egress"]
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
          podSelector:
            matchLabels:
              k8s-app: kube-dns
      ports:
        - protocol: UDP
          port: 53
        - protocol: TCP
          port: 53
TCP указан не для полноты: DNS переходит на TCP, когда ответ не помещается в UDP-датаграмму, и разрешение только UDP даёт редкие, плохо воспроизводимые сбои. Метку kubernetes.io/metadata.name apiserver автоматически ставит каждому пространству имён начиная с версии 1.22, поэтому по ней удобно выбирать пространство имён. Метка k8s-app: kube-dns у подов CoreDNS — соглашение kubeadm и minikube; в управляемых кластерах её стоит проверить командой kubectl -n kube-system get pods --show-labels. После разрешения DNS остаётся добавить egress-сторону основного разрешения: backend → поды app=db на 5432/TCP.
Селекторы: «и» против «или»
Элемент списка from или to может содержать podSelector, namespaceSelector и ipBlock. Тонкость в YAML: два селектора в одном элементе списка объединяются по «и», два отдельных элемента — по «или». Сравним:
# Один элемент: поды k8s-app=kube-dns В пространстве имён kube-system
- to:
    - namespaceSelector: {matchLabels: {kubernetes.io/metadata.name: kube-system}}
      podSelector: {matchLabels: {k8s-app: kube-dns}}

# Два элемента: ЛЮБОЙ под в kube-system ИЛИ поды k8s-app=kube-dns в своём пространстве имён
- to:
    - namespaceSelector: {matchLabels: {kubernetes.io/metadata.name: kube-system}}
    - podSelector: {matchLabels: {k8s-app: kube-dns}}
Разница — один дефис, а смысл противоположный: вторая форма разрешает соединения со всеми подами kube-system. Отдельно стоит запомнить, что podSelector без namespaceSelector выбирает поды только в пространстве имён самой политики. Политика «разрешить DNS» с одним podSelector: {k8s-app: kube-dns} ничего не разрешает, потому что в lab11 подов CoreDNS нет; в ЛР 11 эта ошибка разбирается как задание «найдите ошибку».
Элемент ipBlock задаёт диапазон адресов в нотации CIDR с исключениями except и применяется для адресов вне кластера: внешней базы данных, API провайдера. Для подов он ненадёжен, так как их адреса меняются. У стандартного NetworkPolicy есть и ограничения: нет запрещающих правил и приоритетов, нельзя сослаться на доменное имя, нельзя описать политику для всего кластера сразу. Эти задачи решают расширения конкретных плагинов (GlobalNetworkPolicy в Calico, CiliumNetworkPolicy с правилами по DNS-именам и уровню 7) и разрабатываемый SIG Network API AdminNetworkPolicy.
Цепочка поставок, аудит и типичные ошибки
Сканирование образов и конфигураций
Образ «Заметок» содержит не только код приложения, но и базовый дистрибутив с сотнями пакетов: libc, OpenSSL, интерпретатор, утилиты. Каждый из них может содержать известные уязвимости, зарегистрированные в каталоге CVE (англ. Common Vulnerabilities and Exposures). Сканер уязвимостей определяет по метаданным образа список пакетов и их версии и сопоставляет его с базой уязвимостей 2. Trivy — сканер с открытым кодом, который проверяет образы, файловые системы и репозитории, а также конфигурации: Dockerfile, манифесты Kubernetes, код OpenTofu 13. В теме 4 он упоминался кратко; здесь важно понять, что именно означают его числа.
Ниже — результаты сканирования четырёх образов Python, каждый из которых отличается от предыдущего одним свойством. Сканирование выполнено 22.10.2026 программой Trivy 0.70.0 с базой уязвимостей от 21.10.2026; в таблице — уязвимости пакетов ОС.
| Образ | Основа | Что изменено | CRITICAL | HIGH | Всего | С исправлением |
|---|---|---|---|---|---|---|
python:3.8-slim | Debian 12.7 | — | 9 | 116 | 505 | 217 |
python:3.12-slim | Debian 13.7 | версия Python и, вместе с ней, Debian | 0 | 44 | 164 | 0 |
python:3.12-alpine | Alpine 3.24.2 | дистрибутив | 0 | 0 | 1 | 1 |
gcr.io/distroless/python3-debian13:nonroot | Debian 13.7 | состав пакетов: без оболочки и менеджера пакетов | 0 | 26 | 162 | 0 |
Таблица учит нескольким вещам. Python 3.8 вышел из поддержки в 2024 году, и образ 3.8-slim больше не пересобирается: он застыл на Debian 12.7 и накапливает уязвимости, для 217 из которых исправленные пакеты давно есть. Переход на 3.12-slim убирает все критические уязвимости, но меняет две переменные сразу — версию Python и версию Debian, — что видно из колонки «Основа»; приписывать выигрыш одному из факторов по этим данным нельзя. Все 44 HIGH в 3.12-slim имеют статус affected без исправленной версии: Debian ещё не выпустил исправлений, и обновление пакетов внутри образа ничего не даст. Флаг --ignore-unfixed скрыл бы их все, поэтому решение о нём — осознанная политика, а не способ «почистить отчёт». Alpine показывает почти ноль, но отчасти потому, что база безопасности Alpine (secdb) содержит только уязвимости, для которых уже выпущено исправление: неисправленные уязвимости в отчёте по Alpine не видны в принципе, и строки таблицы не вполне сравнимы. Меньшее число в отчёте не тождественно меньшему числу уязвимостей в природе. Наконец, distroless на той же Debian 13.7 даёт меньше, чем slim, за счёт меньшего числа пакетов — это и есть уменьшение поверхности атаки, измеренное при одной изменённой переменной.
Числа в таблице устареют через несколько дней: база уязвимостей обновляется ежедневно, а образы с плавающими тегами (3.12-slim) пересобираются. Поэтому любые выводы о «безопасности образа» сопровождают датой, версией сканера и версией базы. По той же причине образ, прошедший проверку при сборке, сканируют повторно в реестре и в работающем кластере.
Второй режим — проверка конфигураций. trivy config не запускает ничего, а проверяет файлы набором правил. Для намеренно плохого Dockerfile из ЛР 11 (основа python:3.8-slim, нет USER, apt-get install без --no-install-recommends) отчёт выглядит так:
trivy config --quiet image/Dockerfile.bad
Dockerfile.bad (dockerfile)
===========================
Tests: 27 (SUCCESSES: 24, FAILURES: 3)
Failures: 3 (UNKNOWN: 0, LOW: 1, MEDIUM: 0, HIGH: 2, CRITICAL: 0)

DS-0002 (HIGH): Specify at least 1 USER command in Dockerfile with non-root user as argument
DS-0026 (LOW): Add HEALTHCHECK instruction in your Dockerfile
DS-0029 (HIGH): '--no-install-recommends' flag is missed: 'apt-get update && apt-get install -y curl'
...
Для манифестов правила семейства KSV проверяют то же, что Pod Security Standards, и ещё кое-что сверх них: обычный под nginx из ЛР 11 даёт 17 замечаний, приведённый к restricted — четыре, и все они — рекомендации, которых профиль не требует (UID не больше 10000, не задан лимит CPU, образ не из доверенного реестра). Это полезное напоминание: у сканера свой набор мнений, и «ноль замечаний» не равно «соответствует профилю», и наоборот.
В конвейере CI сканер становится воротами (англ. gate) через код выхода: trivy image --exit-code 1 --severity CRITICAL,HIGH <образ> завершается с кодом 1, если найдено хотя бы одно совпадение, и шаг сборки падает. На практике к этому добавляют --ignore-unfixed и файл .trivyignore с явными исключениями — иначе ворота закроются навсегда из-за уязвимостей, которые никто не может исправить.
SBOM, подпись образов и политики допуска
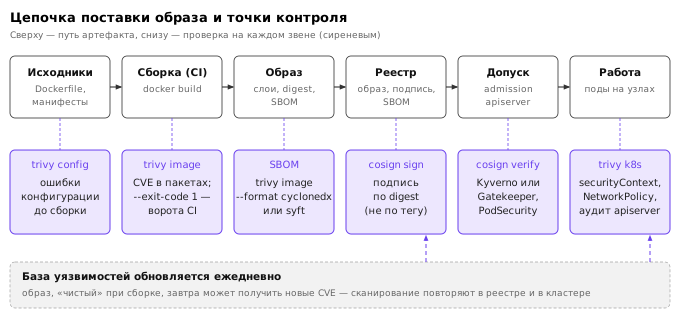
Список компонентов программного обеспечения (англ. Software Bill of Materials, SBOM) — машиночитаемая опись того, из чего собран образ: пакеты, версии, лицензии, хеши. Её формируют при сборке (trivy image --format cyclonedx --output sbom.cdx.json <образ> или syft <образ> -o spdx-json) в форматах CycloneDX или SPDX и хранят рядом с образом. Ценность SBOM проявляется, когда публикуют новую уязвимость: вместо повторного скачивания и разбора всех образов достаточно поискать уязвимый пакет в описях (trivy sbom sbom.cdx.json).
Сканирование отвечает на вопрос «что внутри», но не на вопрос «откуда это взялось». Образ в реестре можно подменить, если украдены учётные данные реестра; тег notes-backend:1.4 можно перезаписать другим содержимым. Защиту дают два механизма. Первый — ссылка на образ по digest (тема 4): registry.example.com/notes/backend@sha256:... неизменна по определению. Второй — криптографическая подпись. Cosign из проекта Sigstore подписывает digest образа и кладёт подпись в тот же реестр 14. Подписывать можно ключевой парой (cosign sign --key cosign.key <образ>@sha256:...) или без долговременного ключа: в режиме keyless сборочный конвейер аутентифицируется по OIDC, удостоверяющий центр Fulcio выдаёт сертификат на несколько минут, а факт подписи записывается в публичный журнал прозрачности Rekor. Проверка выполняется командой cosign verify с указанием ожидаемого ключа или ожидаемой идентичности подписавшего. Так, например, проект Kubernetes подписывает свои образы, и их подлинность проверяется по идентичности сборочной учётной записи проекта.
Чтобы подписи и правила сканирования что-то значили, их нужно проверять в момент допуска пода, а не на рабочей станции. Это задача проверяющих контроллеров допуска из раздела 3. Встроенный механизм ValidatingAdmissionPolicy (стабилен с версии 1.30) позволяет описать проверку на языке выражений CEL без внешних компонентов. Например, следующая пара объектов запрещает в пространстве имён notes поды, у которых образ указан не по digest:
apiVersion: admissionregistration.k8s.io/v1
kind: ValidatingAdmissionPolicy
metadata:
  name: images-by-digest
spec:
  failurePolicy: Fail
  matchConstraints:
    resourceRules:
      - apiGroups: [""]
        apiVersions: ["v1"]
        operations: ["CREATE", "UPDATE"]
        resources: ["pods"]
  validations:
    - expression: "object.spec.containers.all(c, c.image.contains('@sha256:'))"
      message: "образ должен быть указан по digest"
---
apiVersion: admissionregistration.k8s.io/v1
kind: ValidatingAdmissionPolicyBinding
metadata:
  name: images-by-digest
spec:
  policyName: images-by-digest
  validationActions: ["Deny"]
  matchResources:
    namespaceSelector:
      matchLabels:
        kubernetes.io/metadata.name: notes
Проверку подписи CEL выполнить не может — для неё нужен доступ к реестру и криптография. Её выполняют внешние контроллеры допуска, подключаемые вебхуком: Kyverno (политики в виде YAML, правило verifyImages проверяет подписи cosign и аттестации) и OPA Gatekeeper (политики на языке Rego, проверка подписей через внешние поставщики данных). Рисунок ниже собирает цепочку поставки целиком: на каждом звене — свой механизм контроля.
Аудит kube-apiserver
Аудит отвечает на вопрос, который возникает после инцидента: кто, когда и что сделал. Kube-apiserver может записывать событие о каждом запросе в журнал аудита 12. Что записывать, задаёт политика аудита — список правил, из которых для каждого запроса применяется первое подходящее. Уровень правила определяет подробность: None — не записывать, Metadata — только метаданные (кто, что, над каким объектом, код ответа), Request — плюс тело запроса, RequestResponse — плюс тело ответа. Событие может записываться на нескольких стадиях: RequestReceived, ResponseStarted (для долгих запросов вроде watch), ResponseComplete, Panic.
apiVersion: audit.k8s.io/v1
kind: Policy
omitStages: ["RequestReceived"]
rules:
  # Секреты и ConfigMap — только метаданные: тела содержат пароли
  - level: Metadata
    resources:
      - group: ""
        resources: ["secrets", "configmaps", "serviceaccounts/token"]
  # Выполнение команд в контейнерах и изменения RBAC — подробно
  - level: RequestResponse
    resources:
      - group: ""
        resources: ["pods/exec", "pods/attach"]
      - group: "rbac.authorization.k8s.io"
  # Шумные запросы чтения от системных компонентов — не записывать
  - level: None
    users: ["system:kube-proxy"]
    verbs: ["watch"]
  # Всё остальное — метаданные
  - level: Metadata
Порядок правил существенен: секреты стоят первыми, иначе их содержимое попало бы в журнал по более подробному правилу и журнал аудита сам стал бы хранилищем паролей. Политика подключается флагом --audit-policy-file, журнал — --audit-log-path (с ротацией --audit-log-maxage, --audit-log-maxbackup, --audit-log-maxsize) или вебхуком во внешнюю систему. В управляемых кластерах журнал аудита включается настройкой провайдера и попадает в его службу журналов. Каждое событие — JSON-объект с полями user (имя и группы), verb, objectRef (ресурс, пространство имён, имя), sourceIPs, userAgent, responseStatus.code и аннотацией authorization.k8s.io/reason — какое правило RBAC разрешило запрос. По этим полям ищут, например, все обращения к секретам от учётных записей приложений или все pods/exec за ночь.
Ограничения и типичные ошибки интерпретации
Первая и самая распространённая ошибка — считать политику действующей по факту её существования. NetworkPolicy при CNI без поддержки политик, метка PSS в режиме warn вместо enforce, политика допуска в режиме аудита, сканер, отчёт которого никто не читает, — всё это объекты, которые есть, но ничего не запрещают. Любую защитную меру проверяют негативным тестом: попыткой сделать то, что она должна запретить.
Вторая — смешение аутентификации и авторизации. Код 401 означает, что apiserver не поверил учётным данным; код 403 — что поверил, но правила не разрешают действие. Добавление роли не исправит 401, а перевыпуск токена не исправит 403.
Третья — неверное чтение RBAC. В нём нет запрещающих правил, поэтому «отнять» право у субъекта можно только удалив разрешающую привязку; права через группы (system:authenticated, system:serviceaccounts) получают все её члены, и их легко не заметить при чтении одной RoleBinding. Права на list secrets равносильны чтению всех секретов, а право создавать поды — правам всех учётных записей пространства имён.
Четвёртая — ожидание, что runAsNonRoot что-то меняет в образе. Поле только проверяет UID и не делает root непривилегированным; если образ рассчитан на root, под просто не запустится. Нечисловой USER не проходит проверку вовсе. Связанное заблуждение — проверять «не root ли под» по одному полю: runAsUser может быть задан на уровне пода, на уровне контейнера или не задан нигде, и тогда действует USER образа; полный ответ даёт только kubelet при запуске или сканер, видящий и манифест, и образ.
Пятая — неверная интерпретация отчётов сканера. Число CVE — не мера риска: уязвимость в пакете, который никогда не загружается процессом приложения, не эквивалентна уязвимости в OpenSSL сетевого сервиса; уязвимость без исправленной версии нельзя закрыть обновлением; сравнение двух образов имеет смысл, только если они отличаются одной переменной и сняты одной версией базы в один день. Отсутствие найденных уязвимостей не означает их отсутствия — сканер знает только о зарегистрированных и только о пакетах, которые смог распознать.
Шестая — ожидание, что NetworkPolicy защищает данные. Политика решает, может ли соединение начаться, но не шифрует и не аутентифицирует трафик: разрешённый под backend может передать базе что угодно, а трафик идёт открытым текстом. Шифрование и взаимная аутентификация между сервисами — задача TLS и сервисных сеток, которые в курсе не рассматриваются.
Итоги темы
Безопасность облачного приложения строится от модели угроз: сначала определяется, что ценно и какими путями до этого можно добраться, затем каждый путь закрывается своим механизмом. Модель разделения ответственности оставляет клиенту при любой сервисной модели учётные записи, права и данные, и именно в этой зоне происходит большинство инцидентов. Поэтому центральная тема — управление доступом: в облаке это политики IAM с правилом «явный запрет побеждает» и условиями, в Kubernetes — цепочка аутентификации, авторизации RBAC и контроля допуска.
Второй сквозной сюжет — замена долговременных секретов короткоживущими учётными данными, выдаваемыми на основании идентичности. Привязанные токены ServiceAccount живут ограниченное время и умирают вместе с подом; федерация этих токенов с IAM облака (IRSA, Workload Identity) позволяет обходиться в кластере без единого ключа облака. Учётные записи с полными правами при этом не исчезают, а переходят в режим экстренного доступа с отдельным хранением и оповещением при использовании.
Изоляция в кластере выполняется на двух уровнях. На уровне процесса Pod Security Standards задают профиль, а securityContext реализует его: запуск от числового непривилегированного UID, корневая файловая система только для чтения с emptyDir для записи, удаление всех возможностей, запрет повышения привилегий, профиль seccomp. На уровне сети NetworkPolicy начинают с default-deny и добавляют узкие разрешения с обеих сторон соединения, не забывая о DNS; работает всё это только при сетевом плагине с поддержкой политик.
Цепочка поставок защищается контролем на каждом звене: проверка конфигураций до сборки, сканирование образа как ворота CI, SBOM, подпись по digest и проверка подписи при допуске, повторное сканирование в работе. Числа сканера сопровождаются датой и версией базы и сравниваются при одной изменённой переменной. Аудит apiserver замыкает картину, позволяя восстановить действия после инцидента. Следующая тема — наблюдаемость — продолжает эту линию: метрики, журналы и трассы показывают не только сбои, но и аномалии, и сам Prometheus будет обращаться к API кластера от имени ServiceAccount с минимальной ролью RBAC, построенной по правилам этой темы.
Литература
- Rose S., Borchert O., Mitchell S., Connelly S. Zero Trust Architecture. — NIST SP 800-207, 2020. https://doi.org/10.6028/NIST.SP.800-207
- Souppaya M., Morello J., Scarfone K. Application Container Security Guide. — NIST SP 800-190, 2017. https://doi.org/10.6028/NIST.SP.800-190
- Rice L. Container Security: Fundamental Technology Concepts that Protect Containerized Applications. — O'Reilly Media, 2020.
- Amazon Web Services. Shared Responsibility Model. — https://aws.amazon.com/compliance/shared-responsibility-model/ (дата обращения: 22.10.2026).
- AWS Identity and Access Management User Guide. Policy evaluation logic. — https://docs.aws.amazon.com/IAM/latest/UserGuide/reference_policies_evaluation-logic.html (дата обращения: 22.10.2026).
- Amazon EKS User Guide. IAM roles for service accounts. — https://docs.aws.amazon.com/eks/latest/userguide/iam-roles-for-service-accounts.html (дата обращения: 22.10.2026).
- Kubernetes Documentation. Controlling Access to the Kubernetes API. — https://kubernetes.io/docs/concepts/security/controlling-access/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Using RBAC Authorization. — https://kubernetes.io/docs/reference/access-authn-authz/rbac/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Service Accounts. — https://kubernetes.io/docs/concepts/security/service-accounts/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Pod Security Standards. — https://kubernetes.io/docs/concepts/security/pod-security-standards/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Network Policies. — https://kubernetes.io/docs/concepts/services-networking/network-policies/ (дата обращения: 22.10.2026).
- Kubernetes Documentation. Auditing. — https://kubernetes.io/docs/tasks/debug/debug-cluster/audit/ (дата обращения: 22.10.2026).
- Trivy Documentation. — https://trivy.dev/docs/ (дата обращения: 22.10.2026).
- Sigstore Documentation. Cosign: Signing Overview. — https://docs.sigstore.dev/cosign/signing/overview/ (дата обращения: 22.10.2026).