
Наблюдаемость в облаке: метрики, логи и трассировка
В предыдущих темах система была построена: приложение упаковано в образ (тема 4), запущено с ограничениями и проверкой здоровья (тема 5), развёрнуто в Kubernetes с пробами, автомасштабированием и сервисами (тема 7), получило хранилище (темы 8 и 10), инфраструктуру как код (тема 9) и защиту (тема 11). Kubernetes умеет перезапустить контейнер, у которого не отвечает проба живости, и добавить реплики, когда растёт загрузка CPU. Однако ни один из этих механизмов не отвечает на вопросы, которые возникают в эксплуатации: работает ли сервис для пользователей, а не только для пробы /api/health; почему пятая часть запросов к списку заметок отвечает за две секунды; какой из трёх компонентов приложения «Заметки» виноват в ошибке, которую видит пользователь; нужно ли будить дежурного инженера прямо сейчас или проблема подождёт до утра.
Эти вопросы решает наблюдаемость — способность по данным, которые система отдаёт наружу, понять её внутреннее состояние, в том числе в ситуации, которую никто не предвидел. Данные бывают трёх основных видов: числовые метрики, журналы событий и распределённые трассы запросов. Каждый вид отвечает на свой вопрос и стоит своих денег, и инженерное мастерство состоит в том, чтобы выбрать, что и в каком виде собирать, как это хранить и как превращать в решения — в график, в уведомление, в план исправления.
Изложение построено так. Первый раздел разграничивает мониторинг и наблюдаемость и вводит методики выбора сигналов. Второй посвящён модели данных Prometheus, формату экспозиции, инструментированию сервиса на Python и сбору метрик по модели опроса. Третий разбирает язык PromQL: скорости счётчиков, оценку квантилей по гистограмме и кардинальность. Четвёртый вводит цели уровня обслуживания, бюджет ошибок и алерты по скорости его сжигания, а также Alertmanager. Пятый рассматривает журналы в Loki, трассировку в OpenTelemetry и связывание трёх сигналов. Шестой собирает ограничения и типичные ошибки интерпретации. Числовые примеры получены на учебном сервисе notes-api из лабораторной работы 12 — аналоге backend приложения «Заметки».
От мониторинга к наблюдаемости
Мониторинг и наблюдаемость: известные и неизвестные отказы
Мониторинг (англ. monitoring) — сбор заранее выбранных показателей и проверка их по заранее заданным правилам: заполнен ли диск более чем на 90 %, отвечает ли сервис на порту 8000, превышает ли доля ошибок 5 %. Мониторинг хорошо отвечает на вопросы, которые инженер умел задать заранее, то есть на известные виды отказов. Классическая система мониторинга отображает панель «зелёный — красный» и рассылает уведомления.
Наблюдаемость (англ. observability) — термин теории управления: система наблюдаема, если её внутреннее состояние можно восстановить по внешним выходам 3. В эксплуатации программных систем под наблюдаемостью понимают свойство системы и её телеметрии, позволяющее ответить на новый вопрос без выпуска новой версии кода: «почему медленно отвечают только запросы с мобильных клиентов в одном регионе, и только после 18:00». В монолите на одном сервере такие вопросы решались чтением журнала и отладчиком. В облачной системе запрос пользователя проходит через балансировщик, Ingress, frontend, backend, базу данных и внешние сервисы, каждый из них работает в нескольких репликах, реплики перезапускаются и переезжают между узлами. Отказ проявляется как сочетание условий, ни одно из которых по отдельности не выглядит аномальным.
Различие не в инструментах, а в подходе. Мониторинг — подмножество наблюдаемости: правила алертов по-прежнему нужны, но к ним добавляются телеметрия с богатым контекстом (какой маршрут, какая версия, какой клиент) и средства произвольных запросов к ней. Практическое следствие: инструментировать сервис нужно так, чтобы по телеметрии можно было «разрезать» поведение по измерениям, о которых при написании кода никто не думал, но не настолько подробно, чтобы стоимость хранения превысила пользу. Этот компромисс проходит через всю тему.
Три сигнала телеметрии и их цена
Телеметрию принято делить на три вида сигналов (англ. signals) 3. Метрика (англ. metric) — числовое значение, измеряемое во времени и агрегированное заранее: число запросов, доля ошибок, распределение времени ответа, занятая память. Журнал (англ. log) — последовательность отдельных событий с временной меткой и произвольным содержимым: строка «запрос GET /api/notes завершён с кодом 500 за 812 мс». Трасса (англ. trace) — запись пути одного запроса через все сервисы, которые его обрабатывали, в виде дерева интервалов работы.
| Сигнал | На какой вопрос отвечает | Стоимость хранения растёт с | Что теряется |
|---|---|---|---|
| Метрика | что происходит и сколько: «5 % запросов завершаются ошибкой» | числом временных рядов (сочетаний лейблов), но не с числом запросов | подробности отдельного события |
| Журнал | почему: текст ошибки, параметры, состояние | объёмом событий, то есть с трафиком | связь между сервисами, если её не записали явно |
| Трасса | где: какой сервис и какая операция заняли время | числом запросов и спанов в них; обычно сокращается сэмплированием | несэмплированные запросы |
Ключевое различие — зависимость стоимости от нагрузки. Счётчик запросов занимает одинаковое место и при одном, и при миллионе запросов в секунду: увеличивается только число, а не количество данных. Журнал и трассы растут пропорционально трафику. Поэтому метрики используются для всего, что надо знать о каждом запросе в агрегате и хранить долго (алерты, тренды, планирование мощности), журналы — для подробностей, а трассы — для понимания пути запроса, причём хранят их часто лишь для доли запросов.
Что измерять: «золотые сигналы», RED и USE
Даже при ясном понимании сигналов остаётся вопрос, какие именно метрики собирать в первую очередь. Ответ дают три методики.
Книга Google SRE предлагает четыре золотых сигнала (англ. four golden signals) для любой системы, обслуживающей пользователей: задержка (англ. latency) — время обработки запросов, причём отдельно для успешных и неуспешных; трафик (англ. traffic) — интенсивность запросов; ошибки (англ. errors) — доля неуспешных запросов; насыщение (англ. saturation) — насколько «полон» сервис, то есть насколько близок к пределу самый дефицитный ресурс 1. Авторы подчёркивают, что задержку ошибок нужно отделять: быстрый ответ 500 улучшает среднее время ответа и маскирует проблему.
Методика RED (Rate, Errors, Duration) — сокращение золотых сигналов для сервисов, отвечающих на запросы: интенсивность запросов, число ошибок, распределение длительности. Её предложил Том Уилки из Grafana Labs как минимальный набор метрик, который должен отдавать каждый микросервис. Для notes-api это ровно две метрики: счётчик запросов с лейблом кода ответа (дающий R и E) и гистограмма длительности (D).
Методика USE (Utilization, Saturation, Errors) Брендана Грегга применяется к ресурсам, а не к сервисам: для каждого ресурса — процессора, памяти, диска, сетевого интерфейса — проверяются использование (доля времени, когда ресурс занят), насыщение (очередь работы, которую ресурс не успевает обслужить) и ошибки 14. Например, для процессора узла использование — доля времени не в состоянии простоя, насыщение — длина очереди готовых к выполнению потоков или метрики давления PSI из cgroups v2 (тема 3), ошибки — машинные исключения. Методики дополняют друг друга: RED показывает, что пользователям плохо, USE — какой ресурс тому причиной. В лабораторной работе дашборд содержит панели обоих видов.
Метрики Prometheus: модель данных и сбор
Модель данных и формат экспозиции
Prometheus — система сбора и хранения метрик, созданная в SoundCloud в 2012 году и ставшая вторым после Kubernetes проектом, завершившим инкубацию в CNCF (2018 год). Его модель данных проста. Временной ряд (англ. time series) — последовательность пар «момент времени — значение с плавающей точкой», идентифицируемая именем метрики и набором лейблов (англ. labels) — пар «ключ — значение». Ряды http_requests_total{method="GET", route="/api/notes", code="200"} и http_requests_total{method="GET", route="/api/notes", code="500"} — два разных ряда одной метрики. Имя метрики формально тоже лейбл (__name__), поэтому ряд целиком определяется набором лейблов.
Сервис отдаёт метрики по HTTP, обычно по пути /metrics, в текстовом формате экспозиции (англ. exposition format) 5. Ниже — фрагмент реального ответа notes-api после нескольких минут нагрузки (сокращено):
# HELP http_requests_total Число обработанных HTTP-запросов
# TYPE http_requests_total counter
http_requests_total{code="200",method="GET",route="/api/notes"} 2225.0
http_requests_total{code="201",method="POST",route="/api/notes"} 558.0
http_requests_total{code="404",method="GET",route="/api/notes/{id}"} 279.0
# HELP http_request_duration_seconds Время обработки HTTP-запроса
# TYPE http_request_duration_seconds histogram
http_request_duration_seconds_bucket{le="0.01",method="GET",route="/api/notes"} 212.0
http_request_duration_seconds_bucket{le="0.025",method="GET",route="/api/notes"} 1607.0
http_request_duration_seconds_bucket{le="0.05",method="GET",route="/api/notes"} 2170.0
http_request_duration_seconds_bucket{le="0.1",method="GET",route="/api/notes"} 2223.0
...
http_request_duration_seconds_bucket{le="+Inf",method="GET",route="/api/notes"} 2225.0
http_request_duration_seconds_count{method="GET",route="/api/notes"} 2225.0
http_request_duration_seconds_sum{method="GET",route="/api/notes"} 47.38700001814141
# HELP notes_stored Число заметок в памяти сервиса
# TYPE notes_stored gauge
notes_stored 558.0
Строка # HELP содержит описание метрики, # TYPE — её тип. Каждая следующая строка — один ряд: имя, лейблы в фигурных скобках и текущее значение. Временной метки в строке обычно нет: момент измерения назначает Prometheus при опросе. Гистограмма раскладывается на несколько рядов с суффиксами _bucket, _sum и _count, о них — в третьем разделе. Соглашения об именах тоже часть формата: единицы измерения — базовые единицы СИ (секунды, байты), а не миллисекунды и мегабайты; единица указывается в имени (_seconds, _bytes); счётчики оканчиваются на _total 5.
Существует и формат OpenMetrics — развитие текстового формата Prometheus, в котором, в частности, к значению можно приложить экземпляр (англ. exemplar) с идентификатором трассы. Клиент выбирает формат по заголовку Accept запроса; Prometheus 3.x по умолчанию предпочитает OpenMetrics. В этом формате та же гистограмма выглядит так (реальный вывод curl -H 'Accept: application/openmetrics-text; version=1.0.0'):
http_request_duration_seconds_bucket{le="0.01",method="GET",route="/api/notes/{id}"} 1.0 # {trace_id="b1d80b2fe0d04620a4a2515be8c7bb99"} 0.006981184000323992 1792616834.9757466
После знака # записан экземпляр: лейблы, наблюдённое значение (7 мс) и время наблюдения. Зачем это нужно, показано в разделе о корреляции сигналов.
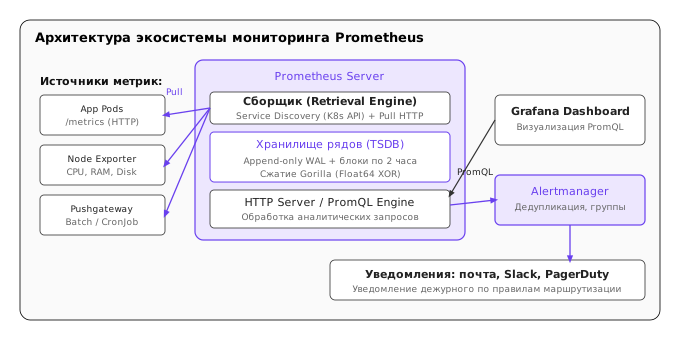
Общая архитектура показана на схеме ниже. Сервер Prometheus периодически опрашивает цели (англ. targets), записывает полученные ряды в локальную базу временных рядов (TSDB), вычисляет правила записи и алертов и отдаёт данные по языку запросов PromQL. Grafana строит по этим запросам графики, Alertmanager принимает сработавшие алерты и превращает их в уведомления.
Инструментирование сервиса на Python
Инструментирование (англ. instrumentation) — добавление в код сервиса измерений. Для Python официальная клиентская библиотека — prometheus_client. Метрика объявляется один раз на уровне модуля, а в обработчике запроса изменяется её значение. Ключевые строки notes-api (файл app.py в окружении лабораторной работы):
from prometheus_client import Counter, Gauge, Histogram
from prometheus_client.exposition import choose_encoder
from prometheus_client.registry import REGISTRY

REQUESTS = Counter("http_requests", "Число обработанных HTTP-запросов",
                   ["method", "route", "code"])          # суффикс _total добавит клиент
LATENCY = Histogram("http_request_duration_seconds", "Время обработки HTTP-запроса",
                    ["method", "route"],
                    buckets=(0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1.0, 2.5))
IN_PROGRESS = Gauge("http_requests_in_progress", "Запросы в обработке в данный момент")

# в обработчике запроса
start = time.perf_counter()
IN_PROGRESS.inc()
try:
    code = handler()                     # прикладная логика
finally:
    IN_PROGRESS.dec()
duration = time.perf_counter() - start
REQUESTS.labels(method, route, str(code)).inc()
LATENCY.labels(method, route).observe(duration, exemplar={"trace_id": trace_id})

# обработчик /metrics: формат выбирается по заголовку Accept
encoder, content_type = choose_encoder(request_headers.get("Accept"))
body = encoder(REGISTRY)
Стоит обратить внимание на четыре решения. Во-первых, лейбл route содержит шаблон маршрута /api/notes/{id}, а не фактический путь /api/notes/17: иначе каждая заметка порождала бы новые ряды (раздел о кардинальности). Неизвестные пути сводятся к значению other по той же причине. Во-вторых, код ответа учитывается после обработки, в том числе для исключений: необработанное исключение тоже считается ответом 500. В-третьих, для измерения длительности используется монотонный таймер time.perf_counter(), а не time.time(), который может прыгнуть при коррекции системных часов. В-четвёртых, служебные пути /metrics и /admin/chaos не учитываются, чтобы опрос Prometheus не искажал статистику API.
Помимо прикладных метрик клиент по умолчанию отдаёт метрики процесса: process_cpu_seconds_total, process_resident_memory_bytes, process_start_time_seconds и другие. Последняя особенно полезна: её изменение означает перезапуск процесса и, следовательно, сброс всех счётчиков. В простейшем случае сервис, не имеющий своего HTTP-сервера, открывает отдельный порт метрик вызовом start_http_server(8000).
Четыре типа метрик
Prometheus различает четыре типа метрик 5. Тип влияет на то, какие функции PromQL к метрике применимы и как её агрегировать.
| Тип | Поведение значения | Пример в notes-api | Типичные функции PromQL |
|---|---|---|---|
| Counter (счётчик) | только растёт; обнуляется при перезапуске процесса | http_requests_total | rate, increase, irate |
| Gauge (измеритель) | растёт и убывает | http_requests_in_progress, notes_stored | значение как есть, avg_over_time, max_over_time, deriv, delta |
| Histogram (гистограмма) | набор счётчиков по корзинам, а также сумма и число наблюдений | http_request_duration_seconds | histogram_quantile над rate от _bucket |
| Summary (сводка) | готовые квантили, вычисленные в клиенте, а также сумма и число | в учебном сервисе не используется | значение квантиля как есть; _sum/_count — как счётчики |
Счётчик (англ. counter) — монотонно неубывающее число событий или накопленная величина: запросы, байты, секунды процессорного времени. Само значение счётчика почти никогда не интересно: число «2225 запросов с момента запуска» зависит от времени запуска. Интересна скорость его роста.
Измеритель (англ. gauge) — мгновенное значение, которое может как расти, так и убывать: занятая память, число запросов в обработке, длина очереди, температура. Значение измерителя имеет смысл само по себе.
Гистограмма (англ. histogram) — распределение наблюдений по заранее заданным корзинам (англ. buckets). Каждая корзина — счётчик наблюдений, не превышающих её верхнюю границу le («less or equal»), поэтому корзины накопительные: le="0.05" включает всё, что попало в le="0.025". Последняя корзина le="+Inf" равна общему числу наблюдений. Сводка (англ. summary) вычисляет квантили (например, 0,5 и 0,99) в самом клиенте по скользящему окну и отдаёт их готовыми. В клиенте для Python Summary квантилей не вычисляет вовсе и отдаёт только _sum и _count. Чем различаются гистограмма и сводка по существу, разобрано в третьем разделе.
Тип в строке # TYPE — подсказка, а не ограничение: TSDB хранит все ряды одинаково, числами с плавающей точкой. Поэтому применить функцию для счётчиков к измерителю технически можно, и результат будет бессмысленным; почему именно — показано ниже.
Сбор по модели опроса: pull против push
Prometheus собирает метрики по модели опроса (англ. pull model): сервер сам с интервалом scrape_interval (в конфигурации по умолчанию 1 минута, на практике обычно 15–30 с) выполняет HTTP-запрос к каждой цели. Альтернатива — модель отправки (англ. push model), в которой сервис сам отправляет данные на сервер. Выбор между ними определяется не производительностью, а тем, кто знает список наблюдаемых объектов и как обнаруживается их отсутствие.
При опросе сервер знает, кого он должен опросить: список целей задан статически или получен через обнаружение сервисов (англ. service discovery). Поэтому для каждой цели Prometheus формирует синтетические ряды о самом опросе: up (1 — опрос успешен, 0 — неуспешен), scrape_duration_seconds, scrape_samples_scraped. Выражение up == 0 — простейший и самый надёжный алерт о «смерти» цели: упавший сервис не может сообщить о своём падении, а опрашивающий сервер замечает его отсутствие. Кроме того, частоту и объём сбора контролирует сервер, а не тысячи клиентов: ошибка в коде сервиса не может завалить Prometheus потоком отправок, а нагрузка на сбор определяется конфигурацией (число целей, число рядов, интервал) 4. Наконец, любую цель можно открыть вручную curl http://app:8000/metrics и увидеть ровно то, что видит Prometheus.
У модели опроса есть и ограничения. Сервер должен иметь сетевой доступ к каждой цели, что затруднительно за NAT или межсетевым экраном. Короткоживущие задачи (пакетная обработка, CronJob) могут завершиться между двумя опросами. Для них предназначен Pushgateway — промежуточный сервис, в который задача отправляет метрики перед завершением и который Prometheus затем опрашивает как обычную цель. Документация Prometheus рекомендует его только для пакетных задач уровня сервиса и перечисляет недостатки: Pushgateway становится единой точкой отказа; ряд up описывает доступность самого Pushgateway, а не задач; отправленные ряды хранятся до явного удаления, так что данные давно завершённой задачи продолжают выглядеть актуальными 9. В конфигурации цели Pushgateway задаётся honor_labels: true, чтобы лейблы job и instance, присланные задачей, не перезаписывались лейблами самого Pushgateway.
Модель отправки стала нормой в OpenTelemetry: SDK и Collector отправляют данные по протоколу OTLP. Prometheus 3.x умеет принимать OTLP напрямую (флаг --web.enable-otlp-receiver, путь /api/v1/otlp/v1/metrics), а также запись по протоколу remote write. При отправке исчезает естественный признак отсутствия: нет данных — значит, либо сервис мёртв, либо он просто ничего не отправил. Такие алерты строятся на absent() или absent_over_time() и требуют, чтобы система заранее знала, что ряд должен существовать.
В Kubernetes Prometheus получает список целей из API-сервера (kubernetes_sd_configs с ролями node, pod, service, endpointslice и другими) и отфильтровывает их правилами переразметки (англ. relabeling). Для этого его ServiceAccount должен иметь права get, list, watch на соответствующие ресурсы — те самые ClusterRole и ClusterRoleBinding из темы 11. Аннотации вида prometheus.io/scrape: "true" — не встроенный механизм, а соглашение, которое реализуется правилами переразметки в конфигурации; Prometheus Operator вместо них использует ресурсы ServiceMonitor и PodMonitor. В кластере сосуществуют несколько источников метрик, которые часто путают:
| Источник | Что измеряет | Пример метрики |
|---|---|---|
| node_exporter (DaemonSet) | ресурсы узла: CPU, память, диски, сеть, файловые системы | node_cpu_seconds_total, node_filesystem_avail_bytes |
| cAdvisor во встроенном kubelet | потребление ресурсов контейнерами по данным cgroups | container_cpu_usage_seconds_total, container_memory_working_set_bytes |
| kube-state-metrics | состояние объектов API: сколько реплик желаемо и доступно, в какой фазе под | kube_pod_status_phase, kube_deployment_status_replicas_available |
| metrics-server | мгновенное потребление CPU и памяти для HPA и kubectl top (тема 7) | в Prometheus не хранится, отдаёт Metrics API |
Различие node_exporter и kube-state-metrics принципиально. Первый отвечает на вопрос «чем занят узел», читая /proc и /sys; он ничего не знает о подах. Второй ничего не измеряет на узлах: он подписан (watch) на API-сервер и превращает поля объектов в метрики, например kube_pod_status_phase{phase="Pending"} 1 для пода, ожидающего планирования. Без него запрос «сколько подов в фазе Pending» невозможен, хотя все метрики узлов собираются.
PromQL: скорости, квантили и кардинальность
Векторы, селекторы и агрегация
PromQL — функциональный язык запросов к временным рядам 6. Его выражения возвращают значения одного из типов. Мгновенный вектор (англ. instant vector) — набор рядов, у каждого одно значение в момент вычисления: http_requests_total{route="/api/notes"}. Вектор диапазона (англ. range vector) — набор рядов, у каждого все точки за указанный интервал: http_requests_total[5m]. Вектор диапазона нельзя нарисовать на графике напрямую; он служит аргументом функций вроде rate. С Prometheus 3.0 интервал селектора открыт слева: точка, попавшая ровно на левую границу, в выборку не входит 6.
Селектор фильтрует ряды по лейблам с операторами =, !=, =~ (регулярное выражение, всегда привязанное к началу и концу строки) и !~. Операторы агрегации (sum, avg, max, count, topk, quantile) сворачивают ряды, оставляя лейблы, перечисленные в by, или удаляя перечисленные в without. Бинарные операции между векторами сопоставляют ряды по совпадению всех лейблов, если не указано иное (on, ignoring, group_left). Пример — доля ответов 5xx по каждому маршруту:
sum by (route) (rate(http_requests_total{job="notes-api", code=~"5.."}[5m]))
/
sum by (route) (rate(http_requests_total{job="notes-api"}[5m]))
Агрегация до деления обязательна: числитель и знаменатель должны иметь одинаковый набор лейблов, иначе ряды не сопоставятся и результат окажется пустым. Если в числителе нет ни одного ряда (ошибок не было), запрос вернёт пустой результат, а не ноль — особенность, о которой сказано в разделе об ошибках интерпретации.
Часто используемые выражения вычисляются заранее правилами записи (англ. recording rules), результат которых сохраняется как новый ряд. По соглашению имя такого ряда имеет вид уровень:метрика:операции, например job:http_errors:ratio_rate5m. Правила записи ускоряют дашборды и делают алерты читаемыми.
Функции rate, irate, increase и сброс счётчика
Функция rate(v[d]) вычисляет среднюю скорость роста счётчика в секунду за интервал d. Принципиально важны две её особенности: обработка сбросов и экстраполяция к границам окна 6.
Рассмотрим числовой пример. Счётчик опрашивается каждые 15 с; запрос rate(x[1m]) вычисляется в момент 60 с, его окно охватывает интервал от 0 до 60 с, и в него попали четыре точки:
| Момент, с | 10 | 25 | 40 | 55 |
|---|---|---|---|---|
| Значение | 100 | 130 | 10 | 40 |
Между 25 и 40 с значение уменьшилось: процесс перезапустился, и счётчик начал счёт с нуля. Для счётчика уменьшение возможно только при сбросе, поэтому rate считает, что после сброса счёт шёл от нуля, и прибавляет новое значение целиком. Приращения: 130 − 100 = 30, затем 10 (от нуля до 10), затем 40 − 10 = 30, всего 70 за 45 с между первой и последней точками. Наивная разность «последнее минус первое» дала бы 40 − 100 = −60.
Далее вычисление экстраполируется к границам окна, поскольку первая точка отстоит от начала окна на 10 с, а последняя от конца — на 5 с. Средний интервал между точками 15 с; оба зазора меньше порога 1,1 × 15 = 16,5 с, поэтому экстраполяция идёт до самых границ. Приращение за всё окно:
\text{increase} = 70 \cdot \frac{45 + 10 + 5}{45} \approx 93{,}3, \qquad \text{rate} = \frac{93{,}3}{60\ \text{с}} \approx 1{,}56\ \text{с}^{-1}.
Функция increase(x[1m]) возвращает именно 93,3 — нецелое число, хотя счётчик растёт целыми шагами. Документация прямо говорит, что это следствие экстраполяции 6. Функция increase по сути равна rate, умноженному на длину окна, и удобна для формулировок «сколько ошибок за час».
Функция irate(x[1m]) берёт только две последние точки окна: (40 − 10) / 15 = 2 запроса в секунду. Она реагирует на всплески, но шумит и при интервале обновления графика больше интервала опроса пропускает всё происходящее между отображаемыми точками. Для алертов и правил записи используется rate; irate уместна на подробных графиках с коротким горизонтом.
Окно должно содержать минимум две точки, иначе rate возвращает пустой результат. При интервале опроса 15 с окно [15s] часто содержит одну точку, и график превращается в пунктир. Практическая рекомендация — окно не короче четырёх интервалов опроса; Grafana для этого вычисляет переменную $__rate_interval из интервала опроса источника данных.
Теперь ясно, почему rate не применяют к измерителю. Пусть занятая память последовательно принимает значения 500, 300 и 350 МиБ. Функция rate воспримет уменьшение 500 → 300 как сброс счётчика и прибавит 300 целиком, получив рост на 350 МиБ вместо фактического изменения на −150 МиБ. Для измерителей предназначены delta (разность первого и последнего значения с экстраполяцией), deriv (наклон линии регрессии в единицах в секунду) и функции *_over_time — avg_over_time, max_over_time, min_over_time.
Гистограмма против сводки и оценка квантилей
Среднее время ответа — плохая характеристика сервиса: десять процентов запросов по две секунды на фоне быстрых ответов сдвигают среднее незаметно, хотя каждый десятый пользователь страдает. Поэтому задержку описывают квантилями: p95 — время, быстрее которого обслуживаются 95 % запросов. Вычислить точный квантиль можно, только храня все наблюдения, а это противоречит идее метрики как дешёвого агрегата. Гистограмма и сводка — два способа приближения.
Сводка вычисляет квантиль в клиенте, точно или с заданной погрешностью, но за собственное скользящее окно и для одного процесса. Агрегировать такие квантили между репликами нельзя. Пусть реплика A обслуживает 1000 запросов в секунду с p99 = 100 мс, а реплика B — 2 запроса в секунду с p99 = 900 мс. Среднее квантилей (100 + 900) / 2 = 500 мс не описывает ничего: на B приходится 0,2 % трафика, и общий p99 близок к p99 реплики A. Квантиль смеси распределений не выражается через квантили составляющих, поэтому никакая операция над готовыми квантилями не даёт верного ответа 7.
Гистограмма хранит не квантили, а счётчики по корзинам. Счётчики складываются, поэтому корзины всех реплик суммируются, и квантиль оценивается по общему распределению:
histogram_quantile(0.95,
  sum by (le) (rate(http_request_duration_seconds_bucket{job="notes-api", route="/api/notes"}[5m])))
Лейбл le обязательно сохраняется в by: без него корзины сольются в одно число. Платой за агрегируемость является точность: внутри корзины распределение неизвестно, и histogram_quantile предполагает, что наблюдения распределены в ней равномерно, то есть выполняет линейную интерполяцию 6. Если квантиль попадает в корзину +Inf, возвращается верхняя граница предыдущей корзины; для нижней корзины нижняя граница считается равной нулю.
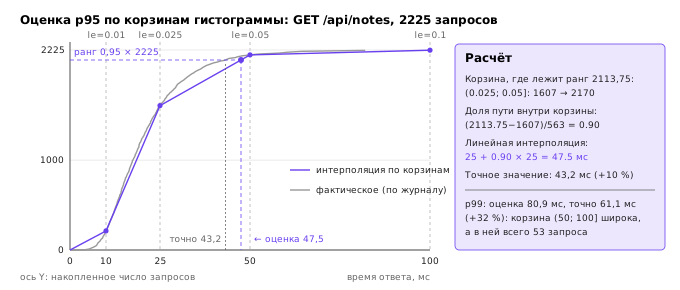
Разберём оценку на реальных данных notes-api: 2225 запросов GET /api/notes, накопленные значения корзин 212 (до 10 мс), 1607 (до 25 мс), 2170 (до 50 мс), 2223 (до 100 мс), 2225 (до 250 мс). Ранг квантиля 0,95 равен 0,95 × 2225 = 2113,75. Это значение лежит между 1607 и 2170, то есть в корзине от 25 до 50 мс, где 563 наблюдения. Доля пути внутри корзины и оценка:
\frac{2113{,}75 - 1607}{563} \approx 0{,}900, \qquad \hat q_{0,95} = 25 + 0{,}900 \cdot (50 - 25) \approx 47{,}5\ \text{мс}.
Сервис записывает длительность каждого запроса и в журнал, поэтому точный p95 можно вычислить по журналу: 43,2 мс. Ошибка оценки +4,3 мс, или 10 %. Для p99 ранг 2202,75 попадает в корзину от 50 до 100 мс, где всего 53 наблюдения: оценка 50 + 0,618 × 50 ≈ 80,9 мс при точном значении 61,1 мс, ошибка +32 %. Причина видна на рисунке ниже: внутри широкой корзины реальное распределение сосредоточено у левого края, а интерполяция «размазывает» его равномерно.
Из этого следуют правила выбора корзин. Ошибка оценки ограничена шириной корзины, в которую попал квантиль, поэтому корзины должны быть узкими там, где лежат интересные квантили. Если цель уровня обслуживания сформулирована как «95 % запросов быстрее 250 мс», граница 0,25 должна быть среди корзин: тогда доля быстрых запросов вычисляется вообще без интерполяции, делением _bucket{le="0.25"} на _count. Число корзин умножает число рядов, поэтому их обычно 10–15. Prometheus 3.x поддерживает также нативные гистограммы (англ. native histograms) с экспоненциальными корзинами, которые хранятся как один составной ряд и дают ограниченную относительную ошибку без ручного выбора границ; их приём включается параметром конфигурации scrape_native_histograms, по умолчанию выключенным.
| Свойство | Histogram | Summary |
|---|---|---|
| Где вычисляется квантиль | на сервере, при запросе | в клиенте, при записи |
| Агрегация по репликам | корректна (суммируются корзины) | невозможна |
| Точность | ограничена шириной корзины | задаётся в клиенте |
| Выбор квантиля и окна | в момент запроса, любые | при инструментировании, фиксированы |
| Стоимость в рядах | число корзин + 2 на сочетание лейблов | число квантилей + 2 |
Кардинальность и её расчёт
Кардинальность (англ. cardinality) метрики — число её временных рядов, то есть различных сочетаний значений лейблов. Каждый активный ряд занимает память в головном блоке TSDB Prometheus и место в индексе, поэтому число рядов — главный фактор стоимости и стабильности сервера.
Верхняя граница числа рядов метрики равна произведению кардинальностей её лейблов. Для notes-api: методов 3 (GET, POST, DELETE), шаблонов маршрутов 6, кодов ответа около 6 (200, 201, 204, 400, 404, 500). Для счётчика граница составляет 3 × 6 × 6 = 108 рядов, реально существующих сочетаний меньше. Гистограмма имеет лейблы method и route и для каждого сочетания порождает 8 + 1 корзин, а также _sum и _count, то есть 11 рядов: 3 × 6 × 11 = 198. Всё это на один экземпляр сервиса; при 10 репликах лейбл instance умножает итог на 10.
Добавим лейбл user_id при 10 000 активных пользователях. Каждый лейбл — новый множитель:
N = \underbrace{(108 + 198)}_{\text{без user\_id}} \times 10\,000 \times 10\ \text{реплик} \approx 3 \cdot 10^{7}\ \text{рядов}.
Рост мультипликативный: добавление лейбла умножает число рядов на число его значений. Опасен любой лейбл с неограниченным множеством значений: идентификатор пользователя, заказа или запроса, IP-адрес клиента, полный URL с параметрами, текст ошибки. Такие значения место в журналах и трассах, где стоимость не зависит от их разнообразия.
Ошибка легко возникает непреднамеренно. В лабораторной работе сервис запускается с ROUTE_LABEL=raw, и лейбл route получает фактический путь вместо шаблона. При нагрузке 20 запросов в секунду с обращениями к случайным заметкам за 30 с число рядов http_* в выводе /metrics выросло до 1155 против 75 при правильной разметке, и продолжает расти с каждым новым идентификатором. Число рядов по каждой метрике показывает страница состояния TSDB Prometheus и запрос count by (__name__) ({job="notes-api"}).
SLO, бюджет ошибок и алертинг
SLI, SLO и бюджет ошибок
Чтобы решить, хорошо ли работает сервис, нужно договориться о мере. Индикатор уровня обслуживания (англ. service level indicator, SLI) — измеримая величина качества с точки зрения пользователя, обычно доля «хороших» событий среди всех: доля запросов без ошибки 5xx, доля запросов быстрее 250 мс 1. Цель уровня обслуживания (англ. service level objective, SLO) — целевое значение SLI за окно: «99,9 % запросов к API за скользящие 30 дней завершаются без 5xx». Соглашение об уровне обслуживания (SLA) из темы 1 — юридическое обязательство перед клиентом с последствиями при нарушении; SLO — внутренняя инженерная цель, обычно строже SLA, чтобы нарушение цели обнаруживалось раньше нарушения договора.
Принципиальная идея SLO — стопроцентная надёжность не нужна и недостижима: пользователь не отличит 99,99 % от 100 %, потому что его собственная сеть и устройство надёжны меньше, а каждая следующая «девятка» стоит дороже предыдущей 1. Разность между 100 % и SLO называется бюджетом ошибок (англ. error budget). Для SLO 99,9 % за 30 дней:
B = (1 - 0{,}999) \cdot 30 \cdot 24 \cdot 60\ \text{мин} = 43{,}2\ \text{мин}.
Это время полной недоступности, допустимое за 30 дней; для SLO по запросам бюджет выражается в запросах: при 10 млн запросов в месяц допустимо 10 000 ошибочных. Бюджет превращает надёжность из абстрактной ценности в ресурс, который можно тратить: пока он не исчерпан, команда выпускает изменения, рискуя частью бюджета; когда исчерпан — приоритет переходит к надёжности. Для SLO 99 % бюджет составляет 432 мин, для 99,99 % — 4,32 мин; последнее значение меньше, чем занимает типичный ручной откат релиза.
Скорость сжигания и многооконные алерты
Как превратить SLO в алерт? Наивное правило «доля ошибок больше 0,1 % в течение 5 минут» плохо по двум причинам. Оно срабатывает на кратковременные всплески, которые расходуют ничтожную часть бюджета: пять минут при 1 % ошибок расходуют 5 мин × 0,01 = 0,05 мин, то есть около 0,1 % месячного бюджета, и будить из-за этого человека не нужно. И оно не различает тяжесть: 0,2 % ошибок и полный отказ дают одинаковый алерт.
Решение, описанное в книге SRE Workbook, — алерты по скорости сжигания (англ. burn rate) бюджета 2. Скорость сжигания — отношение текущей доли ошибок к допустимой:
b = \frac{e}{1 - \text{SLO}}.
При b = 1 бюджет расходуется ровно за окно SLO (30 дней), при b = 14,4 — за 30 · 24 / 14,4 = 50 ч. Порог алерта задаётся как доля бюджета, израсходованная за окно наблюдения: если за 1 ч израсходовано 2 % месячного бюджета, то b = 0,02 · 720 ч / 1 ч = 14,4. Для SLO 99,9 % это доля ошибок 14,4 × 0,001 = 1,44 %. Рекомендованный набор правил 2:
| Тяжесть | Длинное окно | Короткое окно | Скорость сжигания | Израсходовано бюджета при срабатывании |
|---|---|---|---|---|
| вызов дежурного | 1 ч | 5 мин | 14,4 | 2 % |
| вызов дежурного | 6 ч | 30 мин | 6 | 5 % |
| задача в трекере | 3 сут | 6 ч | 1 | 10 % |
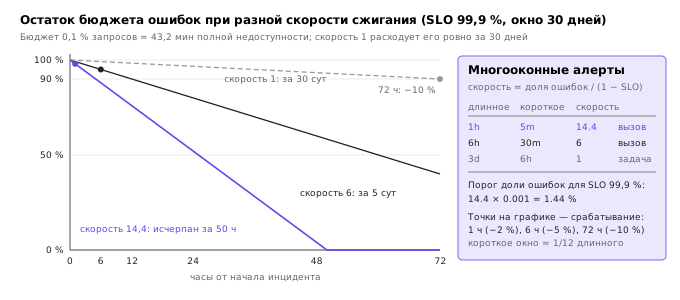
Длинное окно обеспечивает значимость: алерт срабатывает, только если израсходована заметная доля бюджета. Время обнаружения при доле ошибок e оценивается как ((1 − SLO) / e) · W · b, где W — длинное окно 2. При полном отказе (e = 1) правило 14,4/1 ч срабатывает через 0,001 · 60 мин · 14,4 ≈ 0,86 мин, при доле ошибок 2 % — через 43 мин. Короткое окно, равное 1/12 длинного, решает другую задачу — время сброса. Без него алерт по часовому окну продолжал бы гореть до часа после окончания инцидента; условие «и в последние 5 минут доля ошибок выше порога» гасит его вскоре после восстановления. Схема на рисунке выше показывает, как разные скорости расходуют бюджет и в какой момент срабатывают правила.
Правила алертов в Prometheus
Правило алерта — выражение PromQL, вычисляемое с интервалом evaluation_interval; каждый ряд результата становится активным алертом 8. Правила быстрого и медленного сжигания из лабораторной работы опираются на правила записи job:http_errors:ratio_rate1h и других окон:
groups:
  - name: notes-api-alerts
    rules:
      - alert: NotesApiErrorBudgetBurnFast
        expr: |
          job:http_errors:ratio_rate1h{job="notes-api"} > (14.4 * 0.001)
          and
          job:http_errors:ratio_rate5m{job="notes-api"} > (14.4 * 0.001)
        labels:
          severity: critical
        annotations:
          summary: "Бюджет ошибок сжигается в 14,4 раза быстрее допустимого"

      - alert: NotesApiHighErrorRatio
        expr: job:http_errors:ratio_rate5m{job="notes-api"} > 0.05
        for: 2m
        labels:
          severity: warning
Поле for задаёт, сколько времени условие должно непрерывно выполняться: алерт сначала переходит в состояние pending и лишь по истечении for — в firing; если на любом вычислении условие ложно, отсчёт начинается заново. Без for единичный выброс сразу порождает уведомление. Для многооконных правил for обычно не нужен: роль фильтра кратковременных всплесков играет длинное окно. Поле keep_firing_for решает обратную задачу — не гасить алерт при кратком исчезновении условия. Лейблы алерта (severity) используются Alertmanager для маршрутизации, аннотации (summary) — для текста уведомления; в них доступны шаблоны {{ $value }} и {{ $labels.instance }}.
Синтаксис правил проверяется до загрузки командой promtool check rules; при ошибке Prometheus отказывается перечитывать конфигурацию и продолжает работать со старой, а метрика prometheus_config_last_reload_successful становится равной 0. Правила полезно и тестировать: promtool test rules прогоняет заданные ряды через правила и сравнивает сработавшие алерты с ожидаемыми.
Alertmanager: группировка, подавление, тишина
Prometheus только вычисляет правила и отправляет активные алерты в Alertmanager. Всё, что связано с уведомлением людей, — отдельный сервис, и это разделение сделано намеренно: несколько реплик Prometheus для отказоустойчивости вычисляют одни и те же правила, и Alertmanager устраняет дубликаты 8.
Группировка (англ. grouping) объединяет алерты с одинаковыми значениями лейблов из group_by в одно уведомление. Если откажет узел с сорока подами, дежурный получит одно сообщение «40 алертов NotesApiDown», а не сорок. Параметр group_wait (по умолчанию 30 с) — сколько ждать после первого алерта группы, пока подтянутся остальные; group_interval (по умолчанию 5 мин) — как часто сообщать об изменениях в уже отправленной группе; repeat_interval (по умолчанию 4 ч) — как часто напоминать о неизменной активной группе.
Маршрутизация задаётся деревом route: алерт проходит по дочерним маршрутам и попадает в первый подходящий по matchers. Обычная схема — severity="critical" к системе вызова дежурного, остальное — в чат или трекер.
Подавление (англ. inhibition) отключает уведомления по одним алертам, пока активны другие. Правило ниже не отправляет предупреждения по сервису, пока по нему же горит критический алерт: при быстром сжигании бюджета сообщение «доля ошибок выше 5 %» ничего не добавляет.
inhibit_rules:
  - source_matchers: ['severity="critical"']
    target_matchers: ['severity="warning"']
    equal: ["job"]
Поле equal ограничивает подавление алертами с одинаковым значением лейбла: критический алерт сервиса A не заглушает предупреждения сервиса B. Классический пример — отказ узла подавляет алерты о всех сервисах на этом узле.
Тишина (англ. silence) — временное отключение уведомлений по набору сопоставителей лейблов, создаваемое вручную через веб-интерфейс или amtool silence add, например на время плановых работ. В отличие от подавления, тишина не зависит от других алертов и имеет явный срок окончания. Алерт продолжает вычисляться и виден в интерфейсе — подавляется только уведомление.
Журналы и трассы
Loki и язык LogQL
Классический стек журналов на Elasticsearch строит полнотекстовый инвертированный индекс по каждому слову каждой строки. Это даёт быстрый поиск по произвольному слову, но индекс сравним по объёму с самими данными и требует значительной памяти. Grafana Loki выбирает противоположный компромисс: индексируются только лейблы потока, как в Prometheus, а сами строки сжимаются блоками — чанками (англ. chunks) — и хранятся в объектном хранилище 12. Поток (англ. stream) в Loki — последовательность строк с одинаковым набором лейблов, например все строки контейнера app проекта lab12 уровня error. В эксплуатации чанки и индекс лежат в S3-совместимом хранилище (тема 10); учебный стенд использует локальную файловую систему.
Запрос LogQL начинается с селектора потоков, который через индекс находит нужные чанки, после чего строки внутри них просматриваются и фильтруются последовательно:
{service="app"} |= "code=500"
{service="app", level="error"} | logfmt | route="/api/notes" | duration_ms > 500
{service="app"} | logfmt | trace_id="4bf92f3577b34da6a3ce929d0e0e4736"
Первый запрос — фильтр по подстроке (|=, !=, |~ для регулярного выражения, !~). Второй разбирает строку в формате logfmt (key=value) и фильтрует по извлечённым полям, причём duration_ms > 500 сравнивает числа. Аналогично работают разборщики json, pattern и regexp. LogQL также умеет строить метрики из журналов:
sum by (route) (rate({service="app"} | logfmt | code >= 500 [5m]))
quantile_over_time(0.95, {service="app"} | logfmt | unwrap duration_ms | __error__="" [5m]) by (route)
Второе выражение вычисляет точный p95 по длительностям, записанным в журнал, и может служить проверкой оценки по гистограмме. Цена такого запроса — чтение всех строк потока за окно, тогда как histogram_quantile читает несколько рядов.
Модель хранения определяет главное правило: лейблов потока должно быть мало, и у каждого — мало значений. Каждое новое сочетание лейблов создаёт новый поток с собственными мелкими чанками и записью в индексе; лейбл trace_id или user_id порождает миллионы потоков по одной строке, что разрушает и запись, и чтение. Хорошие лейблы — кластер, пространство имён, приложение, контейнер, уровень. Высококардинальные поля либо остаются в тексте строки, либо записываются в структурированные метаданные (англ. structured metadata) — пары «ключ — значение», прикреплённые к строке, но не входящие в индекс потоков; в Loki 3 они включены по умолчанию. В лабораторной работе так хранится trace_id.
Доставкой журналов в Loki занимается агент на каждом узле. Долгое время им был Promtail, в 2025 году объявленный устаревшим; его преемник — Grafana Alloy, единый агент для журналов, метрик и трасс, конфигурация которого описывает граф компонентов: обнаружение источников, переразметку, разбор строк и отправку.
OpenTelemetry: сигналы, SDK и контекст трассы
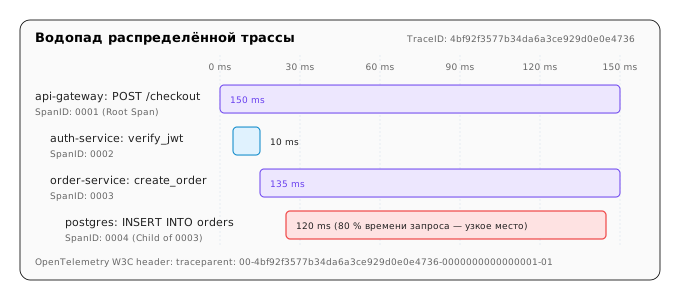
Распределённая трассировка (англ. distributed tracing) восходит к системе Dapper, описанной Google в 2010 году 13. Трасса — дерево спанов (англ. spans): каждый спан описывает одну операцию (обработку HTTP-запроса, SQL-запрос, вызов внешнего API) с моментами начала и конца, атрибутами и статусом. Все спаны трассы несут общий идентификатор трассы (TraceID, 16 байт), каждый спан — собственный идентификатор спана (SpanID, 8 байт) и ссылку на родителя. По этим ссылкам строится «водопад» на схеме ниже: видно, что из 150 мс запроса 120 мс заняла вставка в базу.
Чтобы спаны разных сервисов попали в одну трассу, идентификаторы передаются вместе с запросом — это распространение контекста (англ. context propagation). Стандарт W3C Trace Context определяет HTTP-заголовок traceparent из четырёх полей через дефис 10:
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
             │  │                                │                └─ trace-flags: 01 — трасса сэмплирована
             │  │                                └─ parent-id: SpanID вызывающего спана, 16 hex-цифр (8 байт)
             │  └─ trace-id: 32 hex-цифры (16 байт), общий для всей трассы
             └─ version: версия формата, 00
Идентификаторы из одних нулей недопустимы. Младший бит поля флагов — признак сэмплирования: вызывающая сторона сообщает, записывает ли она эту трассу. Второй заголовок, tracestate, переносит данные конкретных систем трассировки. Сервис, получивший запрос, берёт trace-id из заголовка, создаёт свой спан с новым SpanID, а в исходящие запросы подставляет traceparent с тем же trace-id и своим SpanID в качестве parent-id.
OpenTelemetry (OTel) — проект CNCF, образованный в 2019 году слиянием OpenTracing и OpenCensus. Он стандартизирует API, SDK для языков программирования, протокол OTLP и семантические соглашения об именах атрибутов (http.request.method, http.route, http.response.status_code) для трёх стабильных сигналов — трасс, метрик и журналов; профили находятся в разработке 11. Ниже — минимальная программа на Python с SDK 1.45: она принимает входящий traceparent, создаёт серверный спан и дочерний спан запроса к базе и выводит исходящий заголовок.
from opentelemetry import trace, propagate
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import SimpleSpanProcessor, ConsoleSpanExporter
from opentelemetry.sdk.trace.sampling import ParentBased, TraceIdRatioBased

provider = TracerProvider(resource=Resource.create({"service.name": "notes-api"}),
                          sampler=ParentBased(TraceIdRatioBased(1.0)))
provider.add_span_processor(SimpleSpanProcessor(ConsoleSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("notes.handlers")

ctx = propagate.extract({"traceparent": "00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01"})
with tracer.start_as_current_span("GET /api/notes", context=ctx, kind=trace.SpanKind.SERVER) as span:
    span.set_attribute("http.route", "/api/notes")
    with tracer.start_as_current_span("SELECT notes"):
        headers = {}
        propagate.inject(headers)
        print("outgoing:", headers)
outgoing: {'traceparent': '00-4bf92f3577b34da6a3ce929d0e0e4736-441b0d6b022a9e7d-01'}
{"name": "SELECT notes", "context": {"trace_id": "0x4bf92f3577b34da6a3ce929d0e0e4736", "span_id": "0x441b0d6b022a9e7d", ...}, "parent_id": "0x7f2d21dbc8b74331", ...}
{"name": "GET /api/notes", "context": {"trace_id": "0x4bf92f3577b34da6a3ce929d0e0e4736", "span_id": "0x7f2d21dbc8b74331", ...}, "kind": "SpanKind.SERVER", "parent_id": "0x00f067aa0ba902b7", ...}
Вывод подтверждает механизм: оба спана получили trace-id из входящего заголовка; родитель серверного спана — 00f067aa0ba902b7, SpanID вызывающей стороны; родитель спана базы — серверный спан; в исходящем заголовке parent-id равен SpanID текущего спана. В рабочей конфигурации ConsoleSpanExporter заменяется экспортёром OTLP, а SimpleSpanProcessor — BatchSpanProcessor, отправляющим спаны пачками в фоне. Значительную часть спанов дают библиотеки автоматического инструментирования для веб-фреймворков, HTTP-клиентов и драйверов баз данных, не требующие правки кода.
OpenTelemetry Collector и сэмплирование
OpenTelemetry Collector — отдельный процесс, принимающий, обрабатывающий и отправляющий телеметрию. Его конфигурация состоит из компонентов трёх видов и конвейеров (англ. pipelines), связывающих их для каждого сигнала 11. Приёмники (англ. receivers) получают данные: otlp (gRPC на порту 4317, HTTP на 4318), prometheus (опрос целей как у Prometheus), filelog (чтение файлов журналов). Обработчики (англ. processors) преобразуют поток: memory_limiter отбрасывает данные при приближении к пределу памяти, batch собирает пачки, attributes и resource правят атрибуты, tail_sampling принимает решения о сэмплировании. Экспортёры (англ. exporters) отправляют данные в хранилища: otlp, otlphttp, prometheusremotewrite, debug. Схема ниже показывает типичную конфигурацию с тремя конвейерами.
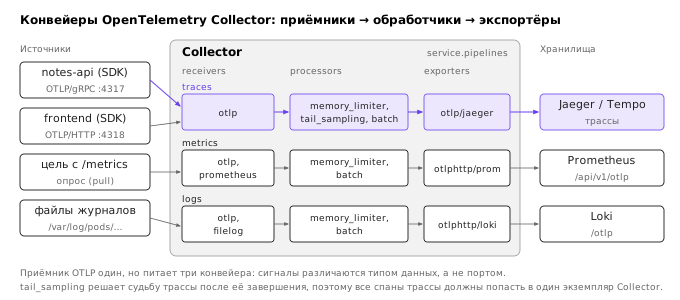
receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }
processors:
  memory_limiter: { check_interval: 1s, limit_mib: 400 }
  batch: {}
exporters:
  otlp/jaeger:
    endpoint: jaeger:4317
    tls: { insecure: true }
  otlphttp/prom:
    endpoint: http://prometheus:9090/api/v1/otlp   # Prometheus с --web.enable-otlp-receiver
service:
  pipelines:
    traces:  { receivers: [otlp], processors: [memory_limiter, batch], exporters: [otlp/jaeger] }
    metrics: { receivers: [otlp], processors: [memory_limiter, batch], exporters: [otlphttp/prom] }
Collector отделяет приложение от хранилища: сервис всегда отправляет OTLP на локальный адрес, а куда дальше пойдут данные, решает конфигурация Collector. Его разворачивают либо агентом на каждом узле (DaemonSet), либо шлюзом — отдельным Deployment, — либо в обоих видах сразу. Компоненты разделены по дистрибутивам: базовый содержит основные приёмники, обработчики и экспортёры, а многие специализированные компоненты, например tail_sampling, входят только в расширенный дистрибутив contrib.
Трасс много, и хранить все дорого, поэтому применяют сэмплирование (англ. sampling) — сохранение доли трасс. При головном сэмплировании (англ. head sampling) решение принимается в начале трассы, в корневом сервисе: сэмплер TraceIdRatioBased(0.1) оставляет 10 % трасс, причём решение — детерминированная функция trace-id, а ParentBased заставляет остальные сервисы следовать флагу из traceparent. Так трасса либо сохраняется целиком, либо не сохраняется вовсе. Головное сэмплирование дёшево, но слепо: в начале запроса неизвестно, окажется ли он ошибочным или медленным, и редкие интересные трассы отбрасываются в той же пропорции, что и обычные.
Хвостовое сэмплирование (англ. tail sampling) принимает решение после завершения трассы: обработчик tail_sampling буферизует спаны в течение decision_wait и применяет политики — сохранить все трассы со статусом ошибки, все длиннее 500 мс и 1 % остальных 11. Цена — память на буфер и архитектурное требование: все спаны одной трассы должны прийти в один экземпляр Collector. Поэтому перед слоем хвостового сэмплирования ставят слой с экспортёром loadbalancing, распределяющим спаны по trace-id. Из сэмплирования следует и правило для метрик: RED-метрики нужно вычислять до сэмплирования — в коде сервиса или коннектором spanmetrics в Collector, — иначе доля ошибок будет искажена политикой отбора.
Корреляция сигналов
Три сигнала полезны по отдельности, но их сила — в связях. Типичный путь расследования начинается с графика и заканчивается конкретной строкой журнала, и каждый переход опирается на общий идентификатор, как показано на рисунке ниже.
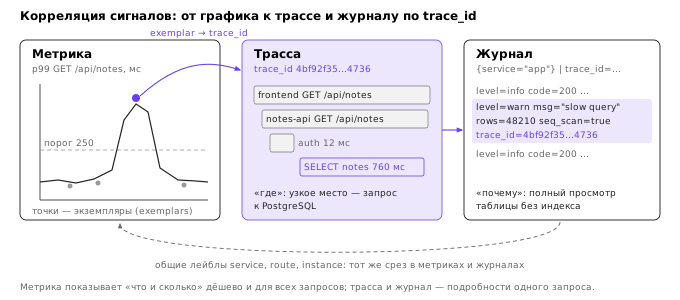
Первый переход — от метрики к трассе — обеспечивают экземпляры (англ. exemplars): при записи наблюдения в гистограмму клиент прикладывает к корзине trace-id одного из попавших в неё запросов. В формате OpenMetrics экземпляр записывается после знака #, как было показано выше. Prometheus хранит экземпляры при включённой функции --enable-feature=exemplar-storage в кольцевом буфере фиксированного размера, а Grafana рисует их точками поверх графика квантилей; щелчок по точке на всплеске p99 открывает трассу именно такого медленного запроса.
Второй переход — от трассы к журналу — требует, чтобы сервис записывал trace-id в каждую строку журнала. В notes-api строка выглядит так: level=error method=GET route=/api/notes code=500 duration_ms=100.5 trace_id=c10fe8b3542cb21a03b9c3f1ba7d40bb span_id=d473847eed27aff0 (запрос с внесённой ошибкой и дополнительной задержкой 100 мс). SDK OpenTelemetry для большинства языков умеет добавлять эти поля в стандартный журнал автоматически. В Loki trace-id хранится в структурированных метаданных, и запрос по нему находит все строки всех сервисов, участвовавших в запросе.
Третья связь — общие лейблы. Если метрики, журналы и трассы несут одинаково названные атрибуты ресурса (service, namespace, pod, route), переход «от всплеска ошибок у сервиса X к журналам сервиса X за те же 5 минут» выполняется одним щелчком. Семантические соглашения OpenTelemetry существуют именно для того, чтобы такие имена совпадали между командами и инструментами.
Ограничения и типичные ошибки интерпретации
Ошибки чтения метрик
Среднее значение задержки скрывает хвост распределения, а среднее квантилей не является квантилем. Корректная агрегация задержки по репликам — суммирование корзин гистограмм с последующим histogram_quantile; сводки по репликам не агрегируются вообще.
Оценка квантиля по гистограмме — именно оценка: её ошибка ограничена шириной корзины и в примере этой темы достигла 32 % для p99. Если квантиль попадает в корзину +Inf, возвращается граница предыдущей корзины, и рост реальной задержки с 3 до 30 с на графике не виден вовсе. Если же все запросы попадают в одну корзину, оценка определяется только её границами: при задержке около 170 мс и корзине от 100 до 250 мс оценка p95 составит 100 + 0,95 × 150 = 242,5 мс вне зависимости от реального распределения.
Отсутствие данных не равно нулю. Если цель перестала отвечать, её ряды при первом неудачном опросе помечаются устаревшими (англ. stale) и исчезают из мгновенных запросов; функции над окнами ещё вычисляются по старым точкам, пока те не выйдут из окна, а затем выражение для доли ошибок возвращает пустой результат, и алерт на него не срабатывает. Поэтому алерт по доле ошибок всегда дополняется алертом up == 0 или absent(). По той же причине при отсутствии трафика доля ошибок 0/0 даёт NaN, а любое сравнение с NaN ложно: SLO-алерт для сервиса без нагрузки молчит, и это нужно учитывать для редко вызываемых API.
Функция increase возвращает дробные значения из-за экстраполяции; rate с окном короче двух интервалов опроса возвращает пустоту; rate к измерителю даёт мусор. Наконец, изменение значения process_start_time_seconds означает перезапуск процесса: функции над счётчиками сброс обработают, но короткие перезапуски между опросами останутся невидимыми — их выдаёт рост kube_pod_container_status_restarts_total.
Ошибки проектирования телеметрии
Высококардинальный лейбл — самая частая и самая дорогая ошибка, одинаково вредная в Prometheus и Loki. Её признак — рост числа рядов или потоков вместе с числом пользователей, а не с числом сервисов. Идентификаторы место в журналах и трассах.
Метрики, вычисленные по сэмплированным трассам, искажены политикой сэмплирования; RED-метрики считаются по всем запросам. Журнал без trace-id и без структуры (key=value или JSON) нельзя связать с трассой и трудно разбирать запросами. Пробы Kubernetes (тема 7) и алерты отвечают на разные вопросы: проба живости решает, перезапускать ли контейнер, а алерт — нужен ли человек. Сервис, успешно отвечающий на /api/health и возвращающий 500 на каждый запрос к API, пробу проходит; поэтому SLI измеряется на пользовательских запросах, а не на служебном эндпоинте.
Алерт по причине («загрузка CPU 90 %») вместо алерта по симптому («пользователи получают ошибки») порождает поток уведомлений, на которые нельзя ничего сделать, и приучает дежурного их игнорировать 1. Причины полезны на дашборде для диагностики; вызов человека оправдан симптомом, угрожающим SLO.
Пределы инструментов
Локальная TSDB одного сервера Prometheus не реплицируется и рассчитана на хранение порядка недель. Отказоустойчивость достигается двумя одинаковыми серверами, опрашивающими одни и те же цели, с дедупликацией алертов в кластере Alertmanager; долговременное хранение и глобальные запросы — отправкой по remote write в системы вроде Thanos или Grafana Mimir, которые хранят блоки в объектном хранилище. Интервал опроса определяет разрешение: событие короче интервала между двумя опросами в счётчике видно, а в измерителе может не отразиться вовсе.
Loki дёшев на запись и дорог на чтение больших объёмов: запрос без узкого селектора за длительный период просматривает все чанки. Трассировка зависит от того, все ли участники цепочки передают traceparent: один сервис или прокси, теряющий заголовок, разрывает трассу на две. Длительности спанов с разных хостов сравниваются по их часам, и рассинхронизация часов делает дочерний спан «начавшимся раньше родителя».
Итоги темы и курса
Наблюдаемость отвечает на вопрос, который остаётся после того, как система построена: что в ней происходит и почему. Три сигнала различаются вопросом и ценой. Метрики дёшевы и не зависят от трафика, поэтому годятся для алертов и долгого хранения, но теряют подробности; журналы дают подробности ценой объёма; трассы показывают путь запроса и обычно сэмплируются. Prometheus собирает метрики опросом, что даёт естественный признак отказа цели up == 0 и контроль нагрузки на стороне сервера; Pushgateway и приём OTLP закрывают случаи, когда опрос невозможен.
Язык PromQL требует понимать природу данных: к счётчику применяется rate, обрабатывающая сбросы и экстраполирующая к границам окна; к измерителю — функции *_over_time, delta и deriv. Квантили задержки корректно агрегируются только через корзины гистограммы, и их точность определяется расположением границ корзин. Число рядов равно произведению кардинальностей лейблов, поэтому неограниченные идентификаторы не должны становиться лейблами ни в Prometheus, ни в Loki.
SLO переводит надёжность в число, а бюджет ошибок — в ресурс: при 99,9 % за 30 дней допустимо 43,2 мин недоступности. Многооконные алерты по скорости сжигания будят человека, когда за час израсходовано 2 % бюджета, и не будят из-за пятиминутного всплеска. Alertmanager превращает алерты в уведомления: группирует, маршрутизирует, подавляет следствия при активной причине и молчит во время плановых работ. OpenTelemetry стандартизирует сбор всех сигналов, протокол OTLP и распространение контекста по W3C Trace Context, а экземпляры и trace-id в журналах связывают сигналы в цепочку от графика к строке кода.
Тема завершает курс. Его логика шла от ресурсов к управлению ими: облачная модель и виртуализация (темы 1–2) объяснили, откуда берутся вычислительные ресурсы; контейнеры, образы и Compose (темы 3–6) — как упаковать и запустить приложение на одном хосте; Kubernetes (темы 7–8) — как поддерживать желаемое состояние в кластере; OpenTofu (тема 9) — как описать инфраструктуру кодом; хранилища (тема 10) — где живут данные; безопасность (тема 11) — кто и что может делать. Наблюдаемость замыкает цикл: декларативная система согласует желаемое и фактическое состояние, а наблюдаемость показывает, совпадает ли фактическое состояние с тем, что нужно пользователю. Курсовой проект собирает все темы на приложении «Заметки», и его последний этап — метрики, дашборд и SLO-алерт — применяет материал этой темы к системе, построенной за весь курс.
Литература
- Beyer B., Jones C., Petoff J., Murphy N. R. (eds.) Site Reliability Engineering: How Google Runs Production Systems. — O'Reilly, 2016. https://sre.google/sre-book/table-of-contents/
- Beyer B., Murphy N. R., Rensin D. K., Kawahara K., Thorne S. (eds.) The Site Reliability Workbook: Practical Ways to Implement SRE. — O'Reilly, 2018. Глава 5 «Alerting on SLOs». https://sre.google/workbook/alerting-on-slos/
- Majors C., Fong-Jones L., Miranda G. Observability Engineering: Achieving Production Excellence. — O'Reilly, 2022.
- Turnbull J. Monitoring with Prometheus. — Turnbull Press, 2018.
- Prometheus Documentation. Exposition formats; Metric types; Metric and label naming. — https://prometheus.io/docs/instrumenting/exposition_formats/ (дата обращения: 22.10.2026).
- Prometheus Documentation. Querying: basics; Query functions. — https://prometheus.io/docs/prometheus/latest/querying/functions/ (дата обращения: 22.10.2026).
- Prometheus Documentation. Histograms and summaries. — https://prometheus.io/docs/practices/histograms/ (дата обращения: 22.10.2026).
- Prometheus Documentation. Alerting rules; Alertmanager. — https://prometheus.io/docs/alerting/latest/alertmanager/ (дата обращения: 22.10.2026).
- Prometheus Documentation. When to use the Pushgateway. — https://prometheus.io/docs/practices/pushing/ (дата обращения: 22.10.2026).
- Kanzhelev S., McLean M., Reitbauer A., Drutu B., Molnar N., Shkuro Y. Trace Context. — W3C Recommendation, 23 November 2021. https://www.w3.org/TR/trace-context/
- OpenTelemetry Documentation. Signals; Collector; Sampling. — https://opentelemetry.io/docs/ (дата обращения: 22.10.2026).
- Grafana Loki Documentation. — https://grafana.com/docs/loki/latest/ (дата обращения: 22.10.2026).
- Sigelman B. H., Barroso L. A., Burrows M., Stephenson P., Plakal M., Beaver D., Jaspan S., Shanbhag C. Dapper, a Large-Scale Distributed Systems Tracing Infrastructure. — Google Technical Report dapper-2010-1, 2010.
- Gregg B. Thinking Methodically about Performance. — Communications of the ACM, 2013, vol. 56, no. 2, P. 45–51, DOI: 10.1145/2408776.2408791.